Créer un Agent BigQuery avec Google ADK
Créer un Agent BigQuery avec Google ADK
Mon objectif est de déployer un agent sur GCP en utilisant le SDK ADK. Le framework offre de nombreuses capacités intéressantes, et je voulais les comprendre et les tester par moi-même.
Un agent est un assistant conversationnel basé sur un LLM, capable de réaliser des actions, principalement via des outils et d'autres assistants comme une couche d'orchestration. Sur un agent, nous pouvons configurer des outils MCP et des compétences (skills) dédiées, et c'est ce que le SDK Google ADK facilite aujourd'hui.
De plus, ADK fournit un modèle d'instructions clair, facile à prendre en main et à concevoir. Il expose la configuration du modèle et même ses paramètres, ce qui en fait un framework flexible pouvant définir presque n'importe quel comportement d'agent.
La méthode que je connaissais déjà pour provisionner un agent consistait à utiliser des conteneurs à usage général sur Cloud Run. Cloud Run est géré, mais il nécessite de configurer l'infrastructure sous-jacente, la gestion de session et la persistance pour l'historique des discussions, ainsi que la persistance de la mémoire pour le RAG ou la mémoire à long contexte. J'en parlerai plus en détail dans les prochains articles.
L'offre d'agents de Vertex AI est désormais la plateforme Gemini Enterprise Agent. Elle fournit un environnement d'exécution d'agent dédié qui gère déjà les fonctionnalités spécifiques aux agents, avec un large éventail de capacités pour prendre en charge le déploiement et le développement, et elle est entièrement compatible avec ADK.
Dans cet article, je présenterai un agent de démonstration construit avec ADK. Les capacités de l'agent ne sont pas le sujet ici, mais j'utiliserai un petit assistant de données BigQuery pour prouver la plupart d'entre elles. L'article se concentre sur l'utilisation du framework ADK avec du code Python. Le déploiement de cet agent avec agents-cli sur les deux backends, Cloud Run et l'environnement d'exécution d'Agent Platform, sera abordé dans le prochain article.
Le SDK ADK
ADK signifie Agent Development Kit, et comme son nom l'indique, c'est un ensemble d'outils d'assistance pour construire rapidement des agents avec un support complet de déploiement sur GCP.
Le framework peut être utilisé avec plusieurs langages : Python, Java et Go. Je suis plus à l'aise avec Python, j'ai donc choisi de construire mon agent avec le SDK Python ADK.
Je me suis principalement concentré sur deux composants dans le code : Agent et Runner. Le runner est principalement implicite dans cet exemple. Il orchestre l'agent et ses actions, constituant ainsi la couche d'orchestration du framework.
Agent définit la configuration et les instructions de l'agent à créer :
name: le nom de l'agent.model: le nom du modèle.instruction: la définition initiale des instructions. Elle prend en charge les variables d'environnement et même les espaces réservés (placeholders) optionnels comme{opt_var?}.tools: les outils à disposition du modèle. Cela accepte les outils MCP, les outils de compétences (skills), et même d'autres agents, ce qui permet des appels dédiés à des sous-agents.output_schema: fixe la sortie à un schéma défini, afin que les clients utilisant l'agent sachent exactement à quoi s'attendre.generate_content_config: configuration avancée du modèle couvrant la température, le nombre maximal de tokens en sortie, et plusieurs autres options. Dans cet exemple, les paramètres sont ajustés pour l'objectif de l'agent : une température déterministe, des tokens limités et des valeurs de cache adaptées.
D'autres propriétés utiles :
description: la description de l'agent.input_schema: commeoutput_schema, il limite, surveille et rejette les entrées qui ne correspondent pas au schéma.include_contents: activé par défaut, il permet à l'agent d'accéder à l'historique de conversation de la session, ce qui permet au modèle de conserver le contexte des tours précédents.
Définition de l'Agent
Toute cette configuration aide à créer un agent capable pour des charges de travail d'entrée élevées ou de légères interactions, selon son but. Le framework donne un point d'entrée de configuration unique pour l'agent. Et parce que la configuration vit dans un langage de programmation plutôt que dans un fichier de configuration, plusieurs comportements peuvent être personnalisés ou programmés directement.
Configuration des outils
ADK prend en charge les outils personnalisés directement sur l'agent. L'ajout d'une fonction Python native à la liste d'outils de l'agent est suffisant. Par exemple, je peux passer cette fonction directement :
Outil personnalisé
La plateforme d'Agent (Agent Platform) offre également un ensemble de serveurs MCP gérés et prend entièrement en charge ADK, de sorte qu'un agent peut extraire directement les serveurs MCP gérés.
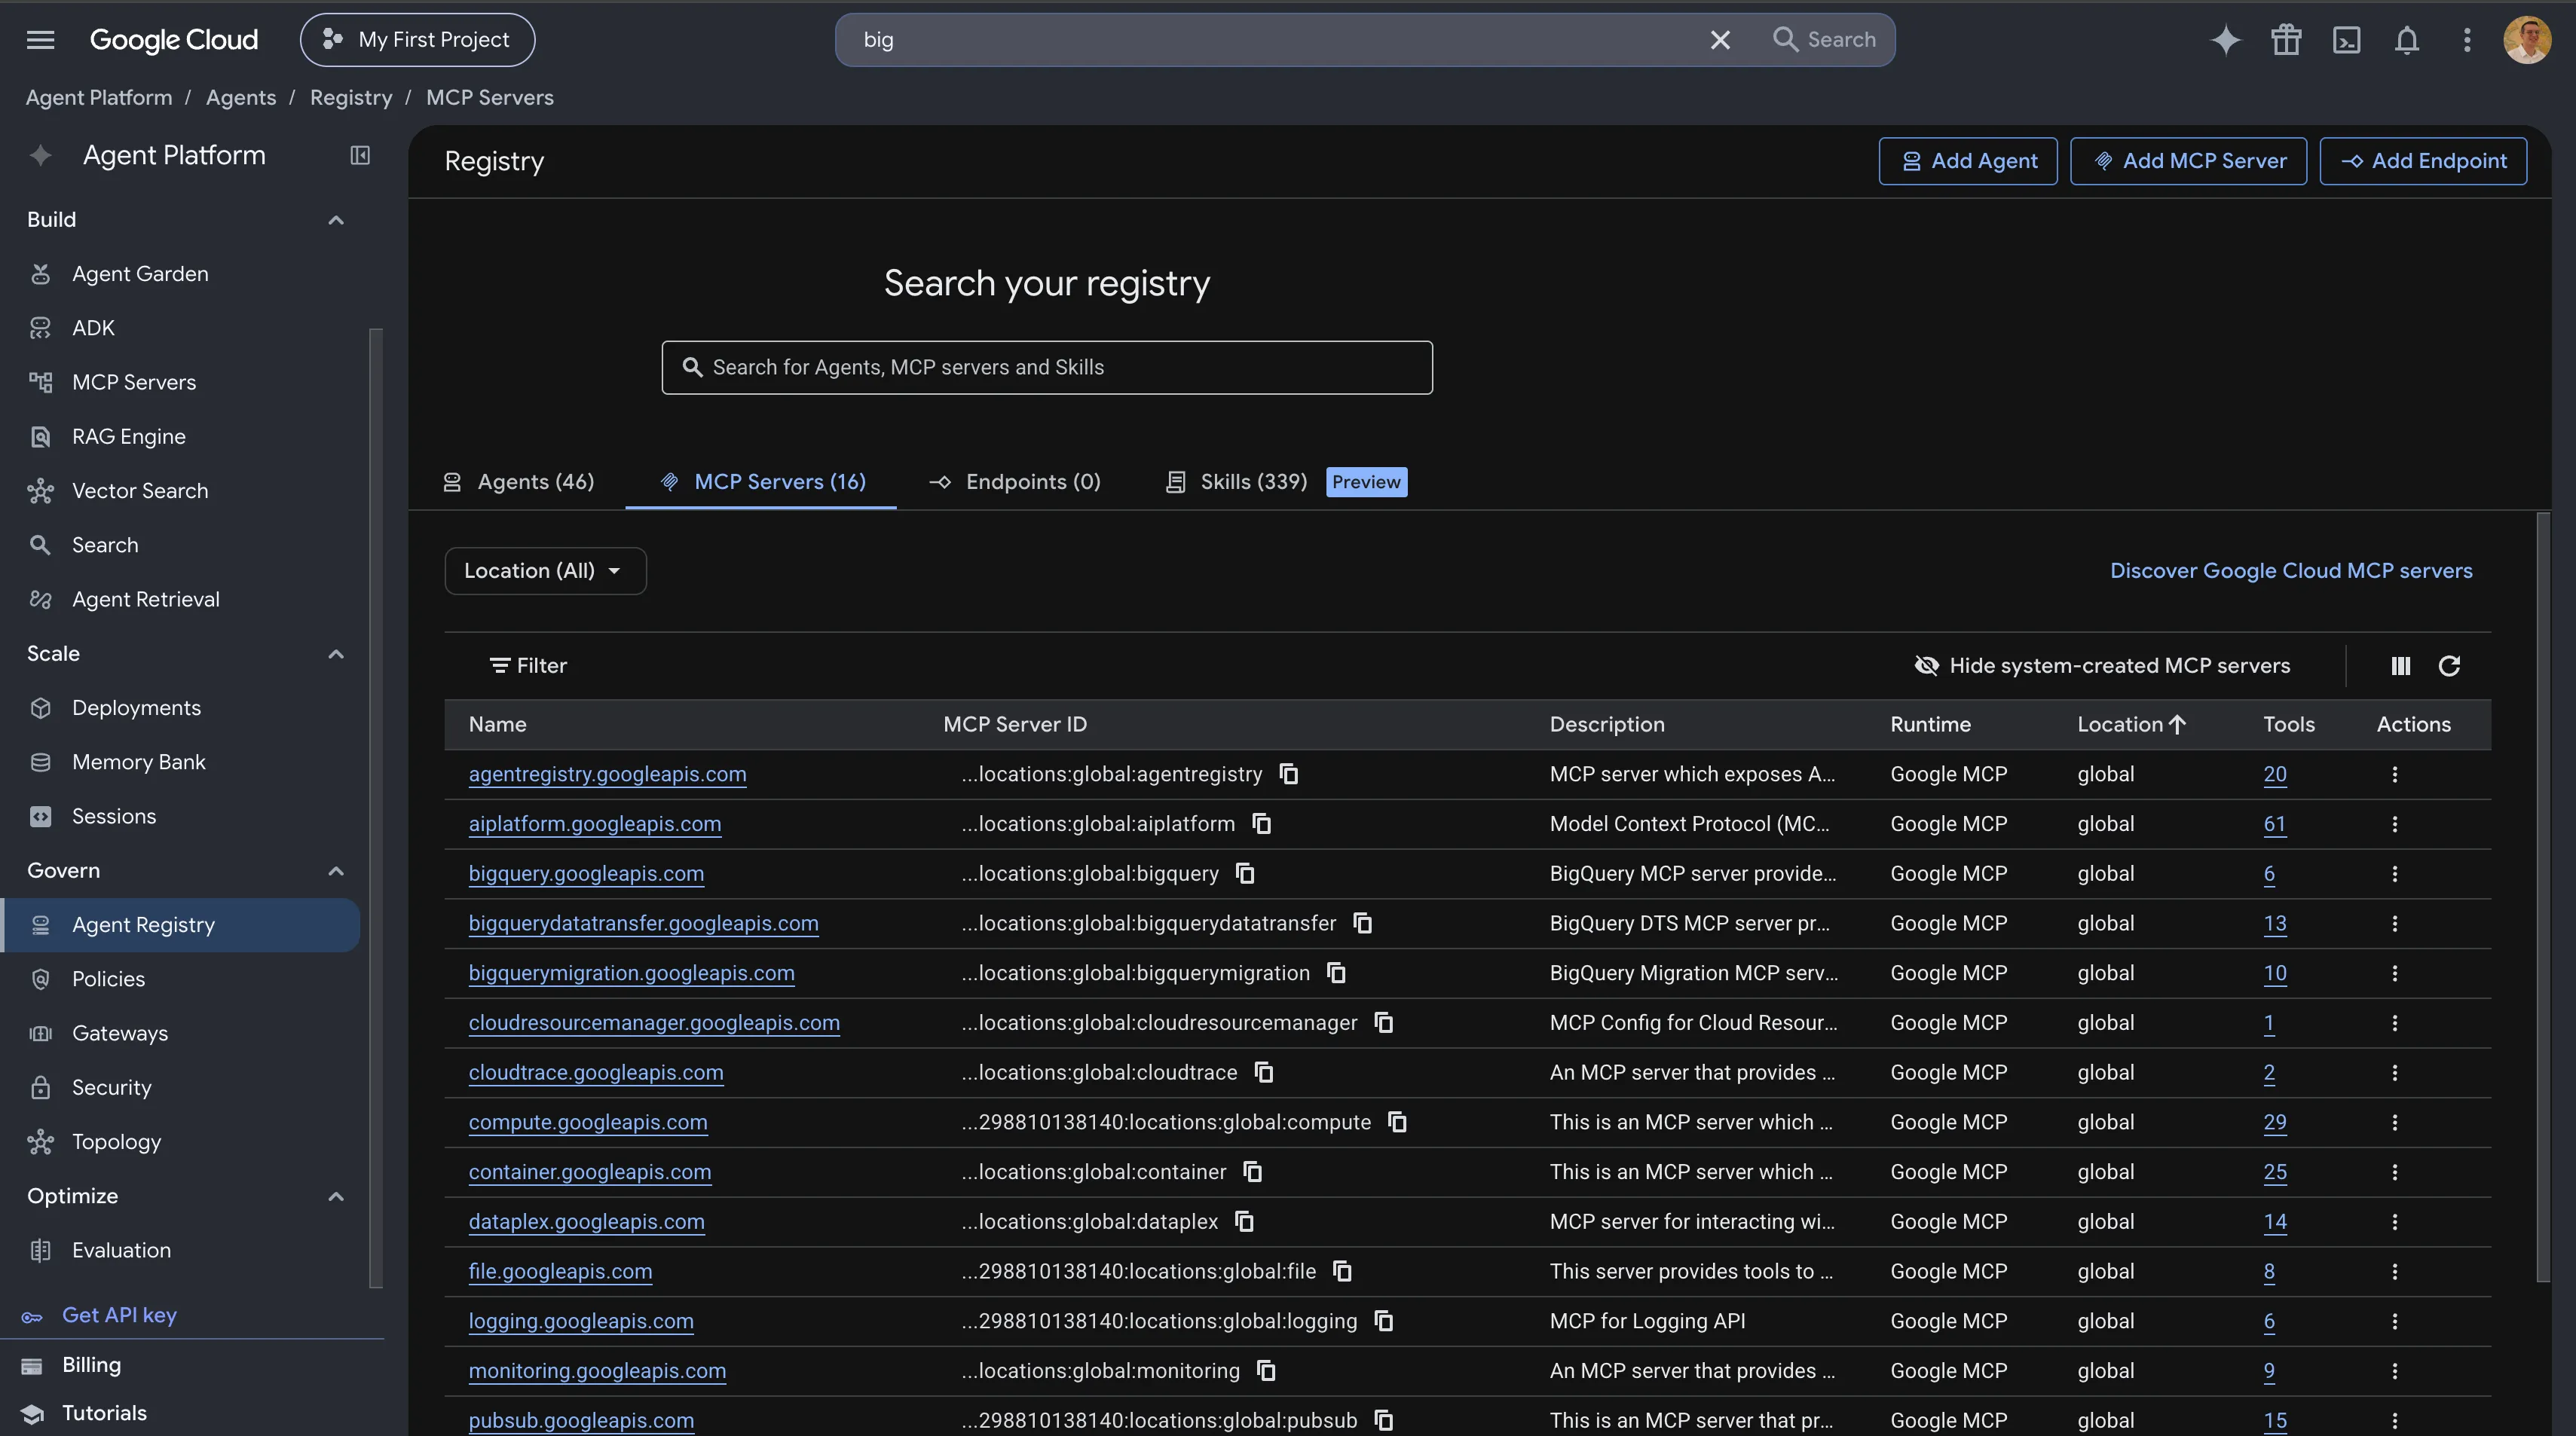
J'avais 16 serveurs MCP gérés disponibles par défaut pour enrichir mon agent. Comme ce sera un assistant BigQuery, l'ajout du serveur MCP BigQuery prend tout son sens : il donne à l'agent un accès direct aux outils pour explorer et interroger BigQuery, créés et gérés par Google Cloud.
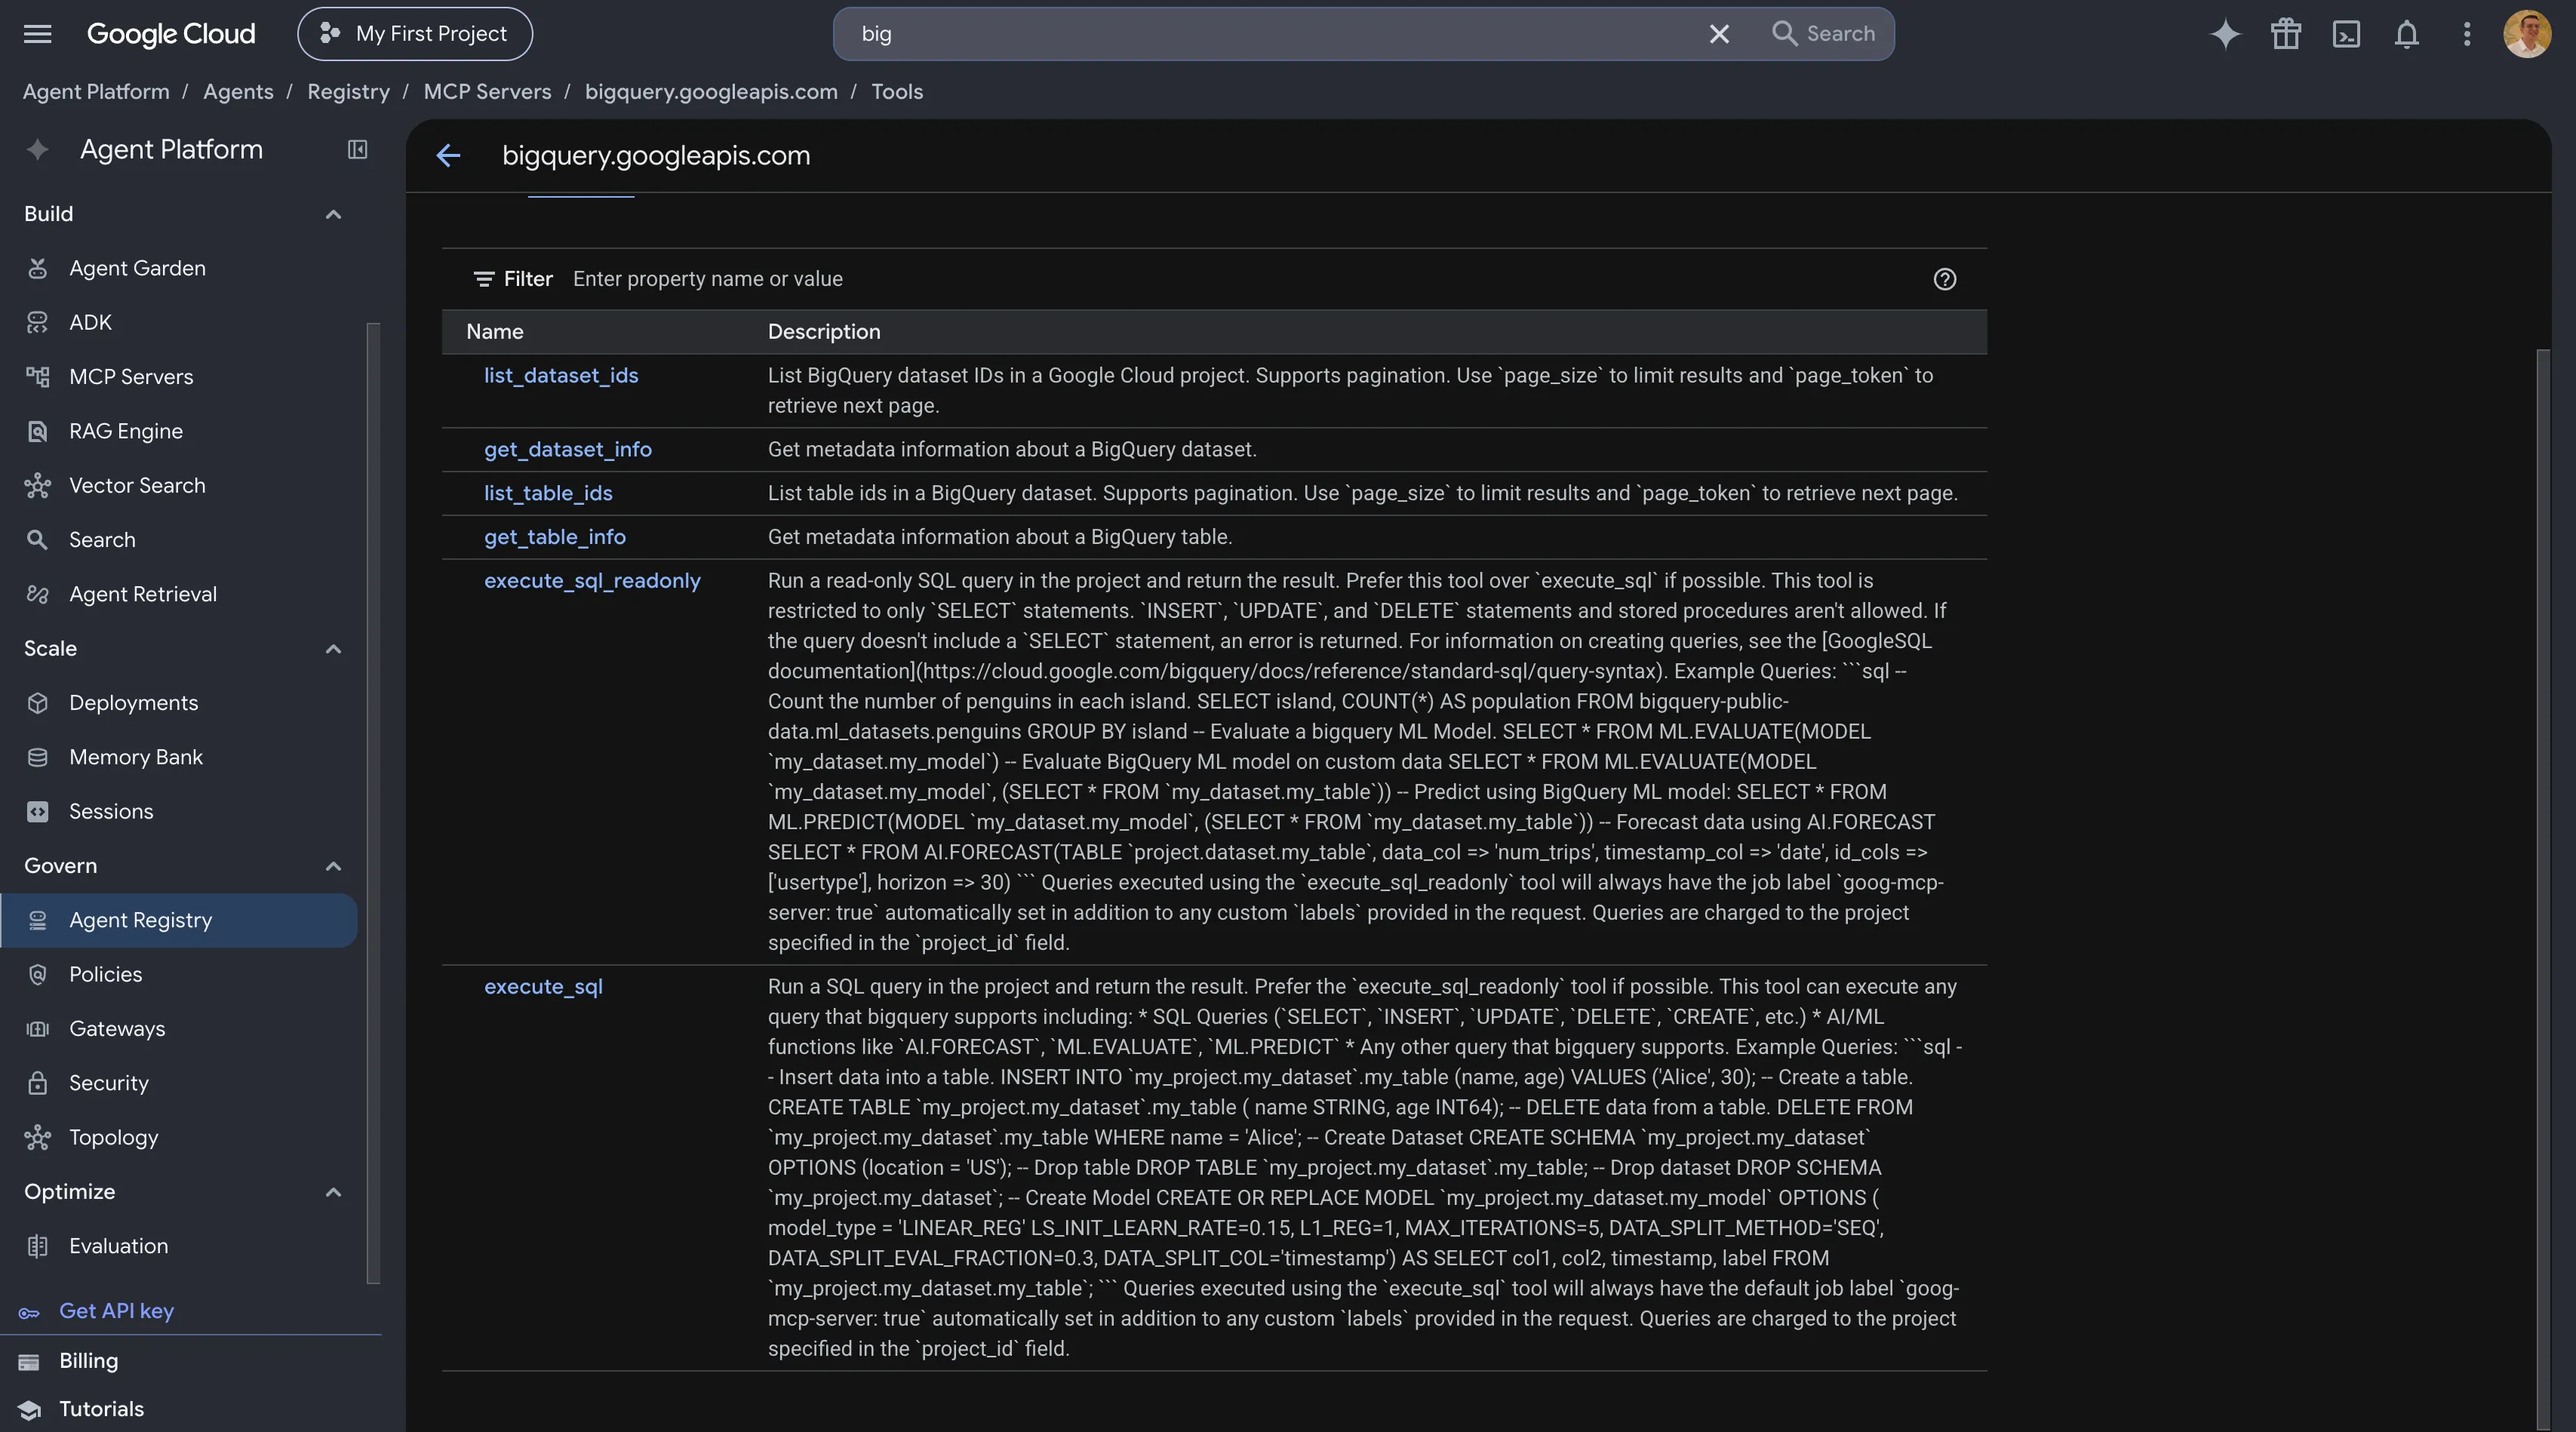
Comme vous pouvez le voir dans la figure ci-dessus, il offre l'exécution de requêtes en lecture seule et l'exécution de requêtes standard, ainsi que des fonctions de lecture pour explorer les ressources et identifiants nécessaires.
Ainsi, au lieu d'écrire moi-même l'ensemble complet d'outils, je peux utiliser directement ce serveur MCP géré et l'intégrer à ADK :
Intégration du MCP BigQuery géré
La configuration MCP est simple, mais ce serveur MCP appelle l'API BigQuery, il doit donc être authentifié. Intuitivement, je pensais qu'il s'authentifierait automatiquement une fois que j'aurais attaché un compte de service à l'agent, mais ce n'est pas le cas : chaque appel au serveur MCP géré nécessite son propre jeton porteur (bearer token). J'ai opté pour des identifiants restreints à la portée (scope) BigQuery, avec un en-tête pour l'attribution de la facturation et un jeton rafraîchi à chaque appel. Cela évite l'expiration du jeton après une heure et maintient l'agent fonctionnel pendant les longues sessions.
Avec ces composants, bq_mcp est initialisé et passé directement à la liste des outils de l'agent.
Compétences (Skills)
Un agent construit avec ADK peut également prendre des compétences en entrée. Les compétences sont injectées via un outil dédié appelé SkillToolset, qui regroupe les compétences en entrée et donne à l'agent les fonctions pour les lire.
Je peux charger des compétences personnalisées que j'ai déjà écrites à l'aide d'une fonction d'aide d'ADK :
Charger un skill personnalisé
Je peux aussi utiliser des compétences gérées, qui sont découvrables sur l'Agent Platform dans le registre d'agents.
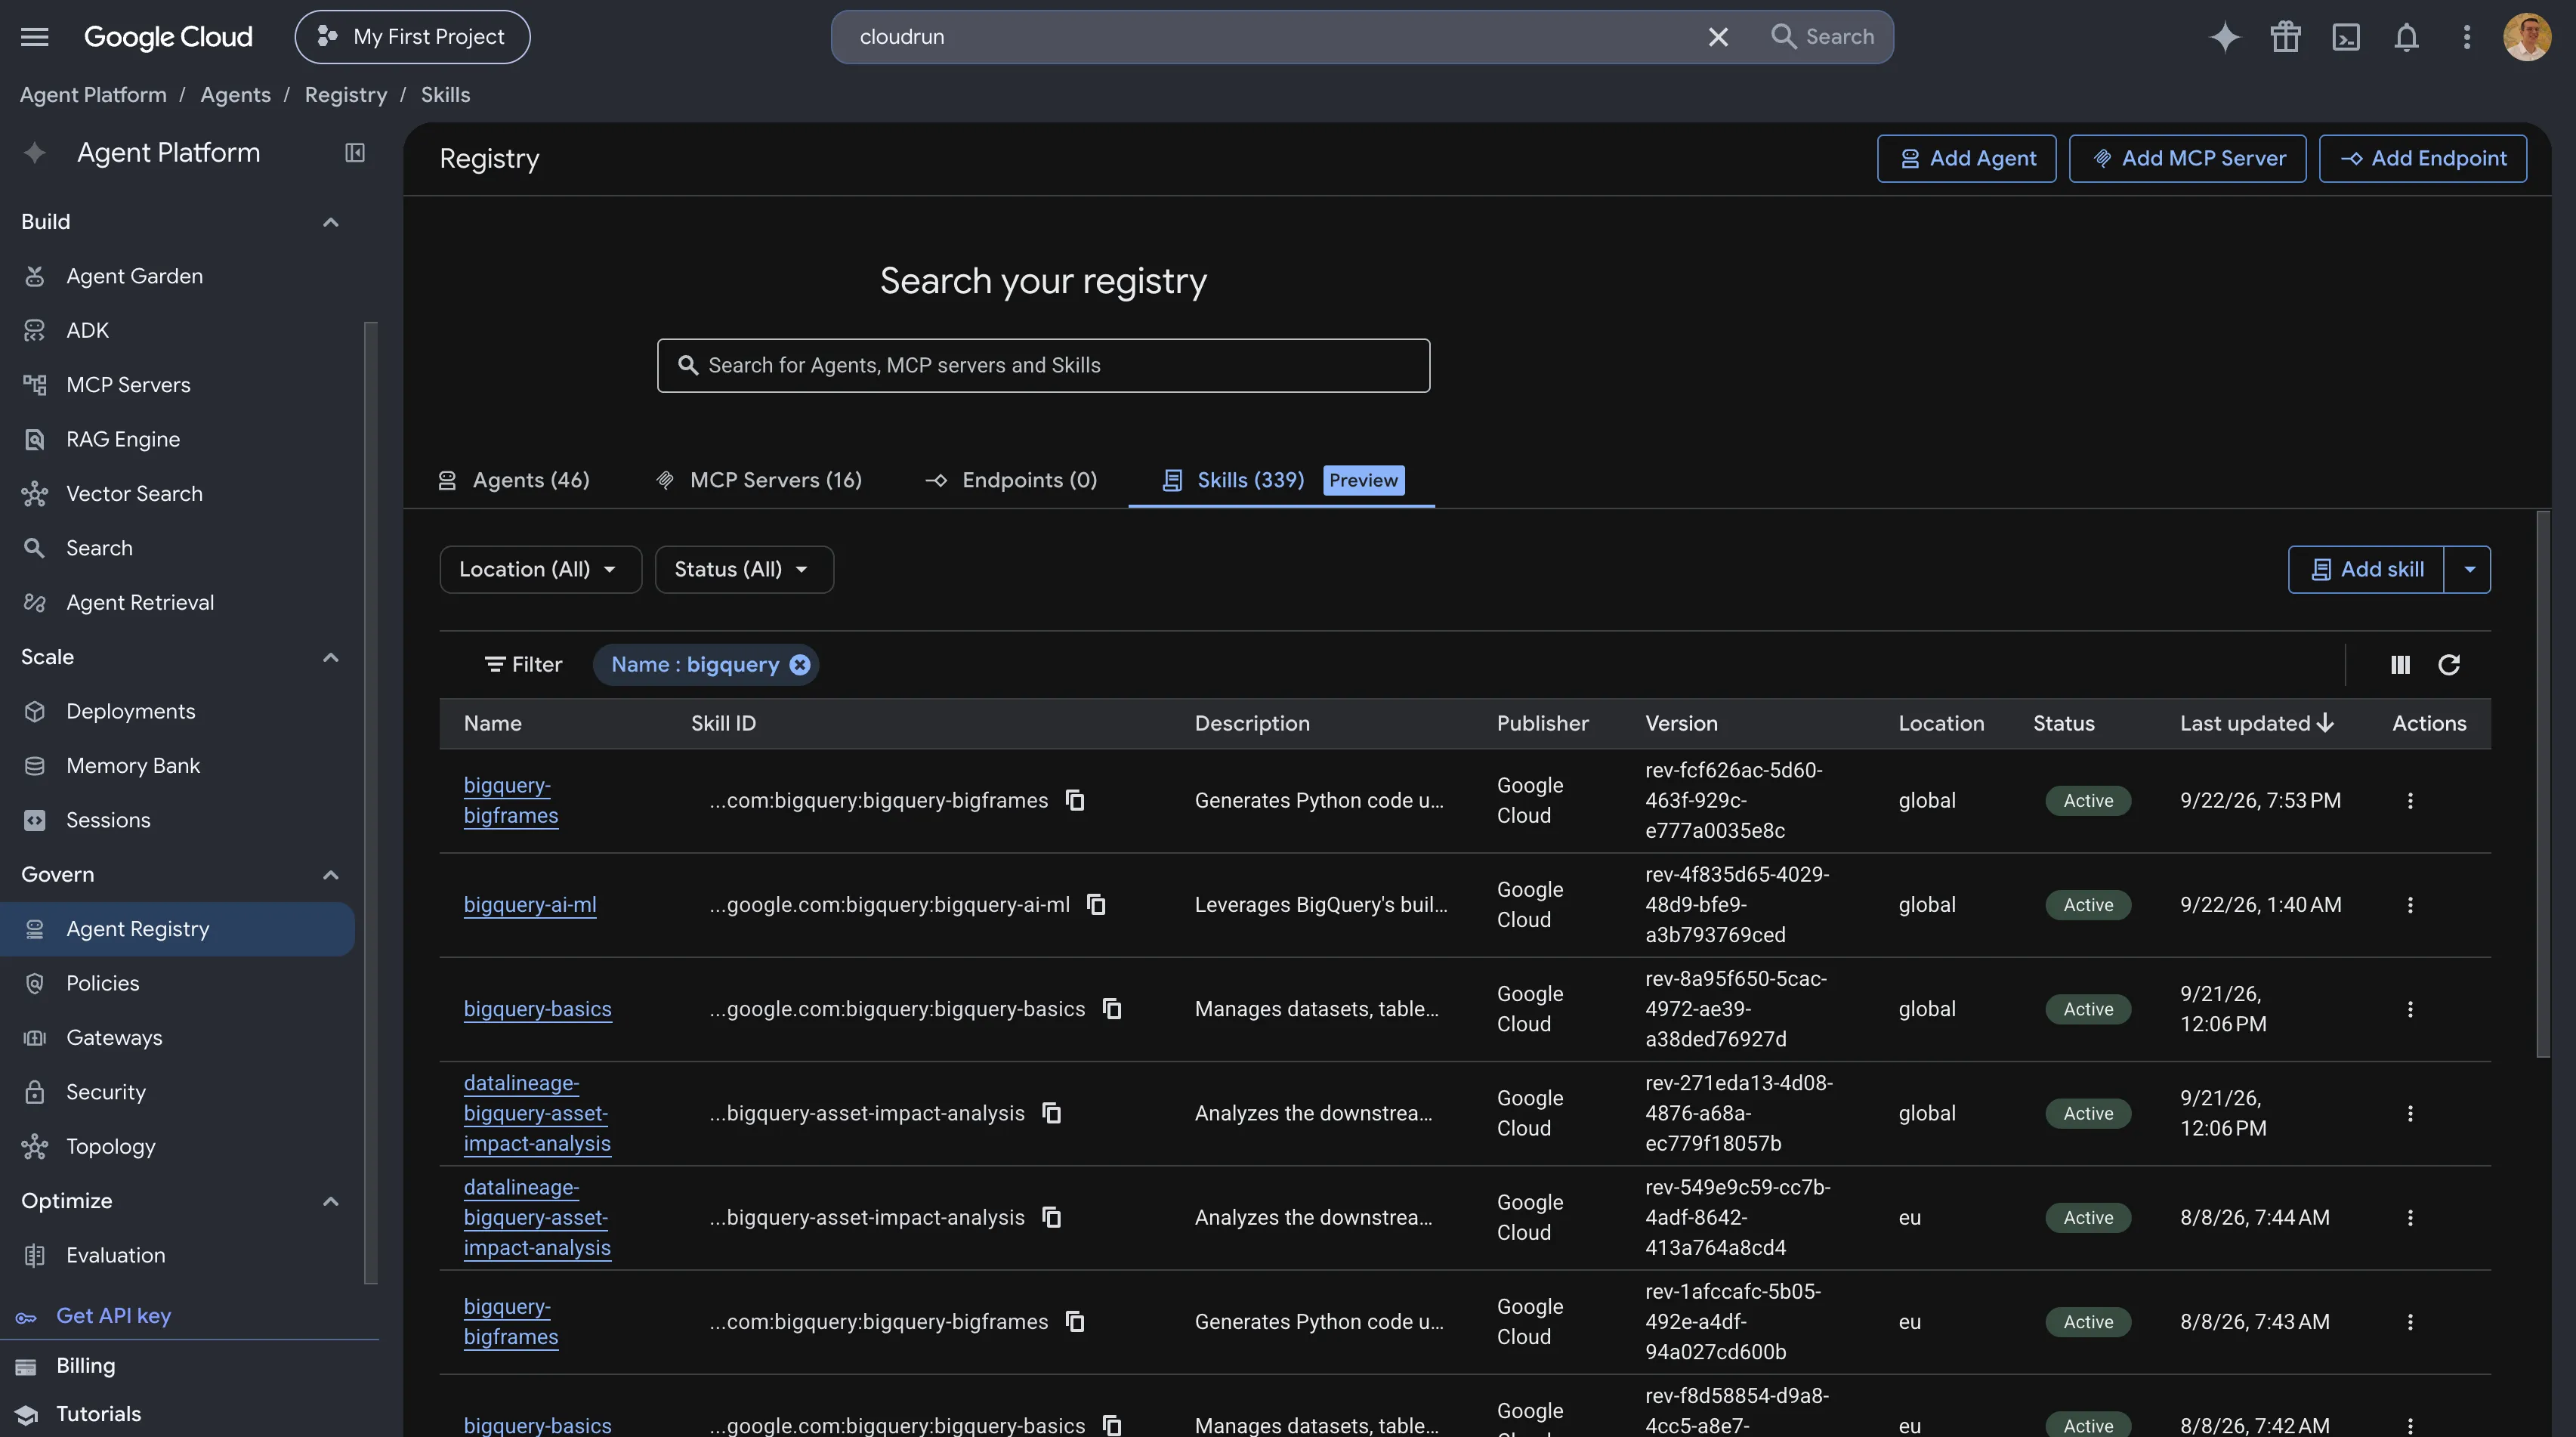
De nombreuses compétences y sont disponibles, organisées par région. Comme je construis un assistant BigQuery, je peux choisir la compétence bigquery-basics, pour que l'agent obtienne les assistants gérés par Google et les instructions pour interroger BigQuery via MCP. ADK fournit GCPSkillRegistry pour cela : avec un ID de projet et un emplacement de compétence, cela donne accès à l'ensemble du registre de compétences, et je peux définir plus tard quelles compétences l'agent doit utiliser.
Registre des skills gérés
Toutes les compétences doivent être regroupées dans un SkillToolset, ce qui permet à l'agent de les lire et de les utiliser via ses fonctions exposées :
SkillToolset
L'exemple ci-dessus montre l'outil regroupant à la fois la compétence personnalisée et le registre de compétences Google Cloud.
L'architecture complète de l'agent peut se résumer ainsi :
Instructions de l'agent
Un agent est un assistant de chat LLM à la base. Il ne peut pas être programmé, mais il peut être instruit sur ce qu'il doit faire et comment le faire. Les instructions sont cruciales : la meilleure pratique est de définir le but et le thème de l'agent, les meilleures façons d'effectuer des actions, et quelles compétences et serveurs MCP utiliser. Les instructions étant rédigées en langage naturel, l'ensemble des pré-instructions possibles est pratiquement infini.
Instructions de l'agent
Dans l'exemple ci-dessus, vous pouvez voir la définition de l'objectif de l'agent, le serveur MCP à utiliser, et les compétences à suivre. Notez que la liste d'outils mélange un outil de fonction personnalisé, la boîte à outils de compétences et le serveur MCP géré.
Test local
Une fois l'agent développé, il peut être testé localement avant d'être poussé vers les backends GCP. L'interface en ligne de commande (CLI) ADK offre plusieurs commandes de test. Elle peut exécuter l'agent dans le terminal, exposer son API appelable localement pour validation, ou démarrer une version web pour discuter avec l'agent et tester son comportement :
adk run: exécute l'agent localement dans le terminal.adk api_server: expose l'API HTTP de l'agent localement.adk web: lance une interface web pour l'agent pour des tests interactifs.
Pour lancer un chat interactif sur ma CLI locale, j'ai utilisé les commandes suivantes :
Exécuter l'agent localement
Je peux également tester un prompt directement en l'envoyant (via un pipe) à l'agent interactif :
Test local unique (One-shot)
GOOGLE_GENAI_USE_VERTEXAI doit être défini sur true. Sans cela, le client modèle se connecte par défaut à AI Studio et échoue avec une erreur de clé API. Le code lui-même s'exécute localement, mais le modèle, les outils MCP gérés et les compétences sont tous utilisés à distance via les informations d'identification locales de l'utilisateur, qui sont compatibles avec l'identité que l'agent utilisera une fois hébergé.
Déploiement
ADK offre un large éventail de fonctionnalités qui rendent la conception d'agents hautement personnalisable, et le déploiement est tout aussi personnalisable. En son cœur, ADK est livré avec une commande qui peut provisionner l'agent directement sur la plateforme Agent.
Les agents ADK peuvent également être provisionnés sur Cloud Run. William Denniss chez Google a publié une réflexion très intéressante sur la façon de choisir entre les deux backends, et cela mérite d'être approfondi en soi : article.
Les différences entre les deux méthodes sont significatives :
Agent Runtime (agent_runtime) | Cloud Run (cloud_run) | |
|---|---|---|
| Apparait dans Agent Platform > Deployments | ✅ oui | ❌ jamais |
| Sessions et historique gérés | ✅ automatique | ⚠️ en mémoire par défaut, gestion sur activation (opt-in) |
| Publication Gemini Enterprise | ✅ natif, une seule commande | ⚠️ A2A seulement, plus de configuration, Preview |
| Propriété de l'infrastructure | ❌ Gérée par Google | ✅ Auto-gérée |
La méthode Cloud Run donne une liberté totale sur l'écosystème de l'agent : sessions, RAG, mémoire à long terme, et tout ce qui l'entoure. L'environnement d'exécution Agent Platform fournit un environnement d'agent géré, avec une prise en charge des sessions par défaut et un accès immédiat à des banques de mémoire pour la mémoire à long terme.
Dans le prochain article, j'explorerai les différentes méthodes de déploiement pour cet agent ADK à l'aide d'un autre outil appelé agents-cli, de manière unifiée sur plusieurs cibles.
Explorer ADK m'a rappelé le cycle de développement du calcul géré conteneurisé comme Cloud Functions ou AWS Lambda, mais il est livré avec l'IA en plus : outils gérés, outils personnalisés et orchestration, tous instruits ensemble en langage naturel. Le résultat est de puissants agents pour un usage personnel ou en entreprise.