Évaluer les agents ADK
Évaluer les agents ADK
Dans mon article précédent, j'ai construit un assistant de données BigQuery avec Google ADK et je l'ai testé localement dans le terminal. Cet agent est désormais sur GitHub sous le nom agent-on-gcp. Cet article en est la continuité : comment j'ai évalué le comportement de l'agent avant de lui faire confiance en production, ce que les exécutions d'évaluation ont découvert, et ce que j'ai dû corriger.
Développer un agent avec ADK ressemble beaucoup au développement de conteneurs serverless. Les outils simplifient le travail, et le code est testable avec des tests unitaires, voire des tests d'intégration si nécessaire. Mais ces tests ne suffisent pas. Un test unitaire répond parfaitement lorsque le chemin est déterministe. Un agent ne l'est pas : il utilise les capacités d'un LLM pour décider quoi faire à chaque étape. Pour répondre précisément à ce comportement, ADK intègre des fonctionnalités d'évaluation.
Tester le comportement d'un agent est crucial avant de le déployer en production. Cela permet de délimiter et de prédire les résultats de l'agent, ce qui touche directement trois points d'architecture : le budget, la sécurité et la fidélité sémantique aux résultats attendus.
Les sorties des LLM ne sont pas déterministes et peuvent halluciner, ce qui a un impact sur les actions de l'agent. Deux exécutions du même test et du même scénario peuvent différer. Les tests comportementaux ne sont donc pas une activité ponctuelle. Ils s'exécutent par cycles et se mesurent sur des résultats moyens. Calibrer le comportement signifie atteindre les métriques que je souhaite, et non respecter des assertions strictes. Les erreurs sont inévables, donc la vraie question est de savoir combien d'erreurs je suis prêt à tolérer, et non comment toutes les éliminer.
Évaluation
Même avec une température basse, mon petit bq_agent fera des erreurs ou des bugs dans ses réponses, l'utilisation de ses compétences et l'utilisation des outils. Des tests basés sur des assertions seraient intermittents par conception. Au lieu de cela, l'évaluation ADK fonctionne avec des critères qui portent des taux d'erreur tolérés par cas.
ADK propose un catalogue de critères (voir la documentation officielle). Pour cet agent, j'ai utilisé les suivants :
Critères à un seul tour (Single-turn) :
tool_trajectory_avg_score: compare les outils que l'agent a appelés avec ceux attendus, dans l'ordre (j'utilise le type IN_ORDER : les appels attendus doivent apparaître dans l'ordre, mais des appels supplémentaires entre eux sont acceptés ; le type par défaut, plus strict, est EXACT). Déterministe, aucun modèle juge n'est impliqué.final_response_match_v2: un modèle juge évalue à quel point la réponse finale est proche d'une réponse de référence.rubric_based_tool_use_quality_v1: un juge vérifie des règles écrites sur l'utilisation des outils, par exemple "chaque SELECT doit inclure un LIMIT d'au plus 1000".rubric_based_final_response_quality_v1: même idée, mais sur la réponse finale, par exemple "la réponse doit être un JSON valide correspondant au schéma de sortie".hallucinations_v1: un juge divise la réponse en phrases et vérifie chacune par rapport aux sorties réelles des outils.
Critère multi-tours (Multi-turn) :
rubric_based_multi_turn_trajectory_quality_v1: un juge note une conversation simulée complète par rapport à des rubriques, par exemple "l'agent a résolu les questions de suivi à partir du contexte sans redemander".
Une limitation honnête : le critère de sécurité et les métriques multi-tours dédiées sont restés en dehors de mes exécutions. Dans ADK 2.10, ils passent par une façade d'évaluation Vertex qui est incompatible avec l'actuel SDK google-cloud-aiplatform 2.x, ils ne peuvent donc jamais produire de score sur ma chaîne d'outils. Les détails sont documentés dans le rapport d'évaluation du dépôt.
En plus de cela, ADK rapporte toujours gratuitement des métriques d'efficacité à chaque exécution : tool_call_count_v1, inference_call_count_v1, token_usage_v1 et invocation_duration_v1. Elles ne font jamais échouer une exécution, elles ne font qu'informer. C'est de là que viennent les tokens consommés, et ils se sont avérés être la donnée la plus intéressante de tout cet exercice.
Ainsi, un agent peut être testé sur son parcours : a-t-il utilisé l'artefact attendu, un outil ou une compétence, et a-t-il appliqué les instructions requises ? Et il peut être jugé sur ses réponses par un modèle IA juge, sur des conversations à un ou plusieurs tours.
L'utilisation des modèles n'est pas gratuite, et les tests utilisent les modèles deux fois : une fois pour l'agent, une fois pour les juges. Une bonne stratégie de test est nécessaire, adaptée au cas d'usage et à la phase du projet. Les tests prennent également du temps à s'exécuter. Pour cet agent, les tests de parcours et les tests à un seul tour sont suffisants pour une validation fréquente, avec des exécutions multi-tours occasionnelles lorsqu'une fonctionnalité importante est intégrée.
Pour rappel, l'agent de l'article précédent utilise un outil personnalisé pour la date (get_current_utc_date), le serveur MCP géré officiel de Google Cloud pour BigQuery, et un SkillToolset qui regroupe une compétence de directives SQL personnalisée et la compétence gérée bigquery-basics. C'est un assistant qui accède aux ensembles de données BigQuery et peut demander l'exécution de requêtes. Depuis le dernier article, il est également passé de gemini-2.5-flash à gemini-3.8-flash, et l'identifiant du modèle est désormais configurable via une variable d'environnement. L'évaluation cible exactement ces comportements : l'utilisation de ces outils sur les tests de parcours, et leur comportement lors de conversations à un et plusieurs tours.
Pour le multi-tours, ADK propose des scénarios et des personas. Un scénario décrit un prompt de départ et un plan de conversation, et un simulateur d'utilisateur (un autre LLM) joue l'utilisateur en suivant ce plan. Le persona est choisi dans un registre : NOVICE, EXPERT ou EVALUATOR. Voici l'un de mes scénarios, où l'utilisateur pose une question de suivi qui n'a de sens qu'avec le contexte :
Scénario multi-tours
Les fichiers complets sont sur le dépôt : evalset scénario, evalset à un tour, et la configuration des critères. Un deuxième scénario plus long, où un utilisateur novice révèle les paramètres un par un, est conservé pour les exécutions manuelles.
Exécutions et découvertes
ADK exécute l'évaluation localement : le code s'exécute sur ma machine, l'agent appelle les vrais modèles Gemini sur Vertex AI, et les critères de jugement appellent un modèle juge. Pour jouer avec les tests sur mon dépôt, l'installation nécessite des identifiants GCP locaux, les dépendances synchronisées, et trois variables d'environnement :
Installation
Les exécutions sont pilotées par pytest, conditionnées par une variable d'environnement pour que les exécutions de tests normales restent hors ligne et gratuites :
Exécuter les niveaux d'évaluation
Les mêmes exécutions existent directement sur la CLI ADK, ce qui est également la façon dont la suite de scénarios manuels plus longs est exécutée :
Équivalents CLI ADK
Chaque exécution archive ses scores détaillés sous forme de fichier horodaté dans tests/evals/baselines/, afin que les exécutions puissent être comparées au fil du temps.
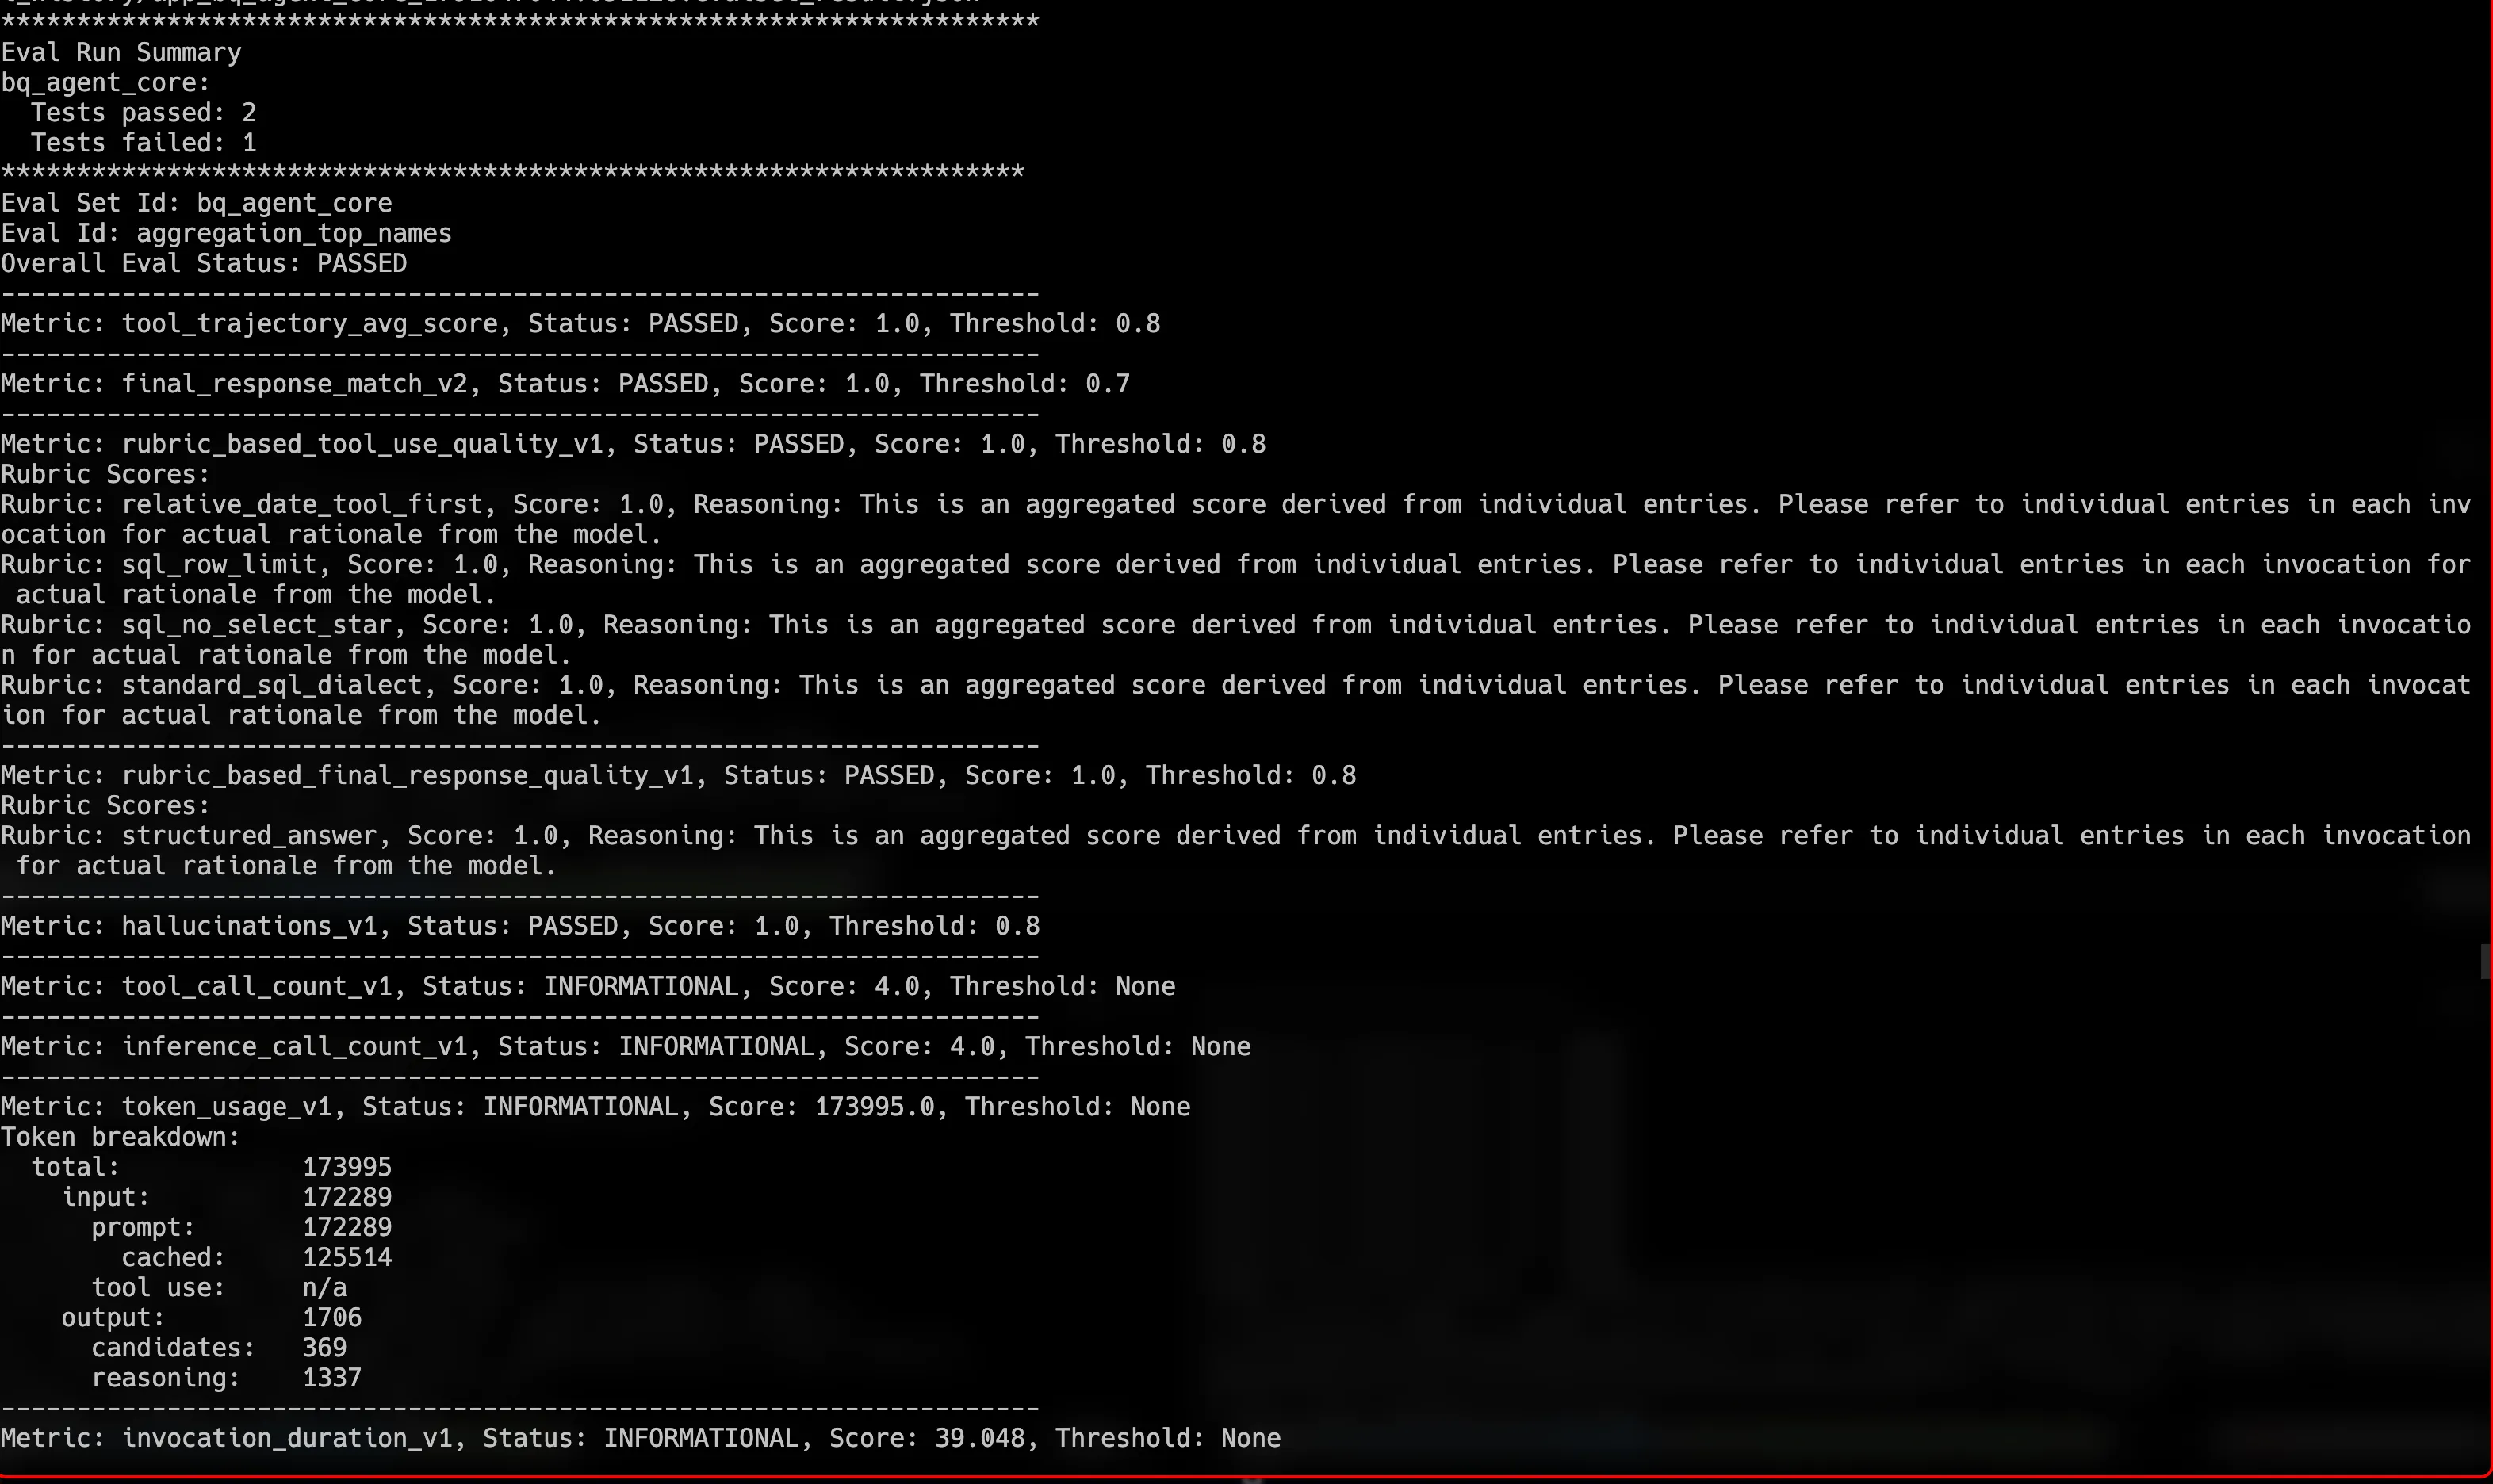
exemple d'une évaluation de métrique réussie (la même exécution comportait un cas en échec, présenté ci-après) :
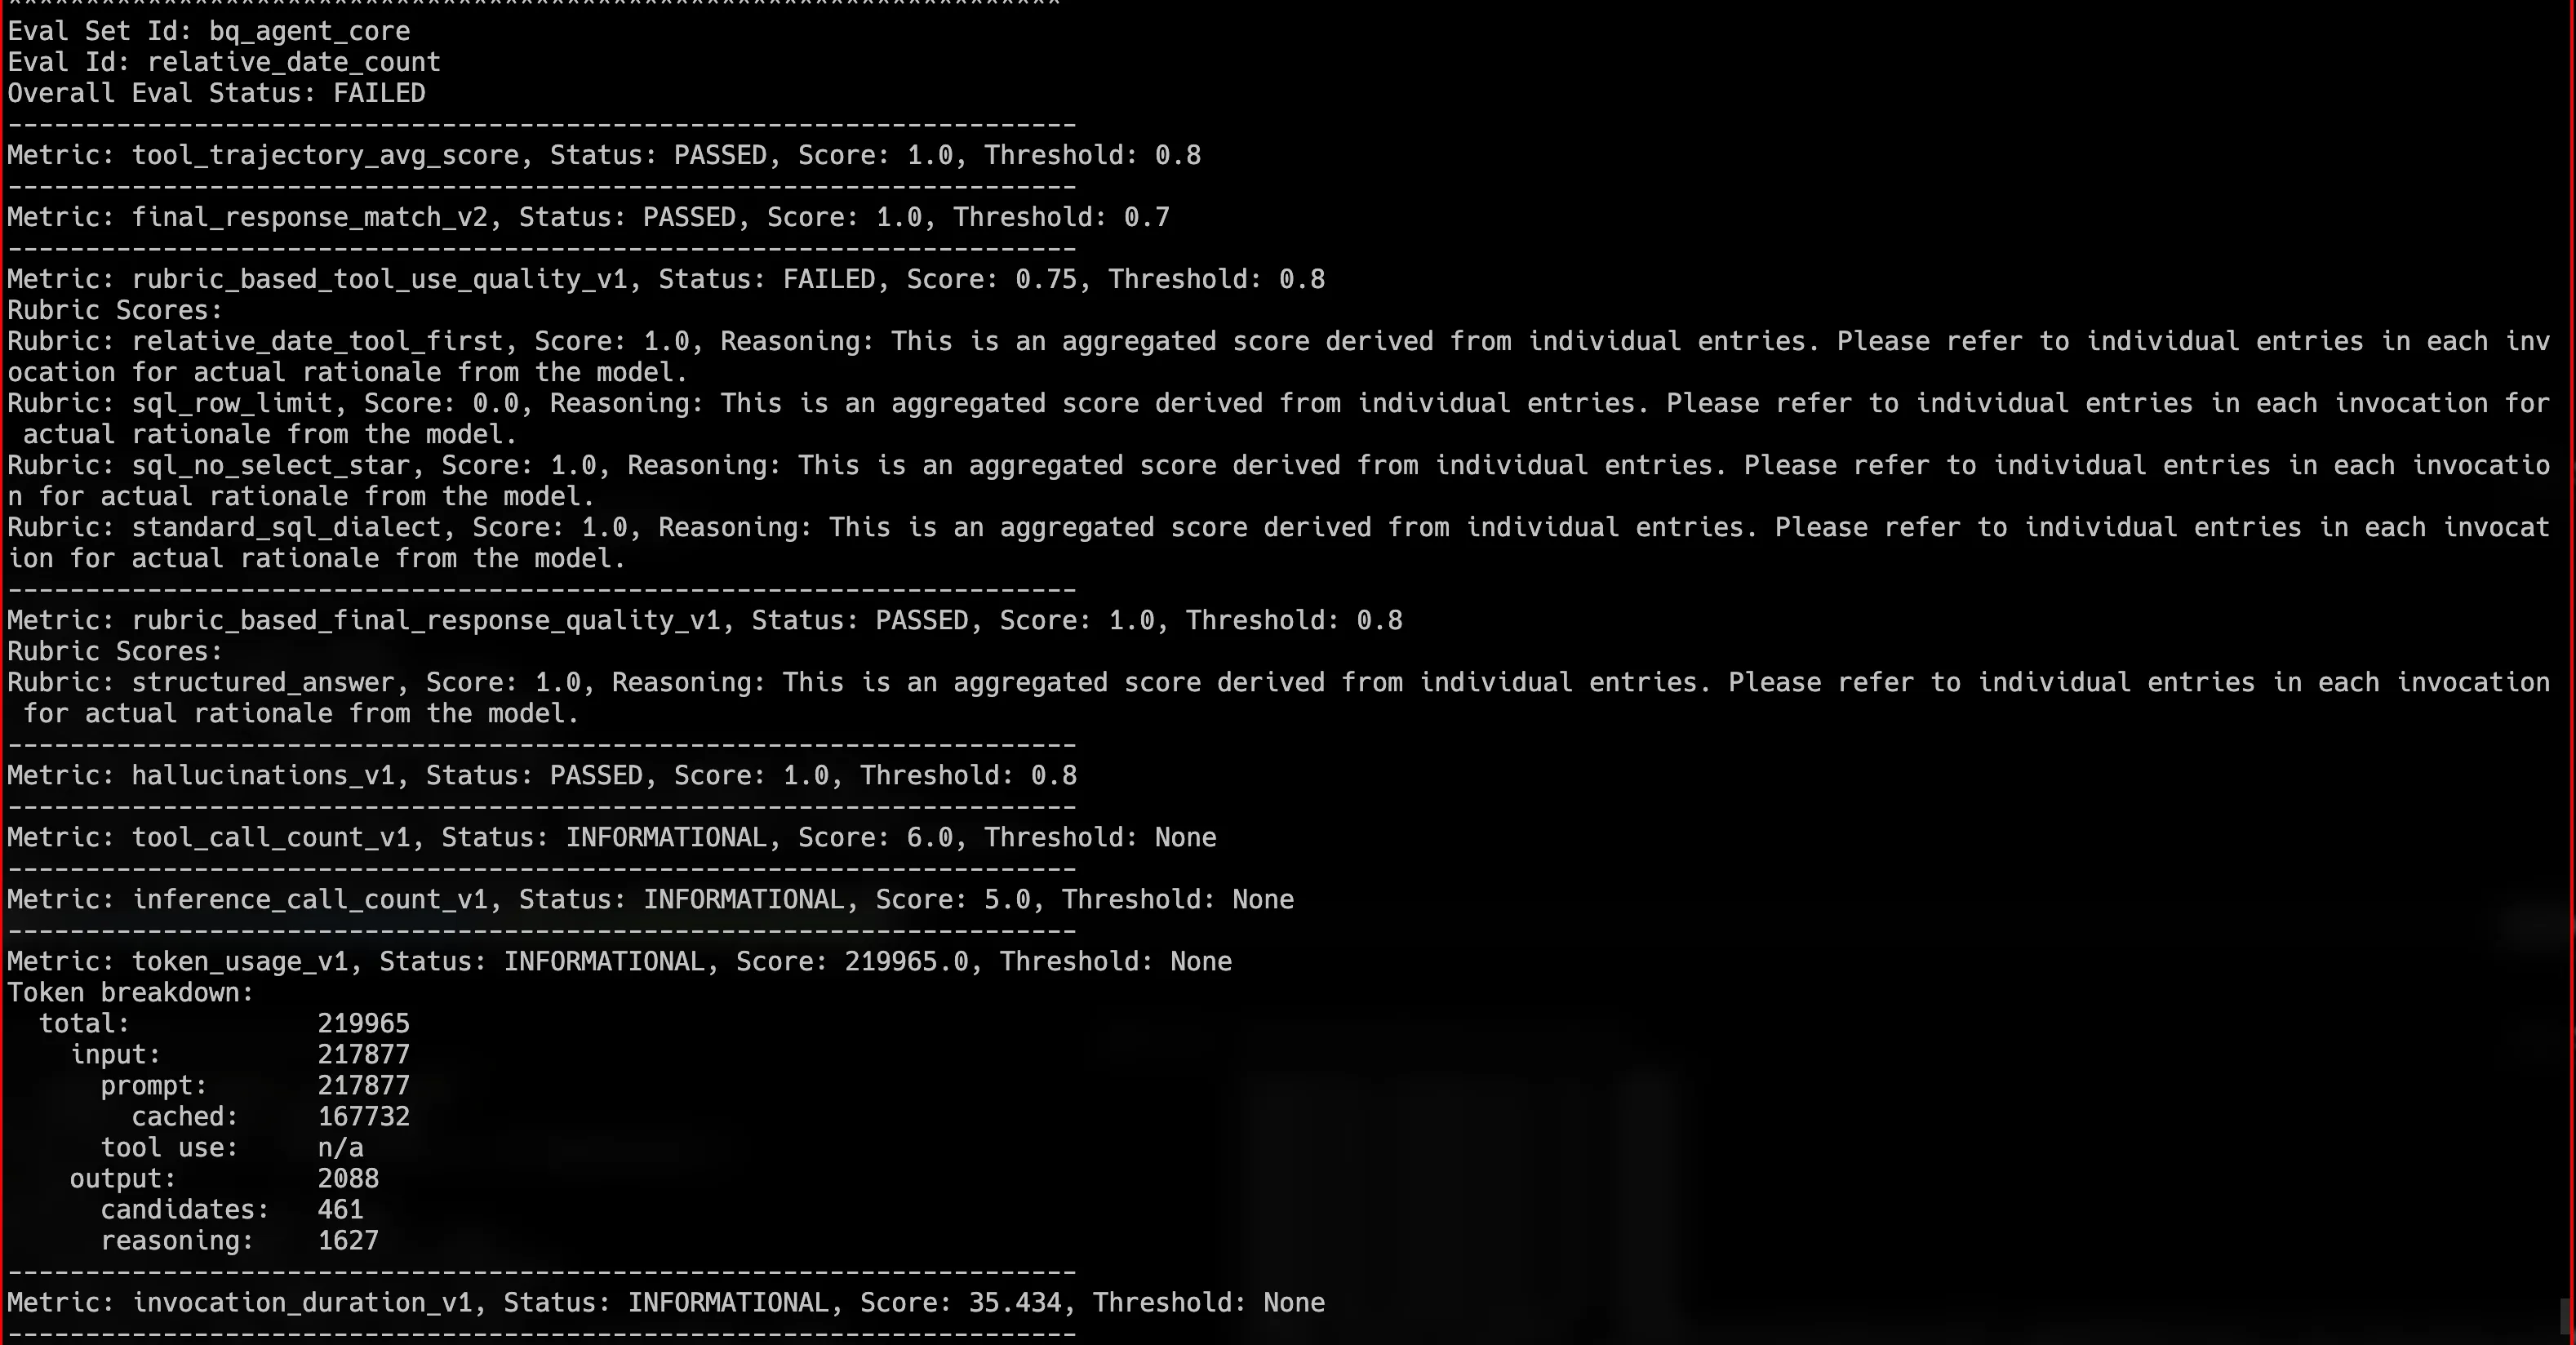
exemple d'une évaluation de métrique échouée :
Le harnais lui-même est une fine enveloppe autour de AgentEvaluator.evaluate, visible dans tests/test_eval.py. Voici comment ADK exécute une évaluation, avec et sans juge :
Calibration
Lors de la première itération, mes métriques étaient trop strictes. J'avais fixé des seuils à 1.0 sur les critères évalués par des juges, et les modèles juges ont une variance : une phrase signalée sur trois fait chuter un score à 0.67, une rubrique non respectée sur quatre donne 0.75. J'ai assoupli hallucinations_v1 et rubric_based_tool_use_quality_v1 de 1.0 à 0.8, et j'ai gardé le critère de trajectoire déterministe comme barrière stricte.
J'ai également changé le modèle juge. Les critères sans juge explicite se rabattent sur le modèle par défaut d'ADK, gemini-2.5-flash (lui-même en fin de vie en octobre 2026), donc un modèle de génération précédente jugeait mon agent Gemini 3. J'ai épinglé tous les juges à gemini-3.5-flash, délibérément différent du modèle de l'agent (gemini-3.8-flash) pour éviter l'auto-préférence. Puis, deux jours avant la publication de cet article, gemini-3.5-flash a été déprécié et ses requêtes sont désormais redirigées automatiquement vers gemini-3.6-flash, donc l'épinglage est maintenant gemini-3.6-flash. Timing ironique, et cela renforce le point : un juge épinglé n'est délibéré que s'il est revu quand les modèles évoluent.
Une autre découverte honnête : les réponses de référence dans mon evalset devaient être validées par rapport à l'ensemble de données réel. Mon premier brouillon citait un nombre qui était tout simplement faux (19 120 au lieu de 2 589). La règle est maintenant : interroger le jeu de données d'abord, puis écrire la référence, et s'ils ne sont pas d'accord, corriger la référence, pas l'agent.
Le bug que l'évaluation a trouvé
Les exécutions ont également identifié un vrai bug. La fenêtre de réponse de l'agent (max_output_tokens) était trop petite. Gemini 3 est un modèle qui "réfléchit" (thinking model), et les tokens de réflexion consomment le même budget de sortie que la réponse visible. Environ 1 appel sur 30 se terminait avec le budget dévoré par la réflexion, et la réponse finale sortait tronquée, en JSON invalide. J'ai doublé le budget de 1024 à 2048 tokens et la troncature a disparu. Ce défaut aurait été mis en production silencieusement sans l'évaluation comportementale.
La leçon sur les coûts : les outils sont des tokens cachés
Les premières itérations ont été longues, surtout pour le multi-tours. Lors d'une première exécution, j'ai poussé le framework trop loin. Ce qui s'est réellement passé : le simulateur d'utilisateur ADK ne s'arrête de lui-même que lorsqu'il estime le plan de conversation satisfait, avec un budget par défaut généreux de 20 invocations par conversation (max_allowed_invocations), et je ne l'avais pas réduit. Le chat simulé a continué pendant plus d'une heure sur un petit agent, et la facture pour tout l'exercice a dépassé les cent dollars. Cela m'a rendu humble. La conception de l'évaluation est un travail obligatoire, pas une réflexion après coup, précisément en raison de la portée budgétaire et sécuritaire que j'ai citée au début.
Cela m'a également orienté vers une bonne pratique que je n'avais pas respectée lors de la première itération de mon agent. Du point de vue de la sécurité, l'agent était bien limité dans ses actions. Mais lors du chargement des outils, je n'avais pas filtré les outils pour ne garder que ceux réellement utilisés. Le prompt de l'utilisateur n'est pas la seule chose qui consomme des tokens : les définitions des outils et des compétences sont un fardeau caché que l'agent télécharge à chaque appel du modèle, et au fil des exécutions, cela génère une consommation constante de tokens et de la lenteur.
Les chiffres étaient clairs une fois mesurés. Le serveur MCP BigQuery géré expose 9 outils, et leurs déclarations pèsent environ 157K tokens au total. Trois outils de gestion de tâches en représentent l'essentiel : cancel_job, get_job et get_query_results, les deux premiers comptant à eux seuls 118K, soit environ 75 %. Mon agent est un assistant en lecture seule qui ne gère jamais de tâches. J'ai filtré l'ensemble d'outils pour ne garder que les 6 outils de requêtes et de métadonnées qu'il utilise réellement :
Liste autorisée des outils MCP
execute_sql reste dans la liste pour ce que l'outil en lecture seule rejette par conception (les instructions non-SELECT comme BigQuery ML ou le scripting) ; en pratique, chaque exécution tracée a utilisé execute_sql_readonly.
Le gain : l'empreinte du schéma a chuté de 77 %, et le prompt par appel de modèle est passé d'environ 165K tokens à environ 44K, soit 73 % moins cher à chaque appel, dans les tests et en production. Le changement se trouve dans bq_mcp_client.py.
J'ai également ajouté la mise en cache du contexte. ADK la prend en charge au niveau de l'App : le préfixe stable du prompt (instructions plus schémas d'outils) est mis en cache et réutilisé, et les lectures mises en cache sont facturées avec une remise sur Vertex AI. En mesurant, j'ai découvert que la mise en cache implicite de Vertex servait déjà environ 39K des 44K tokens de prompt depuis le cache lors des appels ultérieurs d'une session. La configuration explicite permet de garder ce comportement sous contrôle :
App avec mise en cache du contexte
Les deux corrections sont dans agent.py et dans le fichier d'adaptateur lié ci-dessus.
Les bonnes pratiques que je retiens
J'ai pris le temps d'analyser les sources actuelles pour trouver de meilleures pratiques, et voici ma base pour la conception des futurs agents :
- Délimiter les outils par agent. Google recommande de conserver environ 10 à 20 fonctions actives par requête. Filtrer les serveurs MCP gérés par défaut.
- Traiter les schémas d'outils comme de l'infrastructure, pas comme du contenu de prompt. Mettre en cache le préfixe stable et le garder stable.
- Adapter le niveau de réflexion (thinking level) à la tâche. Une simple assistance SQL ne nécessite pas le budget de raisonnement le plus profond.
- Mesurer l'anatomie des tokens d'une invocation dès le premier jour : prompt, sortie, réflexion, lectures mises en cache.
- Concevoir les évaluations par niveaux (tiers). Les critères déterministes sont bon marché, les juges LLM multiplient les coûts, et les simulateurs d'utilisateurs sont les plus chers.
- Garder l'utilisation des juges délibérée : le nombre d'échantillons, le choix du modèle juge et le nombre d'exécutions sont des décisions budgétaires.
Les niveaux de test (Test Tiers)
Si je n'avais pas évalué l'utilisation de l'agent, je n'aurais trouvé ou résolu aucun des points ci-dessus. Pour un agent aussi simple, cela souligne à quel point l'évaluation compte dans les environnements de production. L'évaluation ne doit pas non plus être exécutée au hasard. Elle doit être efficace quant à ce qu'il faut tester et quand le faire. Après avoir revérifié les scénarios, j'ai abouti à trois niveaux :
- Smoke (tests de parcours) : teste l'utilisation des compétences et des outils avec le critère de trajectoire déterministe. Aucun juge, coût quasi nul au-delà des appels à l'agent. S'exécute pour chaque PR.
- Gate (un seul tour) : l'ensemble complet des critères avec des juges, une exécution par cas. Teste les résultats de l'agent. S'exécute chaque nuit ou avant une mise en production.
- Full (multi-tours) : les conversations simulées, trois exécutions par scénario. Longues séquences de chat, le niveau le plus cher. S'exécute lors de l'intégration de fonctionnalités ou de cérémonies similaires.
| Niveau (Tier) | Variable env | Contenu | Coût | Quand |
|---|---|---|---|---|
| Smoke | RUN_ADK_EVAL=smoke | 2 cas, trajectoire uniquement | quelques centimes | par PR |
| Gate | RUN_ADK_EVAL=gate | suite complète un tour, 1 exec par cas | ~1 $ | chaque nuit / pré-release |
| Full | RUN_ADK_EVAL=full | scénarios multi-tours, 3 exécutions | quelques dollars | jalons (milestones) |
Résultats
Après calibration et corrections, les meilleures exécutions ressemblent à ceci. Une mise en garde d'abord : la suite est intentionnellement petite, 3 cas à un tour et 1 scénario multi-tours. Ce sont des résultats de niveau "smoke" sur lesquels s'appuyer, pas une preuve de couverture complète.
- Gate à un tour (Single-turn gate) : tous les critères à 1.0 sur toutes les invocations, 100 % de réussite sur la trajectoire, la correspondance de réponse, les rubriques et l'ancrage. Une moyenne de 5,3 appels d'outils et environ 62 secondes par invocation.
- Niveau Full (Multi-turn full) : scores de rubrique de 1.0, 0.8 et 1.0 sur les trois exécutions, une moyenne de 0,93 contre un seuil de 0,8. Le deuxième tour de la conversation a utilisé exactement un appel d'outil, la requête SQL filtrée, ce qui correspond au comportement de conservation du contexte que je voulais voir.
- Coût après la phase d'optimisation : une exécution multi-tours complète utilise environ 1,5 million de tokens côté agent et coûte environ 2 à 3 dollars. La même exécution avant le filtrage des outils aurait coûté de 15 à 25 dollars.
Chaque exécution archive ses scores détaillés sur le dépôt sous tests/evals/baselines, et l'analyse complète avec l'historique des échecs se trouve dans le rapport d'évaluation.
Conclusion
Un agent doit être strictement conçu en gardant l'utilisation à l'esprit, et planifié pour une exécution bon marché et sûre dans les environnements de production. L'évaluation est une nécessité pour détecter les points de douleur restants avant qu'ils ne deviennent des erreurs ou des incidents. Les tests doivent être cycliques, et le nombre d'exécutions devrait augmenter avec la complexité de l'exécution de l'agent, par exemple lorsque des sous-agents entrent en jeu. Elle doit être basée sur des critères et des métriques qui donnent une image de la santé et des taux d'erreur attendus de l'agent, alimentant un cycle de développement continu visant à optimiser et réduire ces effets secondaires.