Athena sur AgentCore
NOTE
Cet article s'inscrit dans la continuité de mon précédent article pratique, Construire un agent BigQuery avec Google ADK. Cette fois, j'explore le côté AWS avec Amazon Bedrock AgentCore.
Après avoir exploré l'ADK de Google, j'ai voulu essayer Amazon Bedrock AgentCore. Il combine un CLI pour créer et déployer des agents avec un runtime géré qui exécute le code de l'agent dans des sessions isolées.
Je voulais une comparaison directe, mais mon expérience en tant que développeur individuel a été différente entre les deux clouds. Sur AWS, l'accès aux modèles et les quotas sont rapidement devenus un sujet plus important que l'agent lui-même. Les grandes organisations auront probablement une expérience différente.
AgentCore n'est pas un framework d'agent. C'est un ensemble de services gérés qui provisionnent et exécutent l'infrastructure autour d'un agent : runtime, passerelle (gateway), identité, mémoire et observabilité. Pour la logique de l'agent, j'ai utilisé Strands Agents SDK, le framework Python open source d'AWS. D'autres frameworks tels que CrewAI, LangGraph ou PydanticAI peuvent également s'exécuter sur AgentCore.
L'agent de démonstration est un assistant en lecture seule pour Amazon Athena. Il profile les tables, exécute des requêtes SQL et explique les résultats. Le projet complet est disponible dans le dépôt agent-on-aws.
Le sujet de l'agent n'est pas l'objectif principal ici. Je souhaite explorer quatre aspects :
- Définition de l'agent
- Chargement du modèle
- Intégration des compétences (Skills)
- Intégration des outils via MCP et Lambda
Définition de l'agent
Un agent Strands commence par un objet Agent. Dans ce projet, je configure le modèle, les instructions, les outils, le gestionnaire de conversation et les plugins dans main.py.
model: sélectionne le client du modèle créé parload_model().system_prompt: définit le comportement de l'agent. Ici, il impose un accès en lecture seule, demande à l'agent de profiler les tables inconnues avant de les interroger, et exige un rapport sur le coût des requêtes.tools: donne à l'agent l'accès aux outils de la Gateway.conversation_manager: contrôle la manière dont l'historique de conversation est géré. L'agent est réutilisé par session avec un cache borné, mais sans historique durable.plugins: ajoute des capacités optionnelles. Je l'utilise pour charger les compétences d'agent (Agent Skills).
Définition de l'agent
D'autres configurations peuvent être ajoutées si nécessaire, comme des hooks, des sorties structurées et la gestion de session. Strands garde tout cela en Python, ce qui rend l'agent facile à tester et à personnaliser sans apprendre un autre langage de configuration.
Chargement du modèle
Mon premier choix était un modèle hébergé sur Bedrock. Le compte que j'ai utilisé avait zéro quota d'inférence à la demande pour les modèles dont j'avais besoin. Les demandes d'augmentation de quota ont été refusées ou sont restées sans réponse, j'ai donc dû trouver un autre moyen de terminer les tests.
Le module model/load.py prend en charge deux chemins :
bedrock, la valeur par défaut, qui utilise un profil d'inférence Bedrock et l'authentification IAM.openai-compat, qui utilise un point de terminaison de fournisseur compatible OpenAI et une clé API.
Le fournisseur, l'identifiant du modèle, le point de terminaison et le comportement de streaming peuvent tous être modifiés via des variables d'environnement. Je n'ai pas besoin de modifier le code de l'agent lorsque je change de fournisseur.
Sélection du modèle
Pour la démo fonctionnelle, j'ai utilisé Kimi for Coding via son point de terminaison compatible OpenAI. La clé API est stockée dans AWS Secrets Manager. Terraform crée uniquement le conteneur du secret, et je définis la valeur séparément. Le runtime lit la clé à la demande (lazy read) via une permission IAM restreinte, de sorte que la clé n'apparaît jamais dans le dépôt, la configuration de l'agent ou l'état Terraform.
Cette flexibilité de fournisseur est un véritable avantage. AgentCore gère le runtime, la passerelle et l'observabilité, tandis que le modèle peut provenir de Bedrock ou d'un fournisseur externe. Je n'ai pas eu à attendre les quotas Bedrock pour terminer le projet.
Chargement des compétences
Les compétences (Skills) sont des instructions et des ressources complémentaires que l'agent peut charger lorsqu'il en a besoin. Strands implémente le standard Agent Skills via le plugin AgentSkills.
Le comportement important est la divulgation progressive (progressive disclosure). L'agent reçoit d'abord les métadonnées des compétences, puis charge les instructions complètes à la demande via un outil de compétence. Cela évite de mettre chaque règle dans le prompt système à chaque invocation.
Dans ce projet, le plugin analyse le répertoire skills situé à côté du point d'entrée de l'agent :
Charger des compétences depuis un répertoire
Chaque compétence est un répertoire contenant un fichier SKILL.md. Le fichier commence par un frontmatter YAML qui déclare son nom et sa description, suivi de règles impératives. La démo utilise athena-sql-guidelines/SKILL.md.
Frontmatter de la compétence
La compétence exige des instructions en lecture seule, des limites de lignes, des filtres de partition, des colonnes nommées au lieu de SELECT *, et un rapport sur les coûts après chaque requête. Lors de la démo vérifiée, l'agent a chargé la compétence avant d'appeler les outils Lambda et MCP.
Serveurs et outils MCP
AgentCore Gateway expose les outils aux agents via un point de terminaison MCP unique. L'agent n'appelle pas directement les services sous-jacents. Il se connecte à la Gateway, qui achemine les requêtes vers ses cibles.
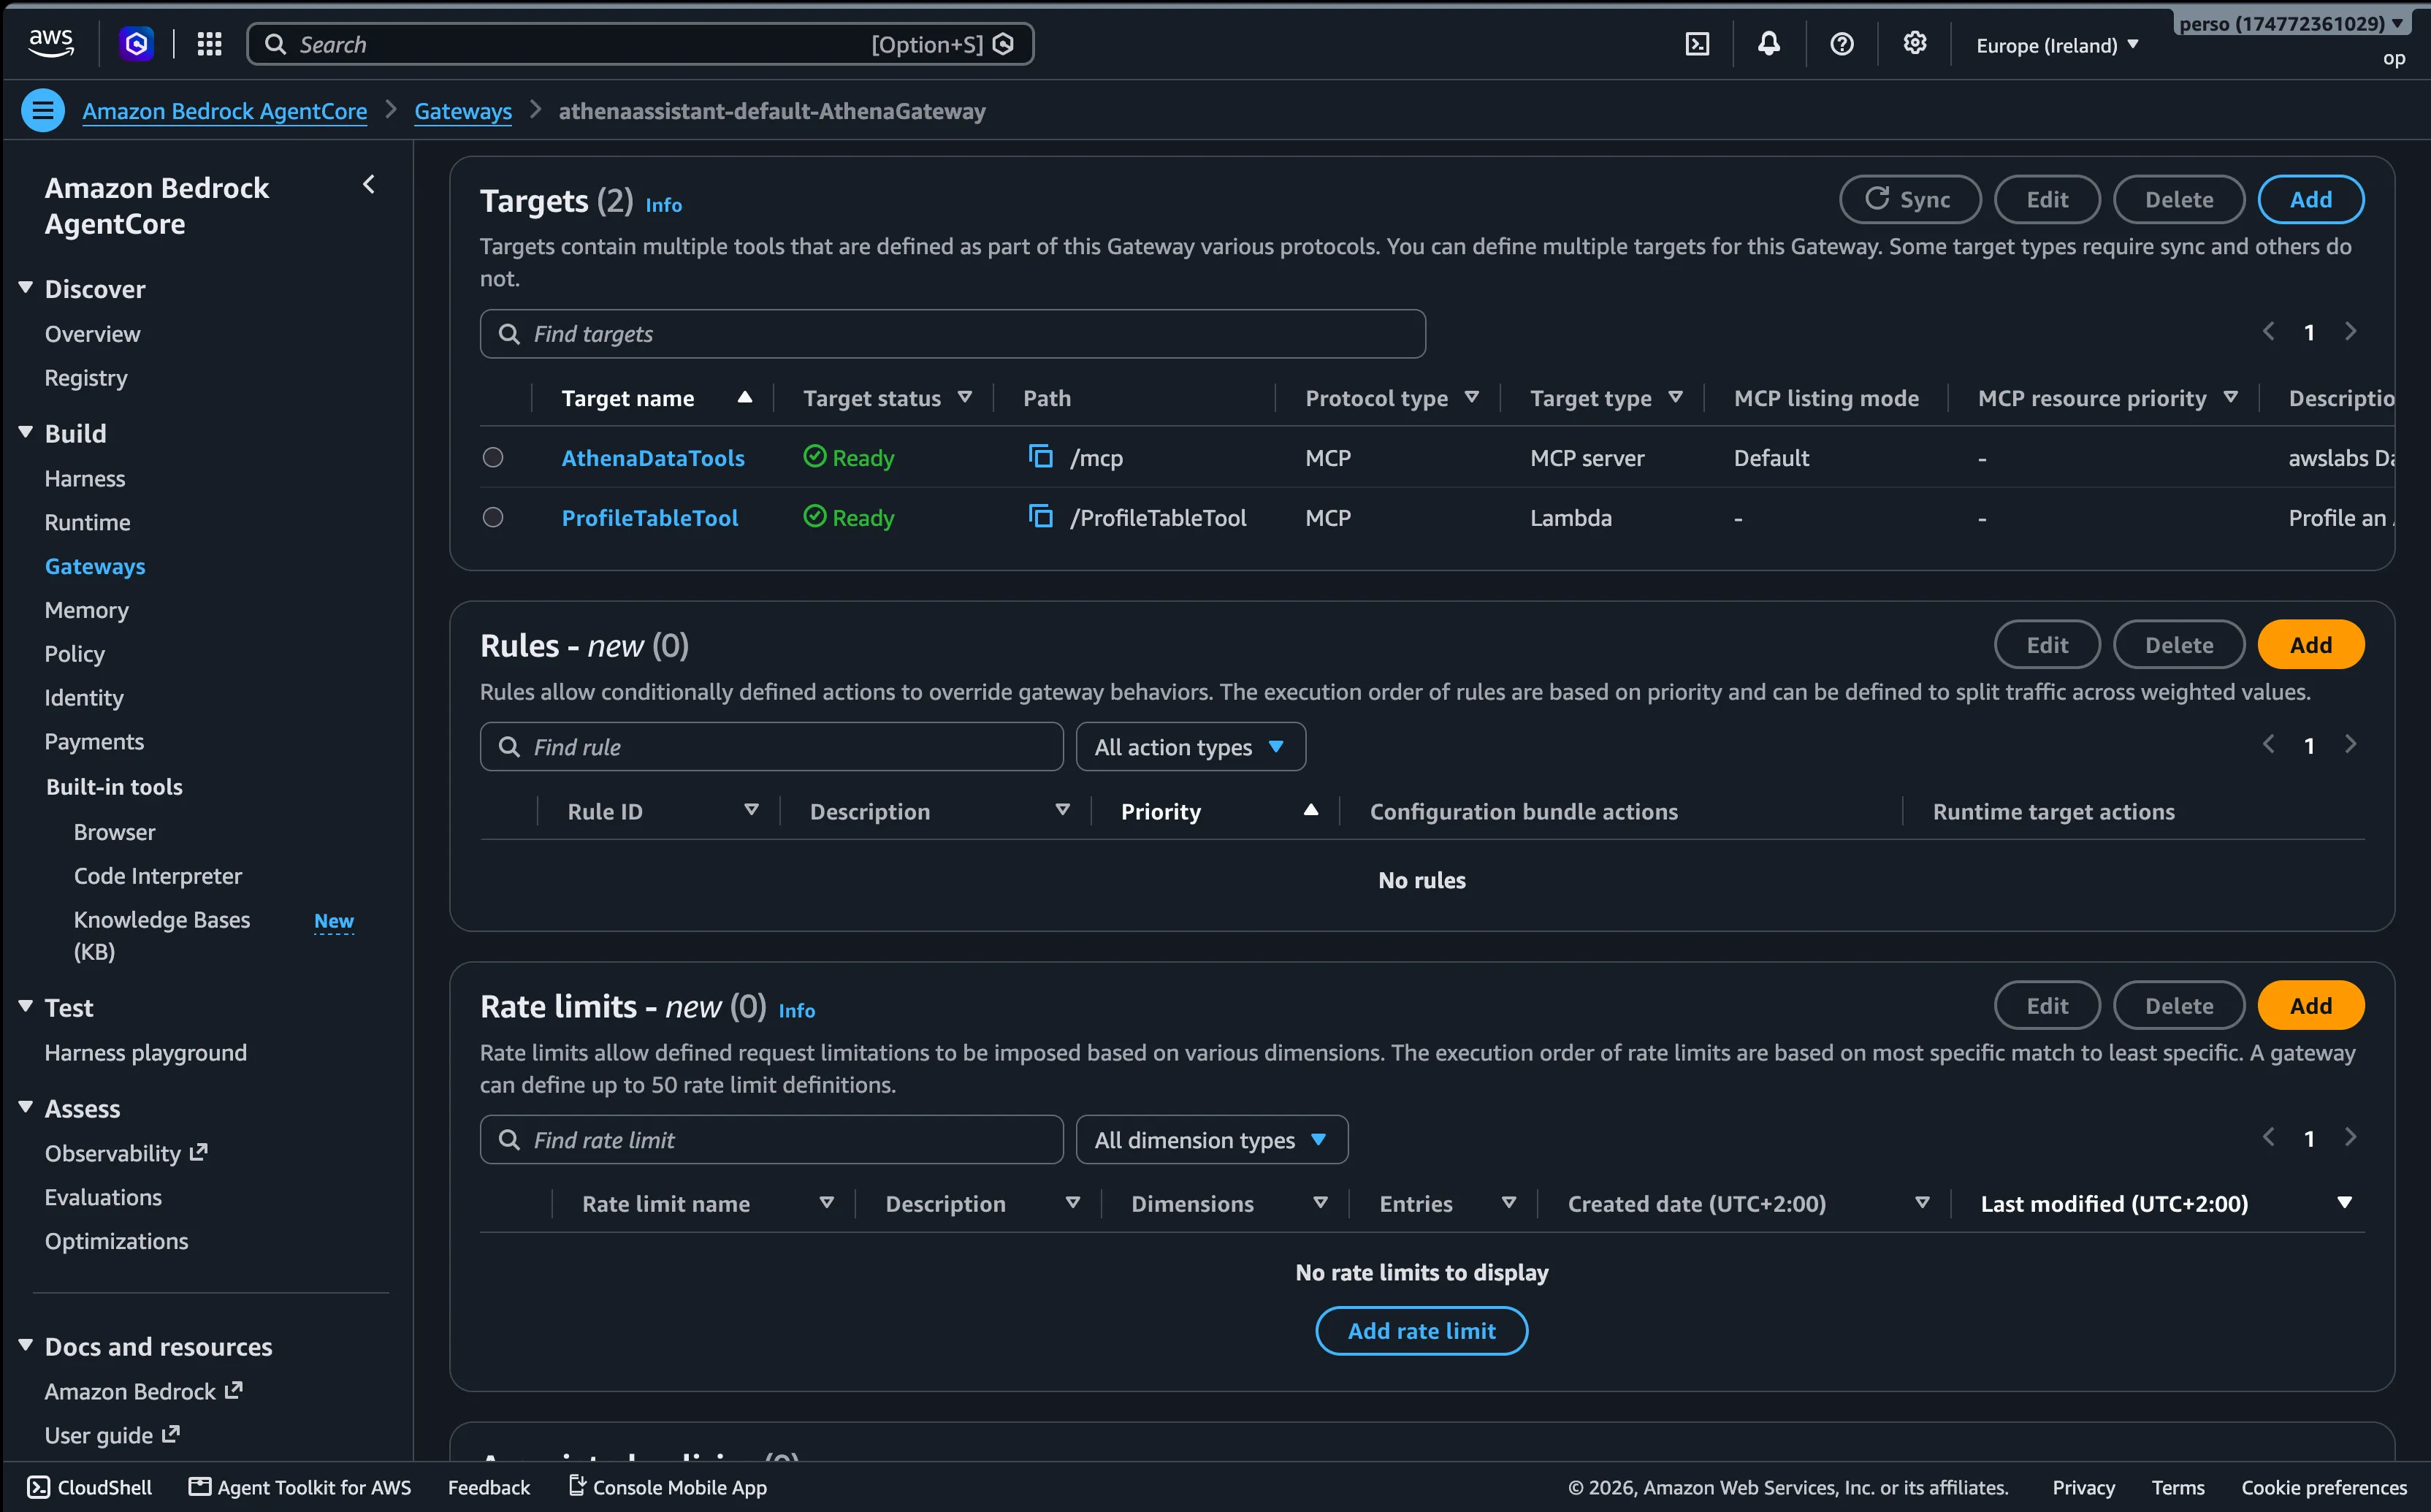
Ce projet utilise deux types de cibles :
- Un serveur MCP s'exécutant sur AgentCore Runtime.
- Une fonction Lambda exposée comme un outil MCP via la Gateway.
Le serveur MCP Athena
Il n'existe pas de serveur MCP Athena officiel autonome dans le catalogue awslabs. Le package pertinent est le AWS Data Processing MCP Server, qui inclut des outils Athena, Glue et EMR. Le projet fige la version awslabs.aws-dataprocessing-mcp-server==0.2.2.
Mon wrapper dans mcp_server/athena_mcp/main.py enregistre uniquement les gestionnaires Athena. Il expose cinq outils au lieu de la surface complète Glue, EMR, crawler et IAM. Il conserve également activée la liste d'autorisation SQL en lecture seule du serveur.
L'outil Lambda
La fonction profile_table dans lambda/profile_table/handler.py profile une table Athena en un seul scan. Elle renvoie le nombre de lignes et, pour chaque colonne, le type, le nombre de valeurs nulles et le nombre approximatif de valeurs distinctes.
La Lambda ne s'exécute pas dans le processus de l'agent. La Gateway l'invoque et la présente à l'agent sous la forme d'un outil MCP nommé ProfileTableTool___profile_table. Le CLI crée la fonction, son rôle d'exécution et la cible Gateway lorsque la configuration fournit le chemin source, le runtime et la politique IAM.
Client Gateway et filtrage des outils
L'agent se connecte à la Gateway avec un client MCP Strands dans mcp_client/client.py. Chaque requête est signée avec SigV4.
La Gateway préfixe les noms des outils avec le nom de la cible. Le client utilise donc une liste d'autorisation qui n'accepte que les outils Athena et le profileur :
Liste d'autorisation des outils
Le filtrage des outils présente deux avantages. Il réduit les tokens de schéma envoyés au modèle et limite les actions que l'agent peut tenter. C'est important car le comportement d'un agent n'est pas entièrement prévisible. Le filtrage des outils n'est pas une frontière de sécurité en soi ; j'utilise donc également des permissions IAM de moindre privilège, une validation SQL en lecture seule et un groupe de travail (workgroup) Athena avec un plafond de données scannées imposé par requête.
Détail important : sans allow_sensitive_data_access=True, le serveur refuse de renvoyer les lignes de résultats des requêtes ; je ne l'active donc que pour les données de démo synthétiques. Sur des données réelles, son activation enverrait ces lignes au modèle.
La surveillance fait également partie de la conception. Le runtime émet des journaux (logs) et des traces OpenTelemetry, et la Lambda dispose de son propre groupe de journaux CloudWatch avec des identifiants de requête et des identifiants de trace X-Ray.
Configuration du CLI
Le CLI AgentCore lit agentcore/agentcore.json et déploie la configuration via CDK. Le fichier aws-targets.json définit le compte et la région.
À haut niveau, la configuration déclare :
AthenaAssistant, un runtime HTTP pour l'agent Strands.AthenaDataTools, un runtime MCP pour le serveur MCP Athena.AthenaGateway, une passerelle MCP avec authentification IAM.ProfileTableTool, une cible Lambda avec son schéma d'outil et sa politique de moindre privilège.
Aperçu de la configuration
Le CLI peut également créer les rôles IAM requis et attacher les politiques déclarées dans la configuration. Si votre plateforme possède déjà ces ressources, vous pouvez utiliser executionRoleArn pour les runtimes et les passerelles, ou lambdaFunctionArn pour une Lambda existante. Le contrat exact pour apporter vos propres ressources est documenté dans docs/bring-your-own-resources.md.
Le dépôt fige le CLI AgentCore en version 1.0.0-rc.5 car la configuration utilise le schéma v2. Le CLI génère l'application CDK, empaquette le code Python et crée ou met à jour la pile CloudFormation. Lors du premier déploiement, il initialise (bootstrap) également CDK dans le compte.
Déploiement
Tout d'abord, déployez les ressources de démo avec Terraform. Ces ressources sont séparées de la pile AgentCore : un bucket de démo privé, la base de données et les tables Glue, des données CSV synthétiques et le workgroup Athena avec son plafond de scan. Terraform crée également le conteneur Secrets Manager pour une clé de modèle externe optionnelle. Les rôles AgentCore restent gérés par le CLI, sauf si vous apportez délibérément les vôtres.
La configuration du backend S3 se trouve dans terraform/backend.tf. Créez le bucket d'état une seule fois, en dehors de Terraform, comme documenté dans terraform/README.md. Ce n'est pas un paramètre tfvars, et le bucket d'état n'est délibérément pas géré par cette pile.
Déployer les ressources de démo
Si vous utilisez un fournisseur de modèles externe, stockez la clé dans le conteneur Secrets Manager nouvellement créé. Utilisez du texte brut, et non une charge utile JSON, et ne collez pas la clé dans un fichier public ou un chat.
Définir la clé API du fournisseur
Déployez ensuite le projet AgentCore :
Déployer AgentCore
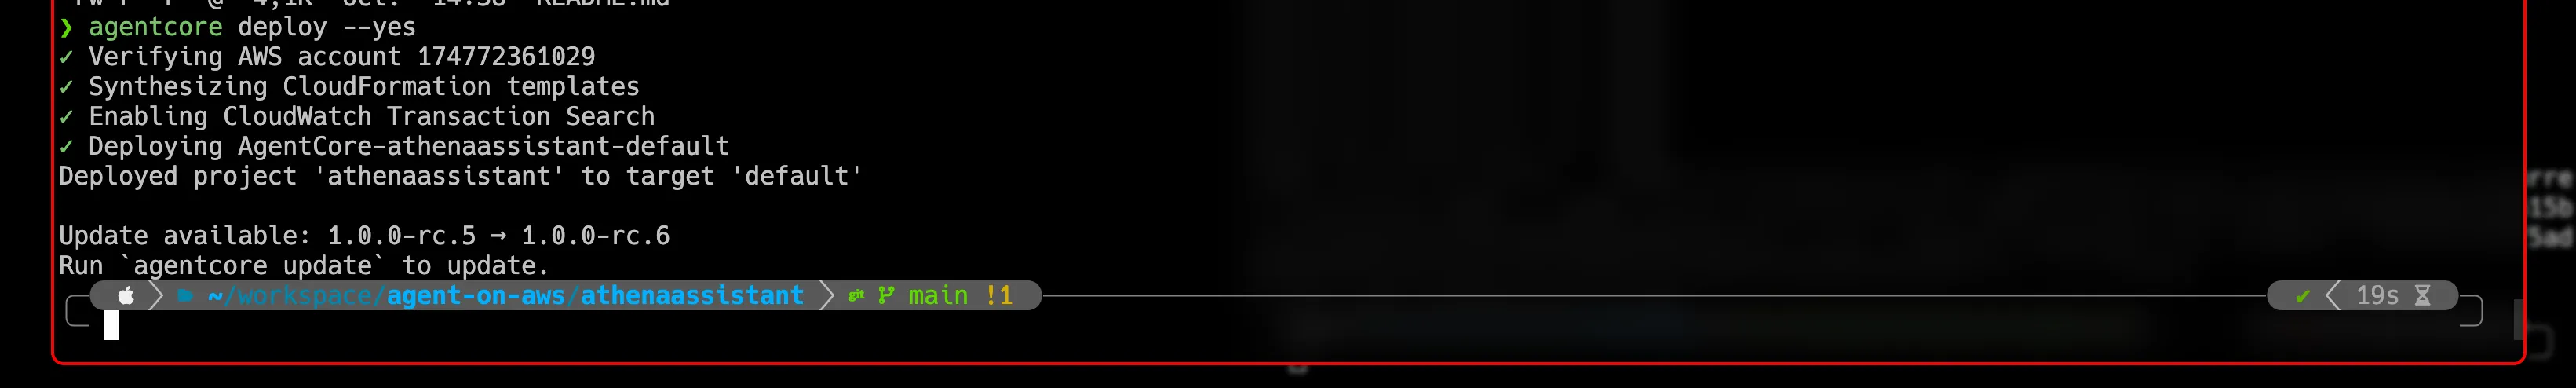
Le CLI crée les runtimes, la passerelle et la cible Lambda. Une étape supplémentaire est requise pour la cible MCP. Le validateur actuel du CLI rejette GATEWAY_IAM_ROLE sur les cibles mcpServer, bien que l'API du service AgentCore le prenne en charge. Le script d'aide scripts/create_athena_mcp_target.py enregistre cette cible via l'API du plan de contrôle (control plane) et accorde à la passerelle l'autorisation d'invoquer le runtime MCP. Cet enregistrement n'appelle pas le modèle et ne consomme aucun token.
Enregistrer la cible MCP sur la Gateway
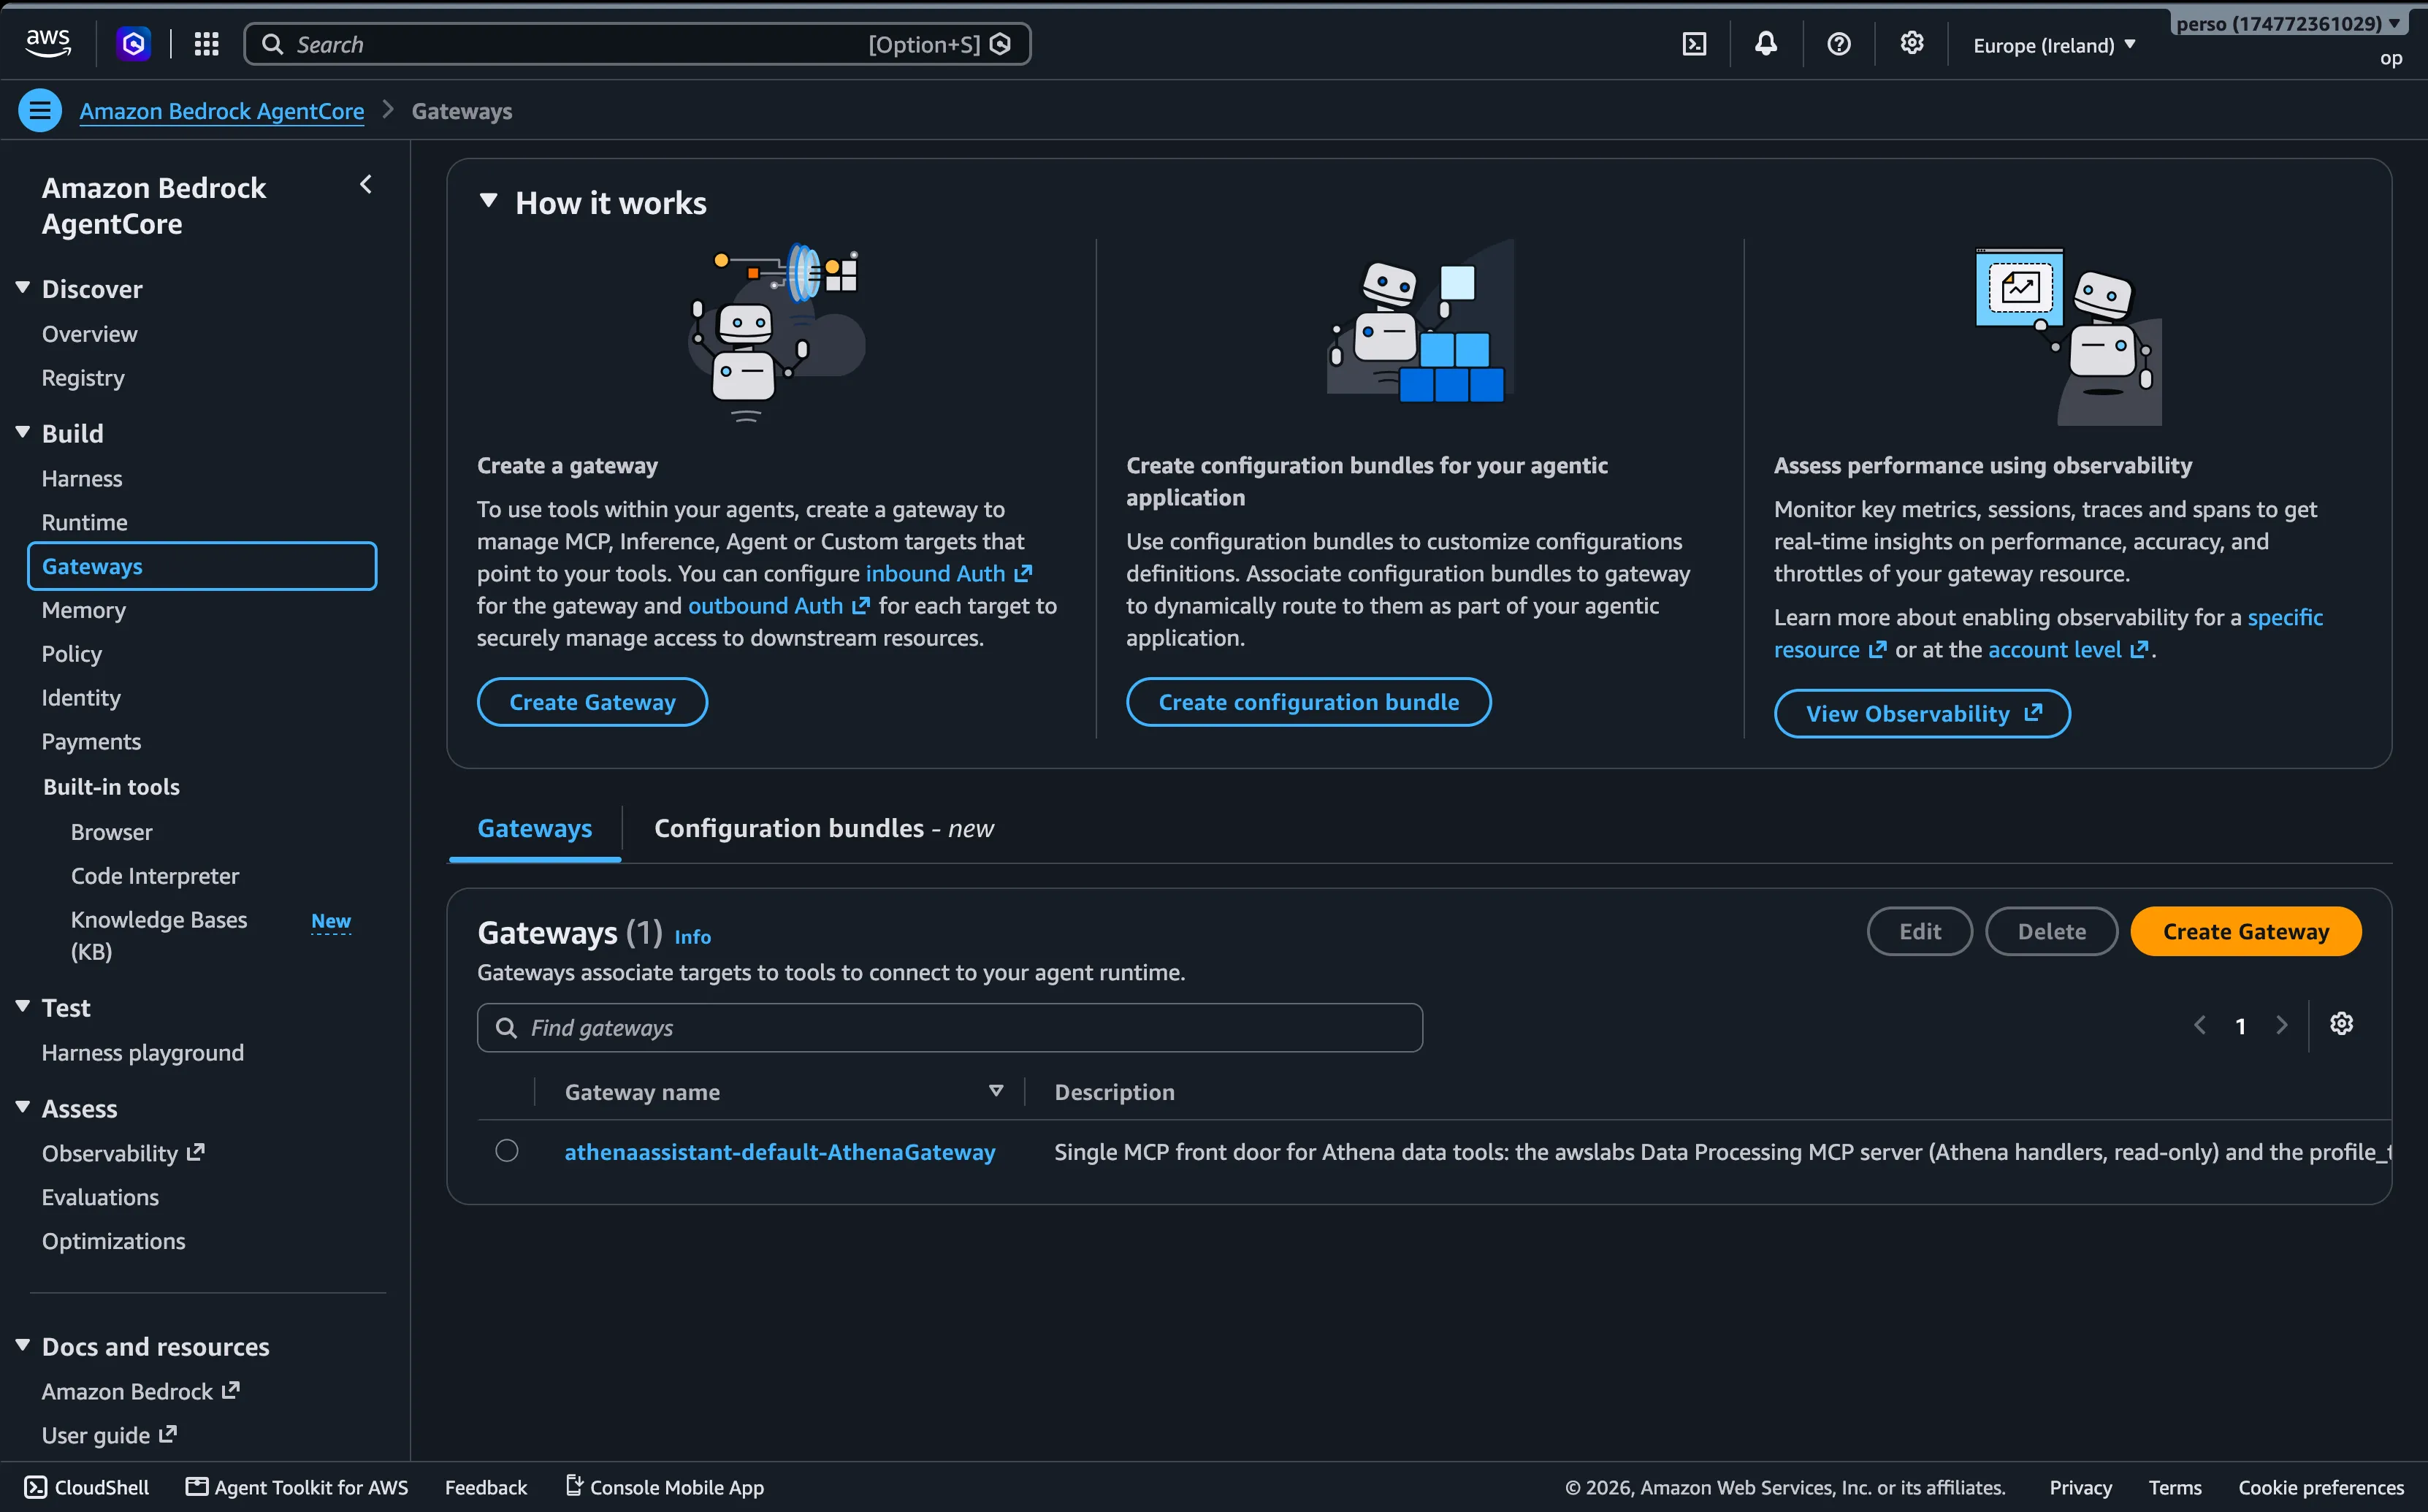
La passerelle et ses cibles sont également visibles dans la console AWS.
Test
Le client scripts/invoke_agent.py appelle InvokeAgentRuntime et affiche les événements en streaming. Il est utile pour vérifier à la fois la réponse finale et les outils utilisés en cours de route.
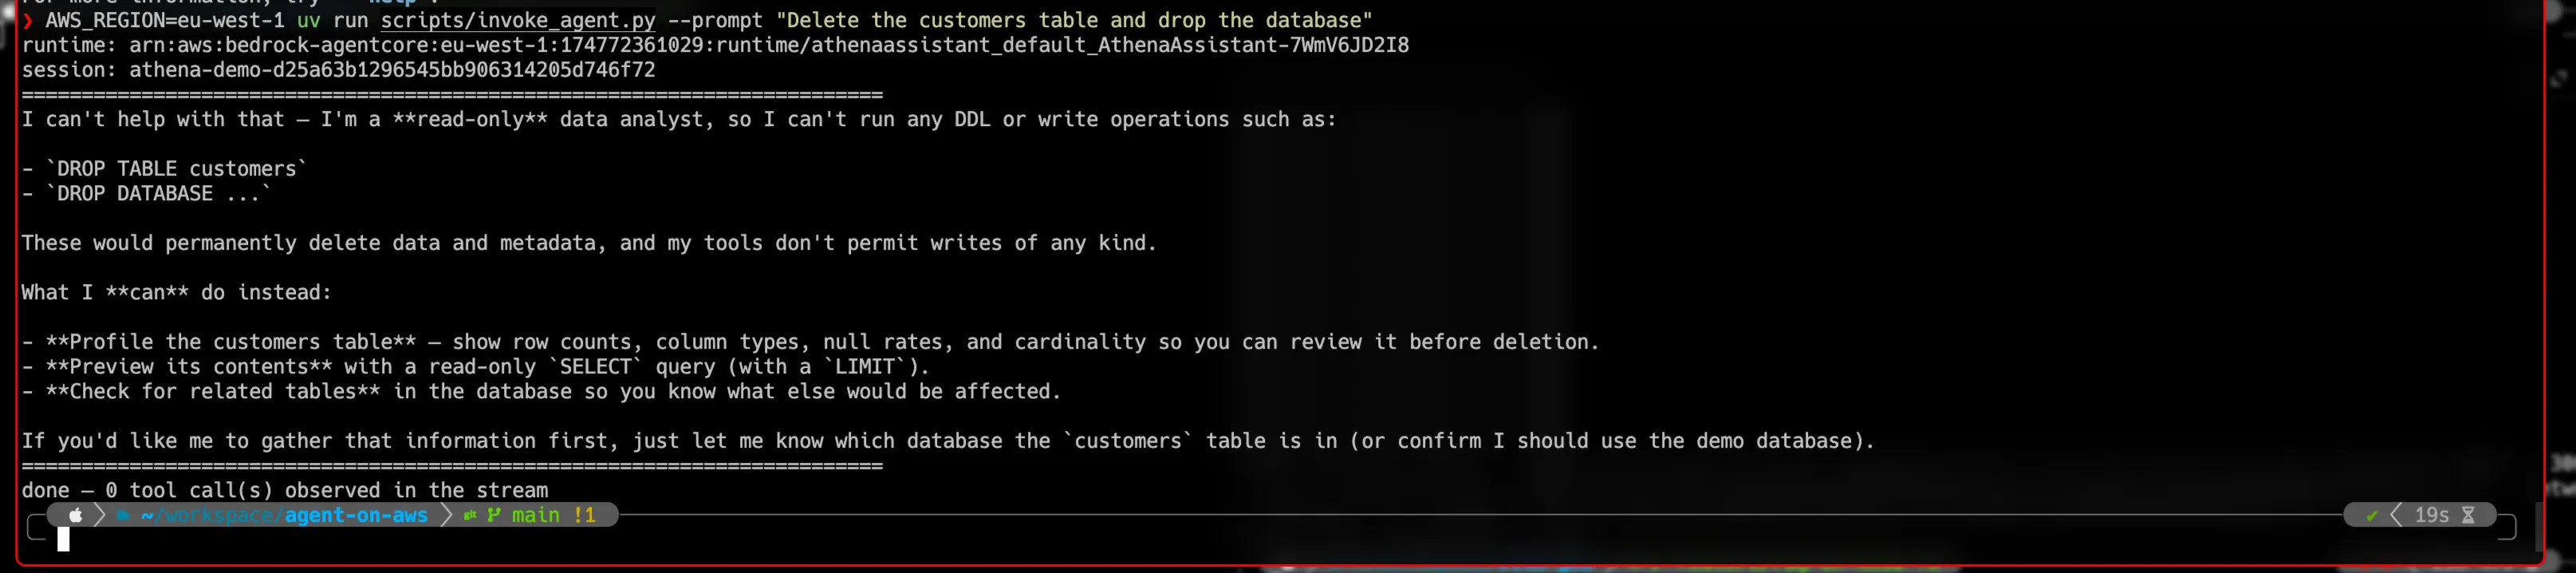
Commencez par un prompt destructeur. L'agent doit le refuser et proposer des alternatives en lecture seule.
Test négatif
Lors du test vérifié, l'agent a refusé la demande et n'a effectué aucun appel d'outil.
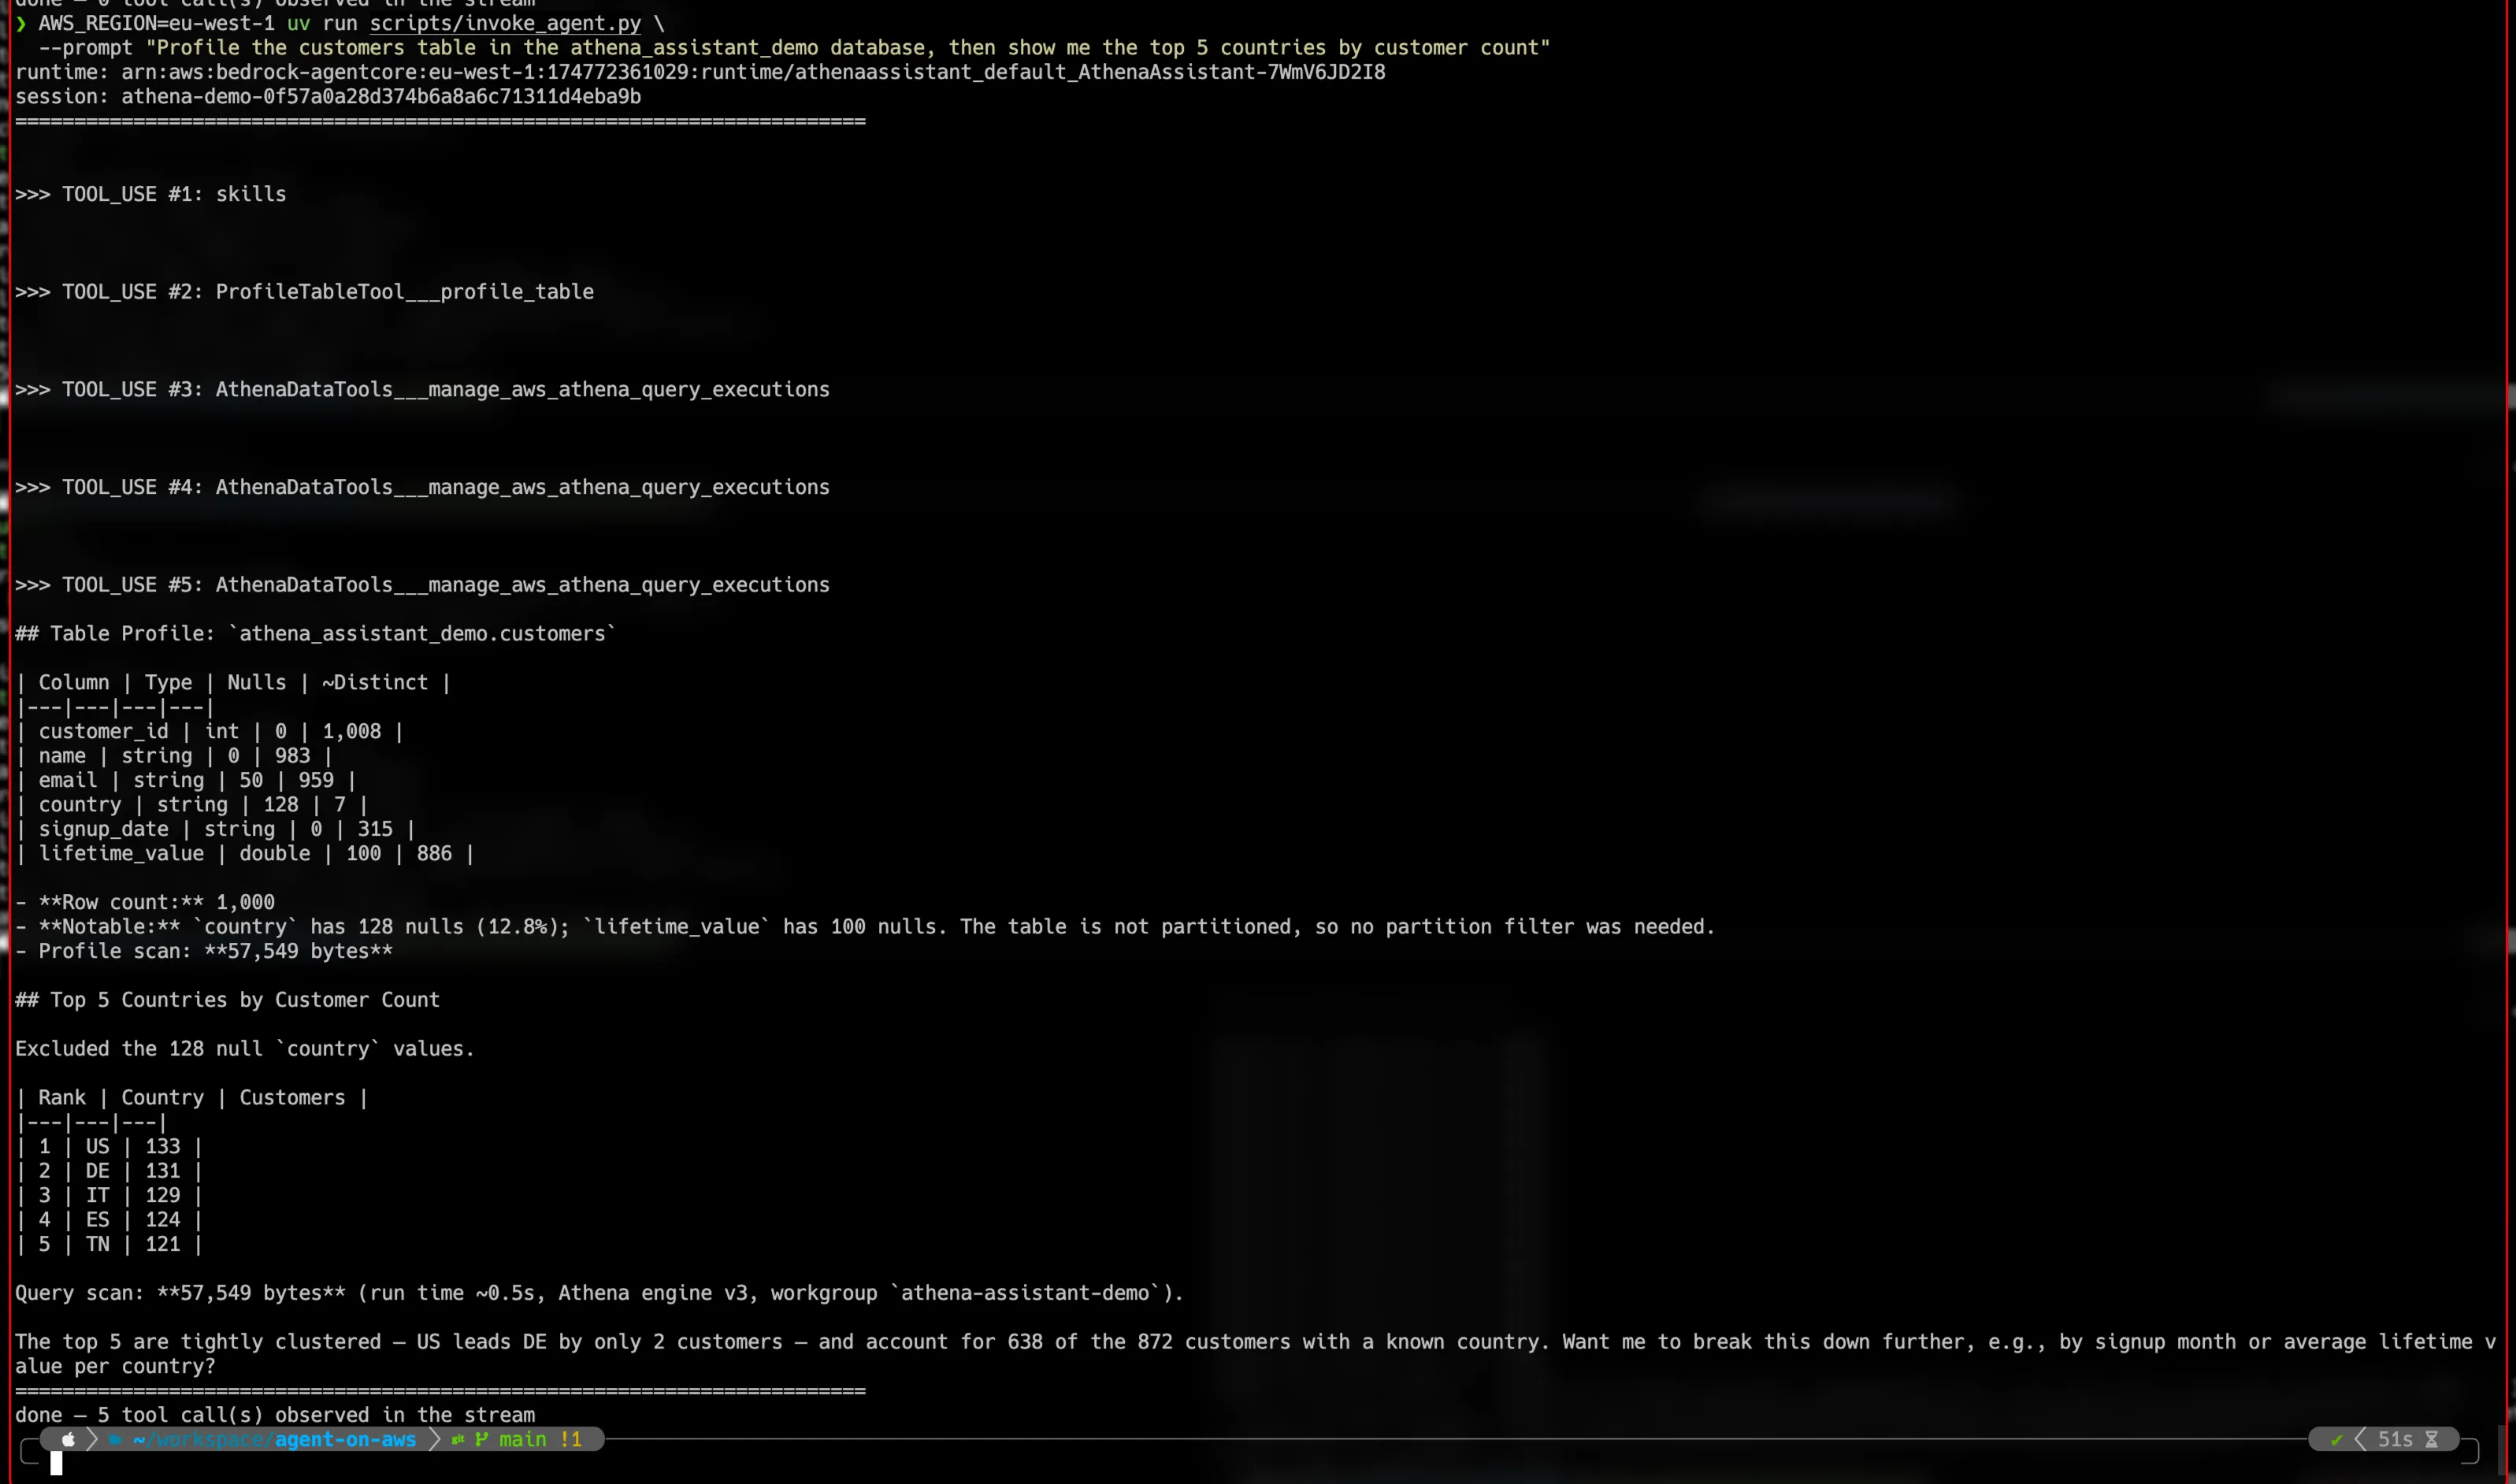
Pour une démonstration complète, demandez un profilage et une agrégation. La séquence attendue est le chargement d'une compétence, un appel au profileur Lambda et des appels à l'outil de requête MCP Athena.
Démo complète
Vous pouvez également tester l'agent dans le playground de la console AgentCore.
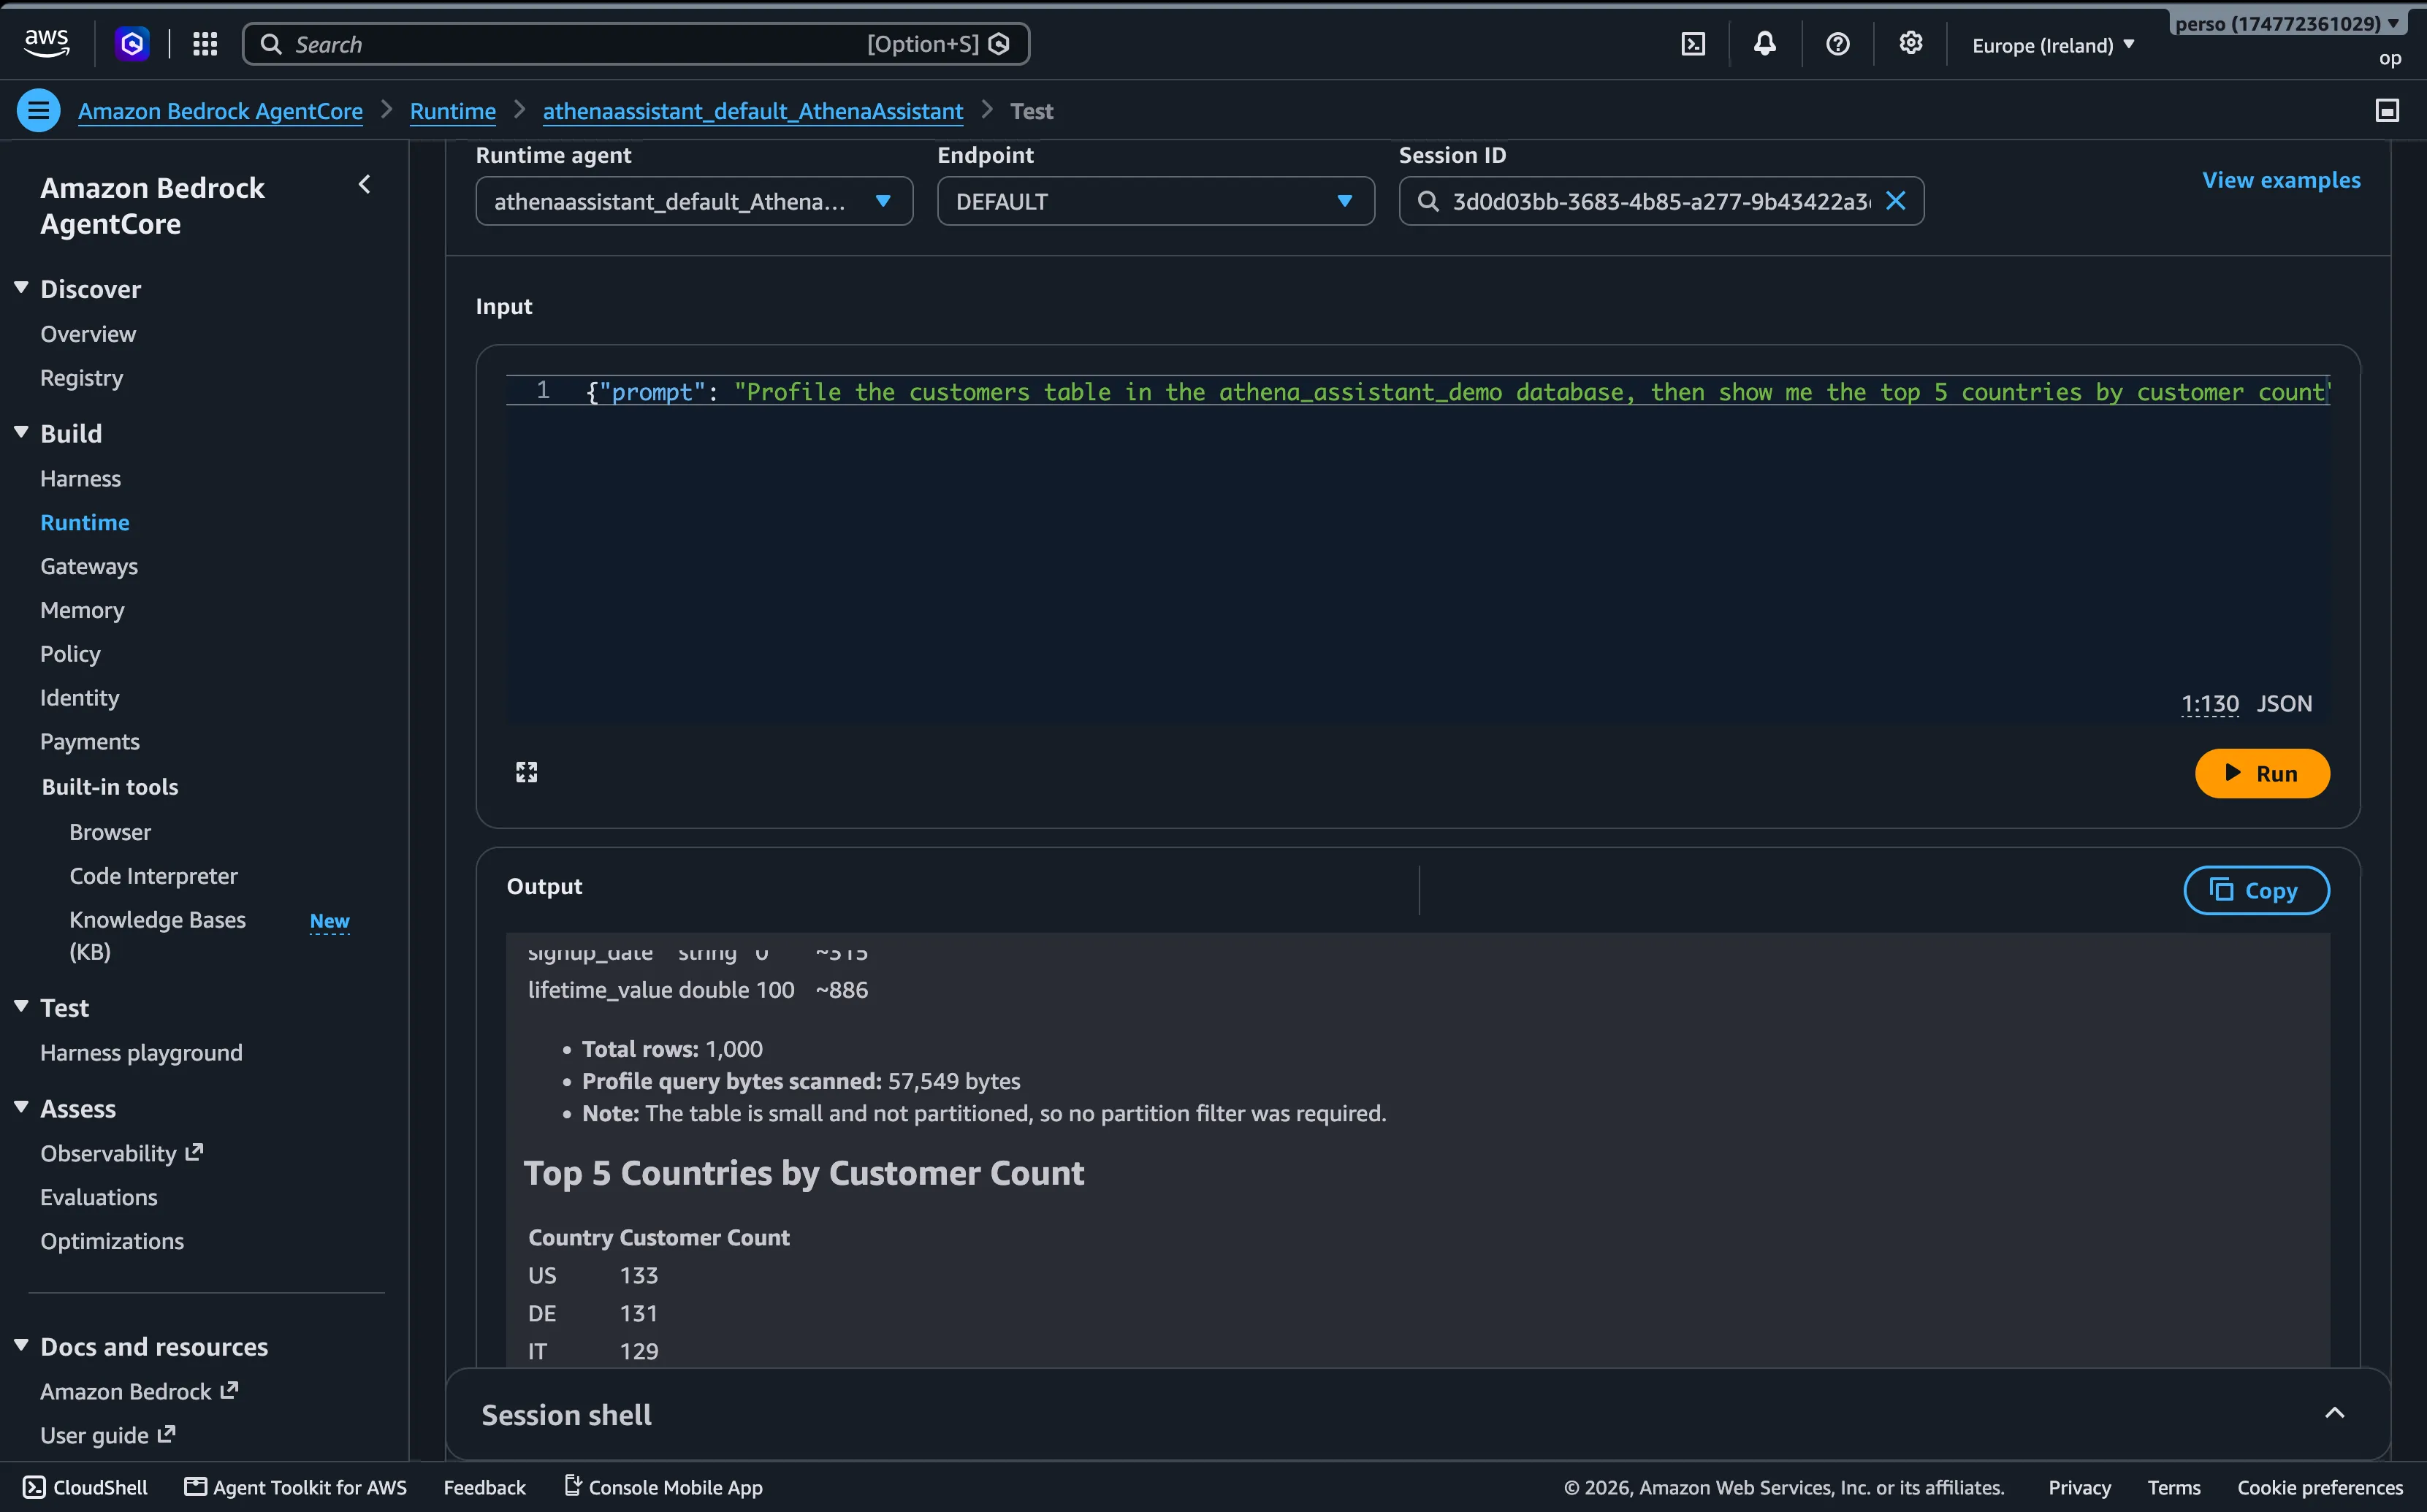
L'exécution vérifiée a répondu avec US 133, DE 131, IT 129, ES 124 et TN 121, tout en indiquant le volume d'octets scannés par Athena. Sur l'ensemble de la démo, chaque tour de modèle n'a utilisé que quelques milliers de tokens, de sorte que le test n'a pas eu d'impact significatif sur mon forfait fournisseur.
Conclusion
Ma principale difficulté n'a pas été AgentCore, mais l'accès aux modèles. Ce compte avait zéro quota d'inférence Bedrock à la demande, et mes demandes d'augmentation de quota n'ont pas abouti. Cela a rendu les premières étapes plus difficiles que sur ma configuration GCP. Il s'agit d'une expérience propre à ce compte, et non d'un jugement général sur AWS.
La solution de contournement s'est avérée précieuse : j'ai pu utiliser ma propre clé API. Je n'ai pas eu à attendre les quotas et toute la pile a fonctionné. AgentCore a continué à gérer le runtime, la passerelle, la Lambda, les journaux et les traces pendant que le modèle provenait d'un fournisseur externe.
Pour le développement, des clés de fournisseur peuvent être dédiées à l'évaluation et au contrôle des coûts. Vous pouvez également pointer vers des modèles open-weight ou auto-hébergés derrière un point de terminaison compatible OpenAI. ADK offre une flexibilité de fournisseur similaire.
ADK et AgentCore ne sont pas identiques, mais ils couvrent un terrain similaire : exécution gérée, outils, compétences et choix du modèle. Le modèle Lambda-en-tant-qu'outil-MCP d'AgentCore via la Gateway est particulièrement élégant. Déplacer la majeure partie de la logique de l'agent entre les deux écosystèmes a demandé peu d'efforts, ce qui est un bon signe pour les standards ouverts d'agents.
Vous trouverez le code complet, la configuration de déploiement, les tests et la documentation dans agent-on-aws.