Routage LLM Multi-Niveaux sur GKE
Note : Cet article est la suite de mon précédent article sur la mise à l'échelle de vLLM à zéro. L'intégralité du code de cette architecture multi-niveaux est disponible sur GitHub : iheb24/vllm-gke.
Dans l'un de mes derniers articles, j'ai ajouté un scaler KEDA à ma stack GKE. Cette configuration met automatiquement à l'échelle le nœud GPU à zéro pendant les périodes d'inactivité et le réveille dès qu'une requête arrive via curl ou un assistant de code comme Cline. Récemment, j'ai commencé à explorer les passerelles d'IA (AI gateways), plus particulièrement la façon dont elles peuvent servir plusieurs modèles derrière un point de terminaison unique et comment certaines proposent un mode "Auto" qui sélectionne dynamiquement le modèle le plus adapté. Dans cet article, je vais démontrer comment construire un système de routage multi-niveaux au-dessus de ma stack KEDA en utilisant des modèles et des concepts simples.
Pourquoi un seul modèle ne suffit pas
Réveiller le GPU à partir de zéro prend plusieurs minutes. Bien qu'un PersistentVolumeClaim mette en cache les poids du modèle Hugging Face sur le disque pour rendre les démarrages ultérieurs plus rapides (environ 3 minutes contre 7,5 minutes lors du tout premier boot), cette latence est encore loin d'être idéale. Notez que le PVC stocke le cache des poids du modèle, pas l'image du conteneur.
Attendre trois minutes pour obtenir la réponse à une simple question conversationnelle offre une mauvaise expérience utilisateur. De plus, cela entraîne un surdimensionnement important : démarrer un modèle de 14 milliards de paramètres sur un GPU dédié juste pour de petites discussions est une utilisation inefficace des ressources. Étant donné que l'efficacité des ressources est primordiale, j'ai décidé d'introduire une architecture à deux niveaux dans la stack.
Les deux modèles
La stack exécute désormais deux modèles distincts côte à côte :
qwen3-4b-cpu: Un modèle Qwen 3 de 4 milliards de paramètres s'exécutant sur CPU viallama.cpp. Ce modèle est toujours actif, léger et économique, ce qui le rend parfaitement adapté pour gérer le trafic conversationnel avec des réponses rapides, inférieures à 30 secondes.Qwen/Qwen2.5-Coder-14B-Instruct-AWQ: Le modèle de codage de 14B abordé dans mes articles précédents, servi par vLLM sur le GPU. Ce niveau continue de descendre à zéro lorsqu'il est inactif.
Avant de plonger dans la logique de routage, il convient de mentionner que dans une configuration multi-niveaux, il est fortement recommandé de maintenir un flux d'authentification unifié. Par souci de simplicité pour cet article, les deux serveurs appliquent la même clé d'API en utilisant leurs mécanismes natifs (VLLM_API_KEY pour vLLM et LLAMA_API_KEY pour llama.cpp), les deux récupérant cette clé depuis le même secret Kubernetes.
Les composants
Trois composants centraux travaillent ensemble pour déterminer la destination de chaque requête :
- Envoy AI Gateway : Agissant comme le nouveau point d'entrée de la stack, chaque appel entrant arrive d'abord ici. Envoy peut soit router les requêtes directement en fonction du nom du modèle, soit s'en remettre à la décision d'un routeur externe.
- Le Petit Modèle CPU : Propulsé par
llama.cppservant Qwen 3 4B, ce composant est dédié à la gestion des charges de travail conversationnelles. - vLLM Semantic Router : Un classifieur qui analyse le prompt et détermine le modèle le plus approprié pour fournir la réponse. Basé sur un classifieur de sujets ModernBERT, il déduit le domaine du prompt (par exemple, l'informatique) et renvoie une décision de routage à Envoy.
Deux cas d'usage
Compagnon Agent de Codage : Mon assistant d'IDE, Cline, se connecte à la stack et épingle ses requêtes directement sur le modèle GPU, exactement comme configuré dans mes articles précédents. Épingler un nom de modèle spécifique contourne entièrement le processus de classification, permettant au routeur de transmettre la requête directement au niveau GPU.
Interface de Chat : Un frontend léger interagit avec la stack en utilisant trois modes disponibles :
qwen3-4b-cpu: Le modèle toujours actif et léger, réservé aux sujets de conversation quotidiens.Qwen/Qwen2.5-Coder-14B-Instruct-AWQ: Le modèle de codage lourd s'exécutant sur le GPU.auto: Dans ce mode, le prompt est évalué par le classifieur, permettant au routeur de sélectionner dynamiquement le modèle cible le plus approprié.
La mise à l'échelle à zéro fonctionne toujours
La stratégie de mise à l'échelle KEDA présentée précédemment reste totalement inchangée. La seule différence réside dans le chemin de la requête. Au lieu d'être interceptées directement par l'add-on HTTP de KEDA, les requêtes passent désormais d'abord par l'Envoy AI Gateway. La passerelle ne transfère le trafic à l'intercepteur KEDA que sous deux conditions :
- La requête cible explicitement le modèle GPU.
- Le routeur sémantique classe le prompt dans la catégorie informatique ou un autre domaine complexe similaire.
À partir de là, le cycle de vie reste identique :
- Si le GPU est suspendu, l'intercepteur retient la requête et demande au scaler de réveiller le nœud.
- Si le GPU est déjà actif, la requête est transmise immédiatement.
Après 300 secondes d'inactivité, le GPU redescend à zéro. Les seuls coûts d'infrastructure persistants sont le petit modèle CPU et le nœud système qui héberge la passerelle et le routeur.
Le modèle de repli est un choix stratégique
Le modèle par défaut est déclenché chaque fois qu'aucune règle de décision ne correspond au prompt. Vous devez considérer cela comme un mécanisme de repli et le sélectionner en fonction de vos priorités.
Si vous assignez le modèle CPU léger comme repli, les prompts complexes mal routés aboutiront à des réponses faibles ou superficielles, sacrifiant la qualité. À l'inverse, si vous vous appuyez sur le modèle GPU lourd, des prompts ambigus pourraient déclencher des réveils matériels inutiles, entraînant des coûts plus élevés.
Pour cette stack spécifique, j'ai désigné le modèle GPU comme solution de repli. Un faux positif qui réveille le GPU ne coûte que quelques centimes et un bref délai, tandis qu'un prompt complexe mal traité par un modèle plus petit peut générer un résultat trompeur qui semble correct. J'appelle cette approche le biais d'escalade (escalation bias), et chaque règle de décision peut être ajustée indépendamment pour moduler cet équilibre.
Configuration du routage
La logique de routage est définie de manière déclarative dans la configuration du routeur sémantique. Ce fichier dicte les domaines dont chaque modèle est responsable, ainsi qu'un modèle de repli par défaut lorsqu'aucune règle spécifique ne s'applique. J'ai configuré trois profils principaux :
code_agentic: Réservé aux tâches de codage agentique, similaires au trafic généré par Cline.technical_complex: Dédié aux sujets STEM difficiles en dehors du domaine standard de l'informatique.chat_casual: Utilisé pour les conversations quotidiennes et les connaissances générales, servi entièrement par le niveau CPU.
La configuration complète du routage est disponible dans le dépôt iheb24/vllm-gke.
Décisions du routeur sémantique
Les signaux sont cruciaux car ils aident à orienter les décisions du classifieur. La liste de mots-clés définie ci-dessus agit comme un filet de sécurité, captant la terminologie spécifique au code même lorsque le classifieur de sujets hallucine ou sélectionne le mauvais domaine. Par exemple, j'ai rencontré un scénario où un prompt traitant de migrations de base de données a été catégorisé par erreur sous "business" à cause de l'inclusion du mot "facturation". Heureusement, les mots-clés prédéfinis ont capté le contexte et redirigé avec succès le prompt vers le niveau GPU.
La classification est un travail d'ajustement continu
Bien que la classification par sujet soit exceptionnellement rapide et simple, elle n'évalue que le thème général d'un prompt. Cela conduit inévitablement à des faux positifs, comme un simple script "hello world" qui réveille inutilement le GPU. La fréquence de ces erreurs de classification dépend fortement de vos modèles de trafic et des réglages de configuration.
Dans un véritable environnement de production, s'appuyer uniquement sur ce classifieur ne suffirait pas. Il faudrait intégrer une télémétrie interne concernant vos charges de travail spécifiques et utiliser des classifieurs plus avancés, capables d'analyser l'intention sémantique profonde des prompts. Indépendamment de la complexité, le cycle de vie opérationnel reste le même : surveiller les décisions du routeur, identifier les motifs récurrents dans vos prompts, et affiner itérativement vos règles en fonction de l'utilisation réelle.
L'interface de démonstration
Les trois modes de routage sont accessibles via une interface utilisateur dédiée et minimaliste, et le comportement correspond parfaitement à notre configuration.
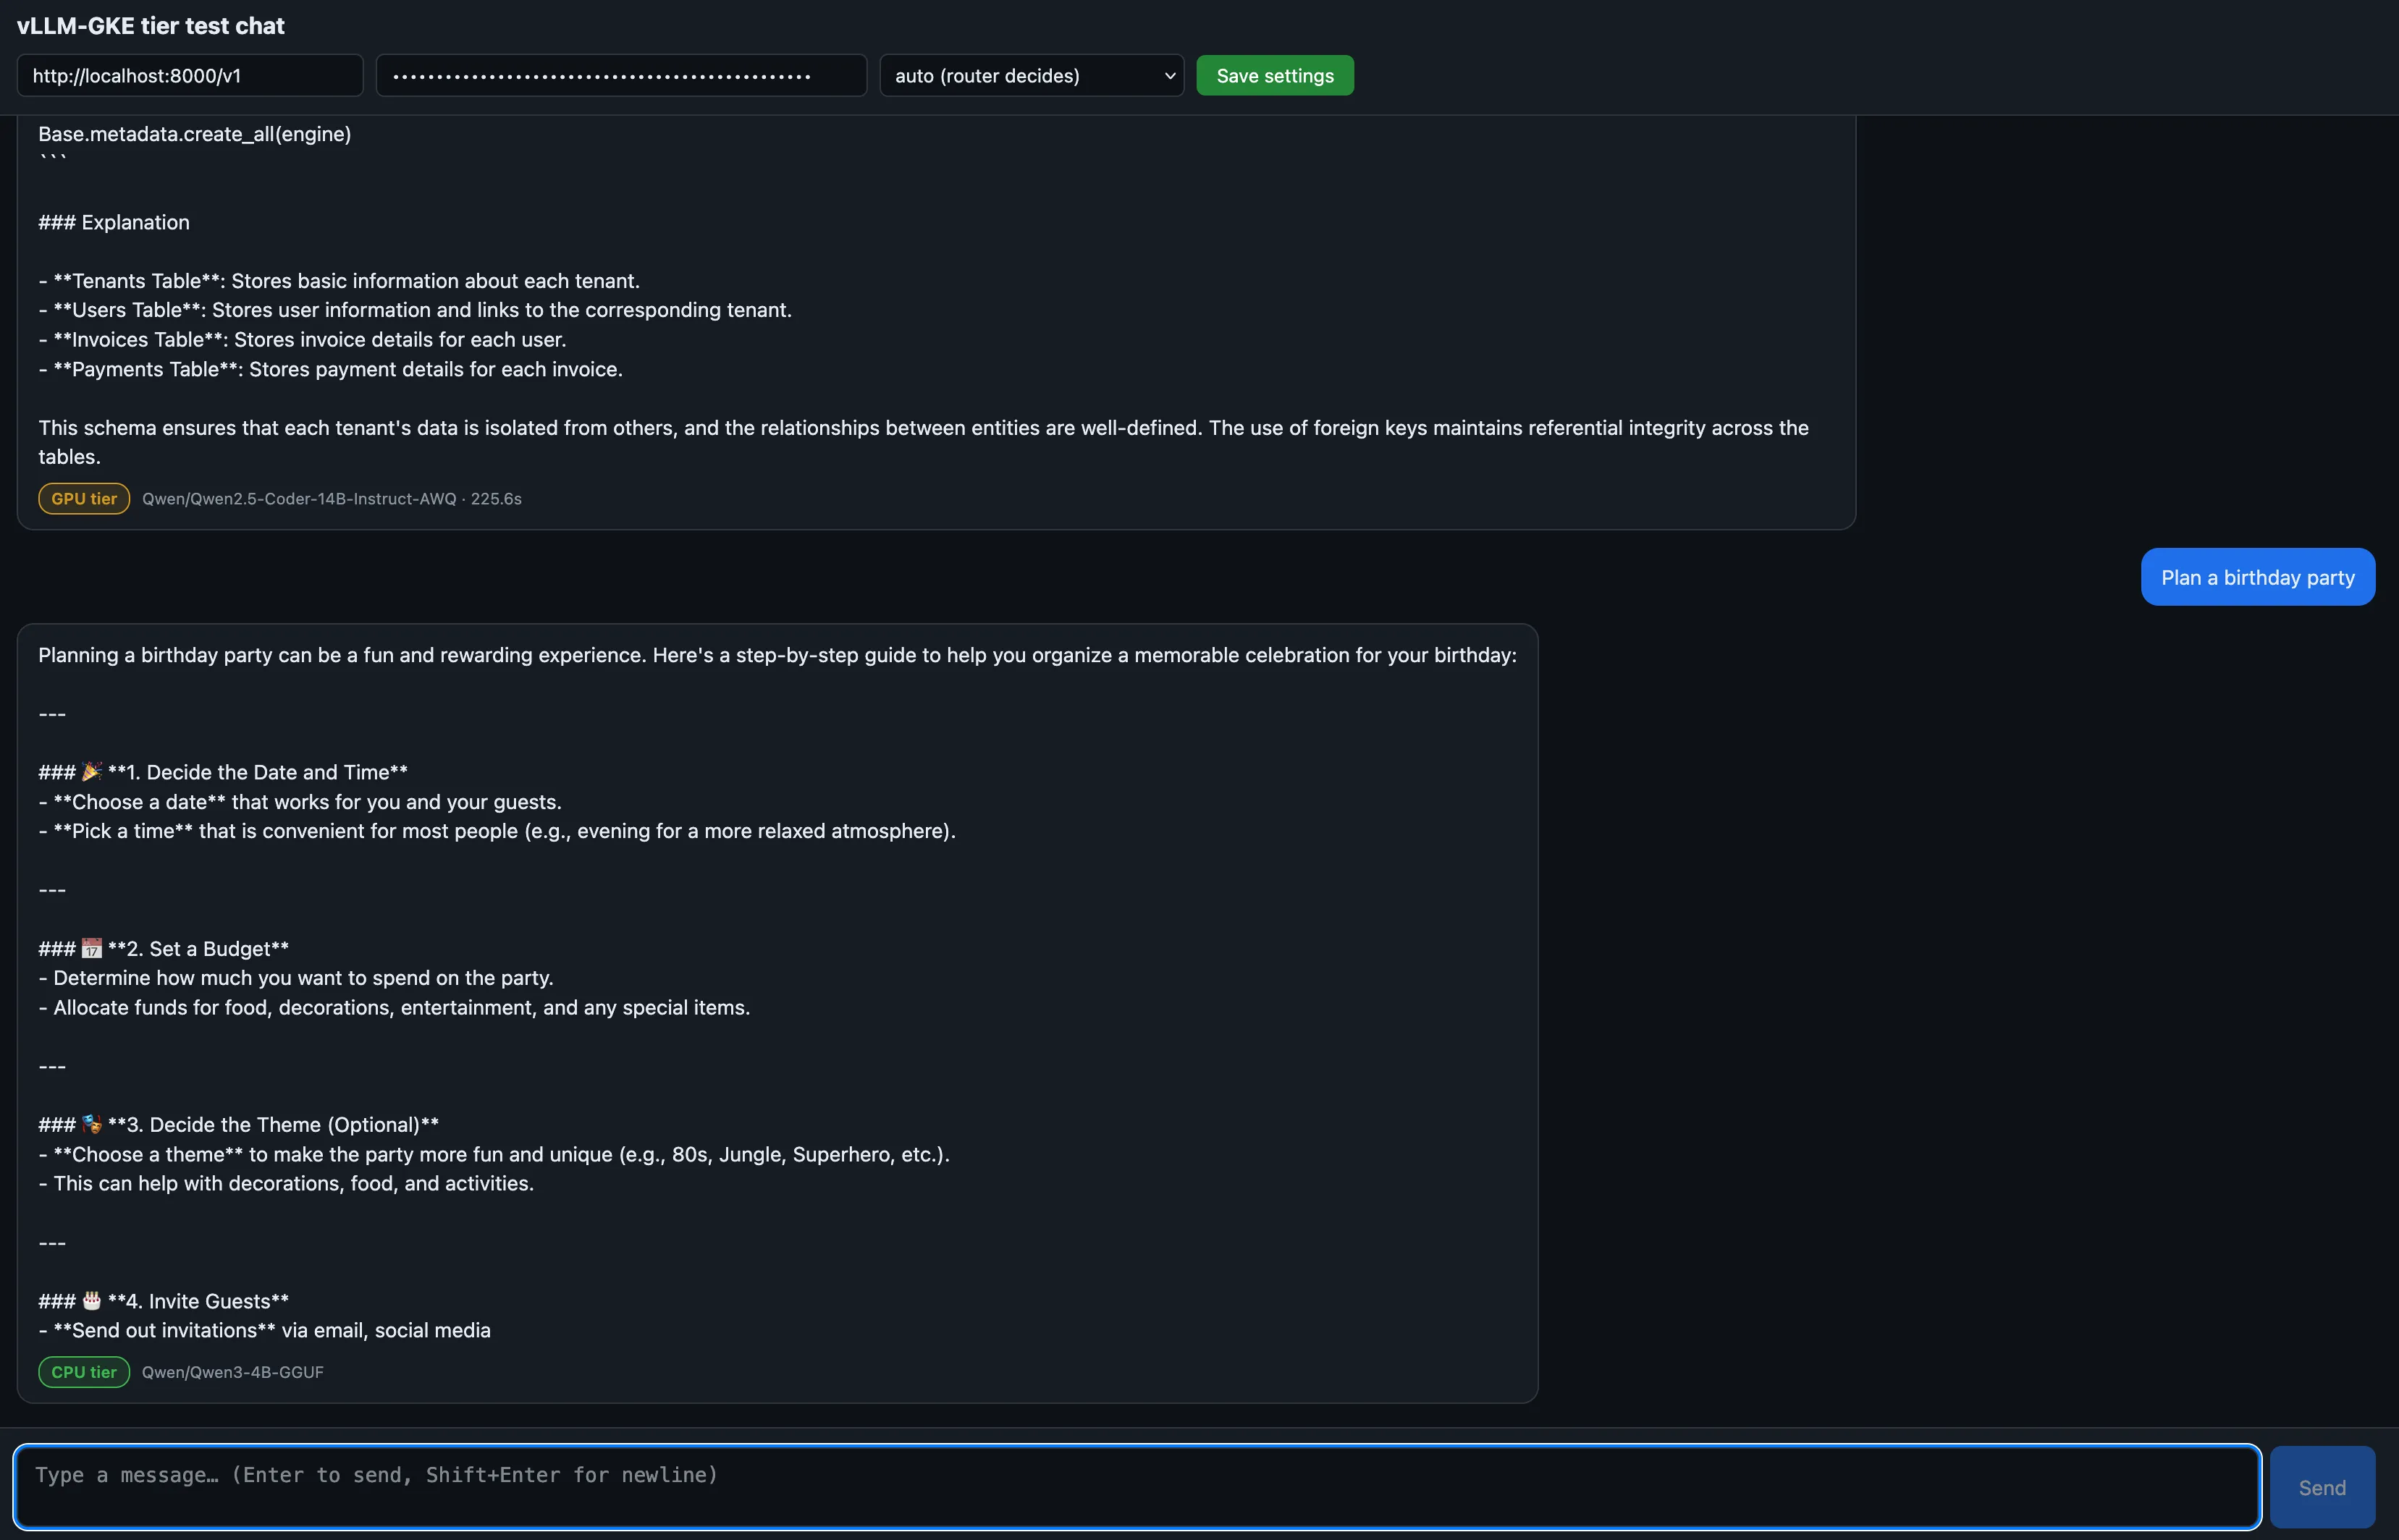
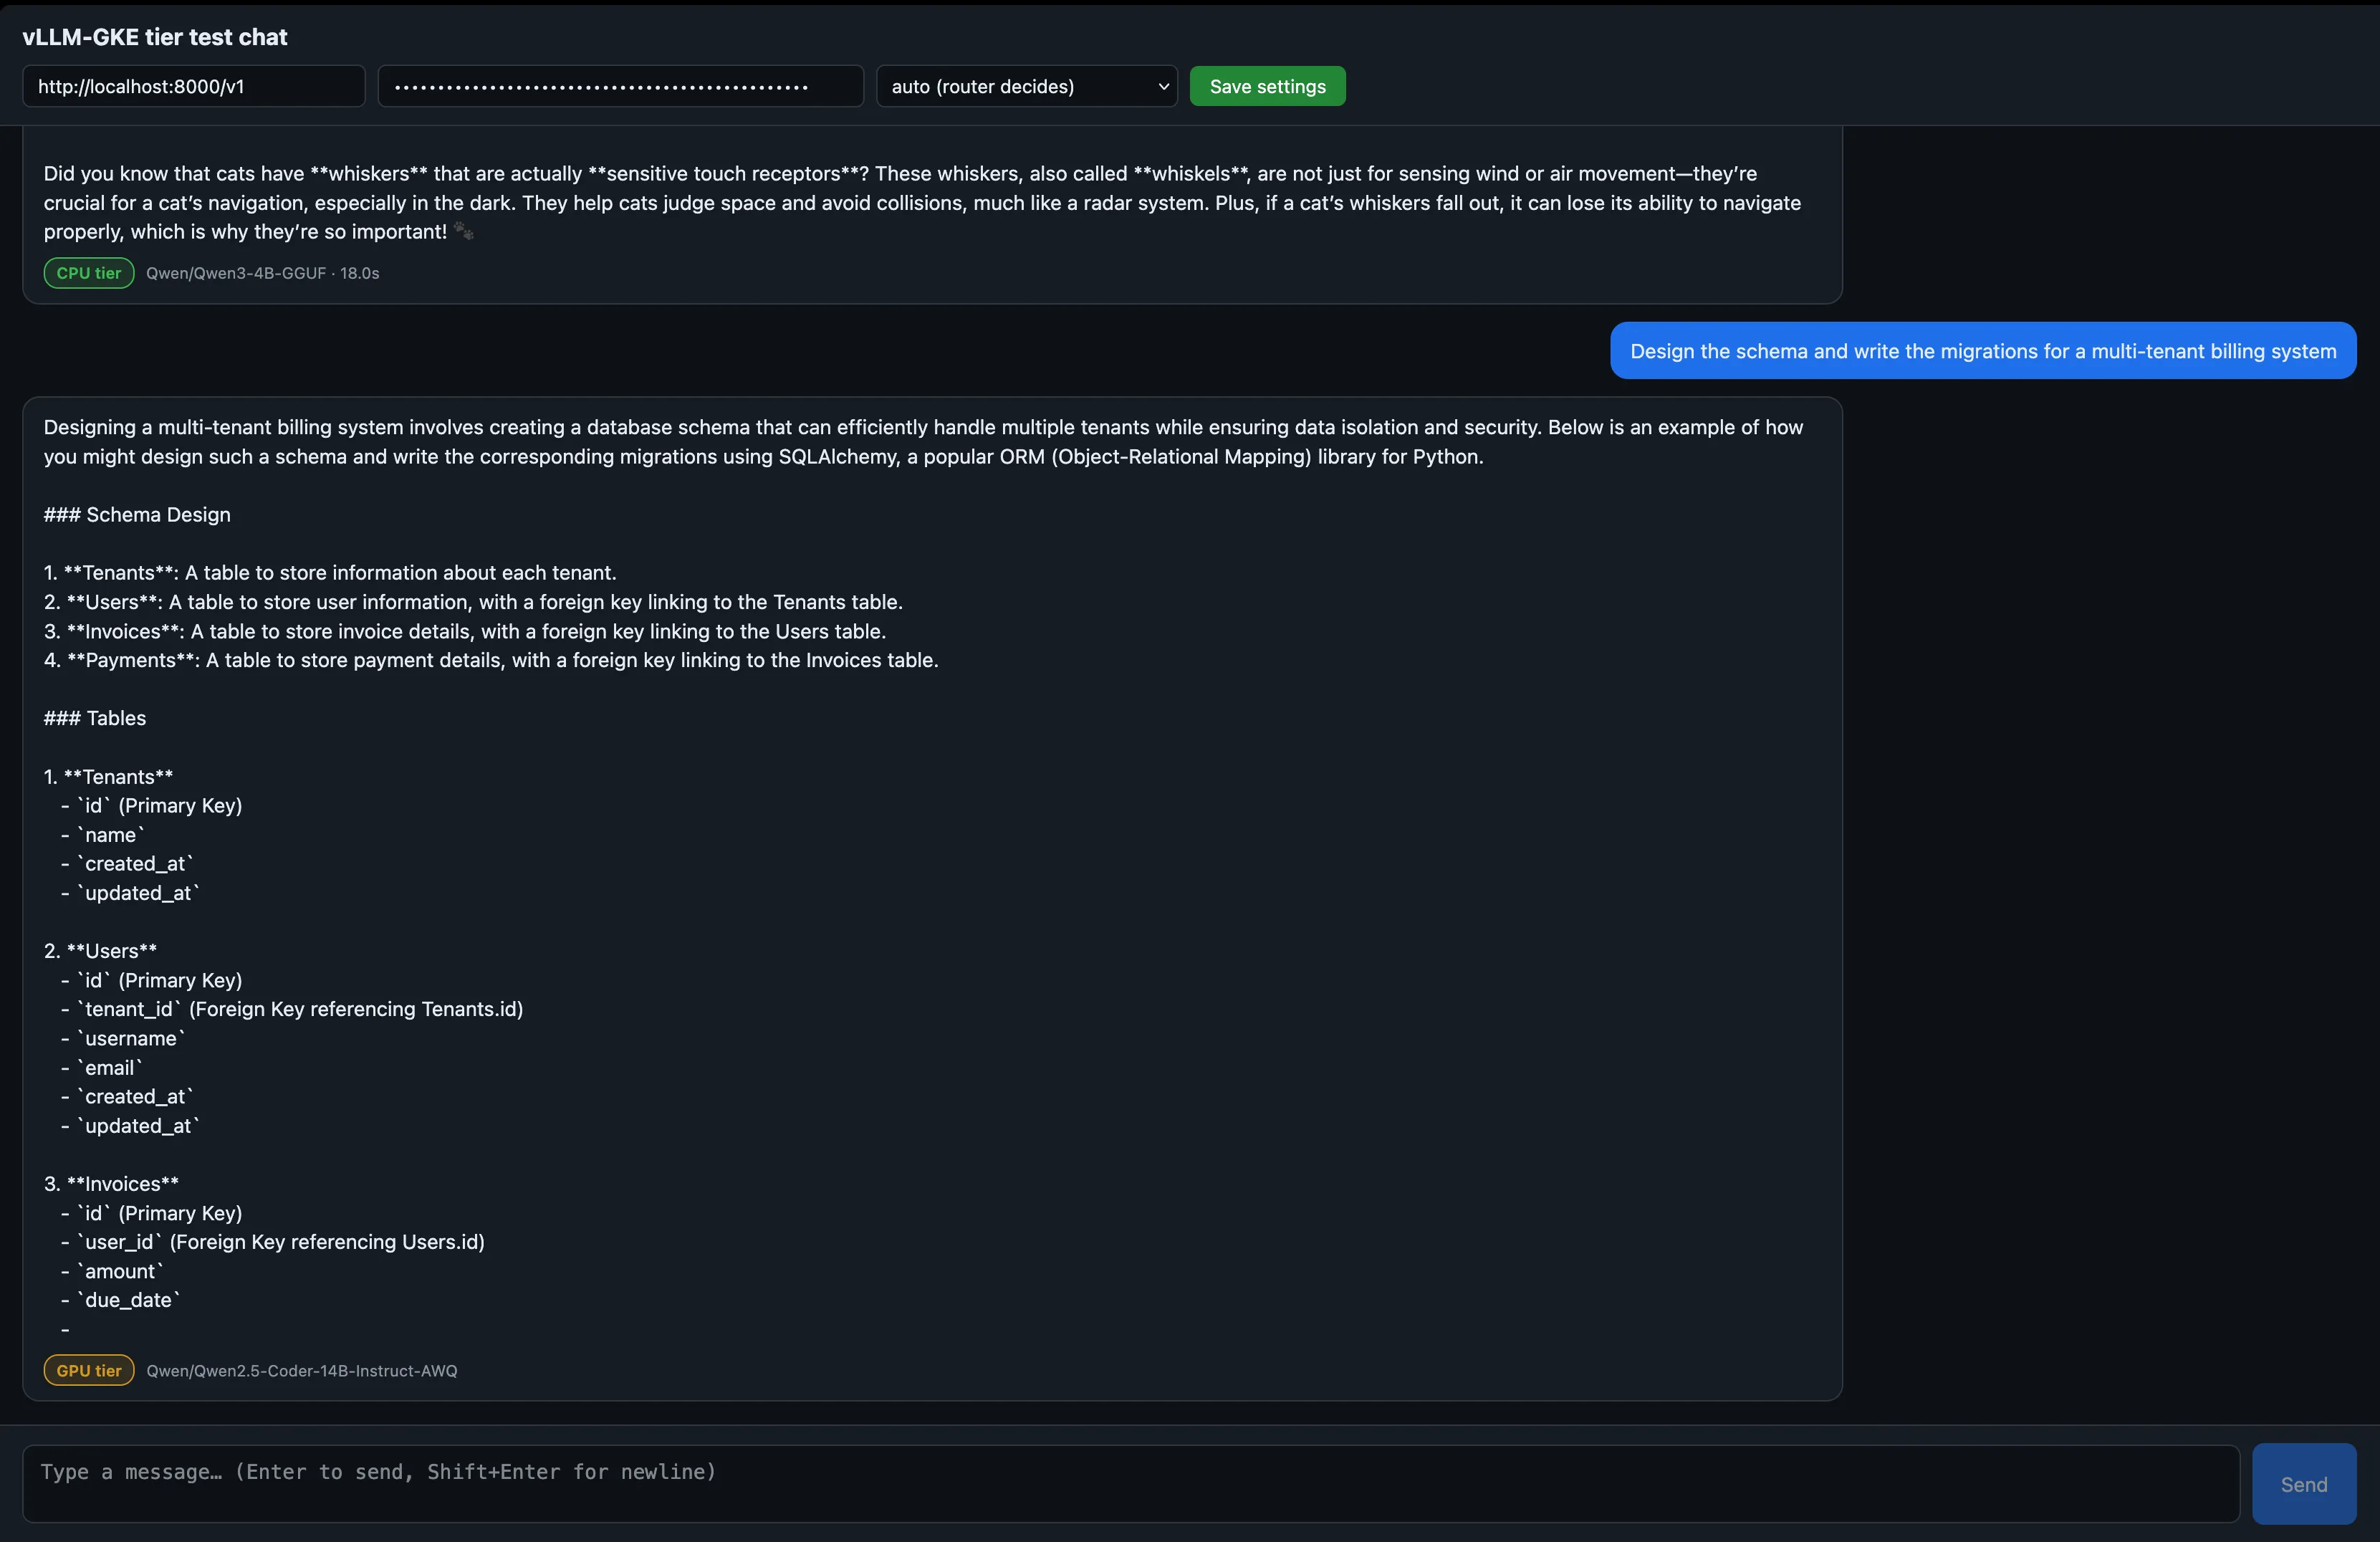
Lors de l'épinglage de modèles spécifiques, ils fonctionnent exactement comme prévu : le modèle 4B fournit des réponses rapides pour les requêtes simples, tandis que le modèle 14B subit un délai de démarrage à froid lors de sa première invocation avant de redescendre à zéro après une période d'inactivité de 300 secondes. Cependant, le véritable point fort est le mode auto. Puisque le classifieur évalue chaque message de manière indépendante, une seule session de chat peut alterner fluidement entre des réponses générées à la fois par les niveaux CPU et GPU. Il convient de noter que cela crée un défi d'affinité de session (session affinity) : alterner entre deux modèles distincts signifie qu'ils doivent tous deux analyser et traiter correctement l'historique de conversation partagé sans fragmentation du contexte.
Savoir quel modèle a répondu
L'interface est capable d'afficher exactement quel niveau a traité une requête car la stack rapporte de manière transparente ses décisions de routage dans la réponse. Cette information est disponible à partir de deux sources distinctes.
Premièrement, le routeur sémantique injecte des métadonnées spécifiques dans les en-têtes de réponse :
x-vsr-selected-model: Le modèle qui a été sélectionné, par exempleqwen3-4b-cpu.x-vsr-selected-decision: La règle qui s'est déclenchée, par exemplechat_casual.x-vsr-selected-confidence: Le score de confiance du classifieur.x-vsr-routing-latency-ms: Le temps pris par la classification, généralement sous une milliseconde pour les modèles épinglés et environ 100 ms pour ceux classifiés.
Deuxièmement, le champ model dans le corps de la réponse JSON indique explicitement le modèle backend sous-jacent (par ex., Qwen/Qwen3-4B-GGUF ou Qwen/Qwen2.5-Coder-14B-Instruct-AWQ). L'interface exploite ce champ pour badger dynamiquement chaque message avec le niveau exact qui a généré la réponse.
Essayez ce code localement en clonant le dépôt iheb24/vllm-gke.
Vérifier la décision de routage
Exemple de sortie :
En-têtes du routeur
Conclusion
En combinant une passerelle unique, un classifieur sémantique et un modèle CPU léger et toujours actif, la stack opère désormais avec succès sur deux niveaux distincts tout en préservant l'économie de la mise à l'échelle à zéro (scale-to-zero) de l'architecture d'origine. Le trafic occasionnel est géré de manière transparente sans jamais solliciter le GPU, tandis que les tâches de codage intensives bénéficient toujours de la pleine capacité du modèle 14B. La logique de routage reste purement pilotée par la configuration, s'améliorant continuellement au fur et à mesure que le trafic réel révèle exactement où chaque type de prompt doit aller.