RAG sur vllm-gke
Note : Cet article est la suite de Routage LLM multi-niveaux sur GKE. Le code source complet est disponible sur GitHub : iheb24/vllm-gke.
Un RAG simple et efficace. Nous voulions explorer en profondeur les pratiques RAG pour un assistant conversationnel, comprendre les composants impliqués, la façon dont ils communiquent entre eux, et quelles stratégies rendent un pipeline RAG réellement performant. Cet article est basé sur les recherches et les apports de Mohamed-Amine Bousahih, avec qui nous avons testé, observé et échangé ensemble.
L'objectif : ajouter une capacité RAG à ma stack vllm-gke, capable d'indexer des documents textuels dans plusieurs formats. Deux contraintes sont héritées des articles précédents. La mise à l'échelle à zéro (scale-to-zero) des GPU doit rester opérationnelle, et les connaissances récupérées doivent être utilisables à la fois par les niveaux CPU (SLM) et GPU.
Une note sur l'intention. Le thème du corpus m'importe peu, bien que ce fut un sujet brûlant ces dernières années. La valeur s'est déplacée vers la qualité de ce que l'on récupère. J'ai donc privilégié la qualité : un petit corpus de départ, une récupération mesurée, et seulement ensuite la permission de mettre le contenu à l'échelle.
D'abord, désapprendre trois choses
RAG signifie Retrieval-Augmented Generation (Génération Augmentée par la Recherche). Nous pensions qu'il s'agissait vraiment du contenu : choisir une base de données vectorielle, indexer des documents, et c'est tout. Nous avons aussi supposé intuitivement que l'agent interrogerait lui-même la base de données lorsqu'il aurait besoin d'informations. Nous avions tort sur les deux points, et nous sommes heureux d'avoir fait cette exploration, surtout en tant que praticiens non familiers avec toutes les pratiques RAG.
Le RAG n'est pas de l'entraînement, ni du fine-tuning. Le fine-tuning modifie les poids du modèle, et rien de plus n'est nécessaire au moment de l'exécution. Le RAG est l'opposé : les poids ne changent jamais. Des extraits de texte récupérés sont ajoutés au prompt comme contexte, et le modèle figé les lit lorsqu'il génère la réponse. C'est tout.
L'agent n'interroge pas la base de données. C'est un service de récupération qui s'en charge. L'utilisateur envoie une question à l'API de récupération, l'API vectorise (embed) la question et cherche dans la base de données vectorielle, puis elle envoie le prompt avec son contexte à la passerelle Envoy de l'article précédent sur le routage. Le modèle ne touche jamais à Qdrant.
Cet ordre n'était pas intuitif pour moi, mais il présente un réel avantage : le contexte récupéré est priorisé par rapport à ce que le modèle a mémorisé sur l'internet public. Les sources publiques peuvent contredire vos documents internes, les passages récupérés doivent donc primer, ce que le prompt système impose explicitement.
Architecture
Tout ce qui est nouveau réside dans un namespace rag dédié, sur son propre pool de nœuds CPU. La mise à l'échelle via KEDA reste exactement la même qu'auparavant, mais aucun composant RAG ne se met à l'échelle à zéro, et rien sur le chemin de la requête ne doit réveiller le GPU. Le prix de ce namespace est d'un nœud e2-standard-4, soit environ 50 $ par mois ajoutés à la base discutée dans l'article sur les coûts.
| Composant | Rôle |
|---|---|
| Qdrant (Helm, PVC) | Base de données vectorielle, stocke le corpus indexé dans la collection versionnée docs-v2 |
embed-tei | Serveur d'embeddings, Qwen3-Embedding-0.6B sur CPU, vectorise les documents lors de l'ingestion et les questions au moment de la requête |
rerank-tei | Ré-ordonnanceur (reranker) cross-encoder (bge-reranker-base), recalcule le score des candidats pour plus de précision |
| Ingestion CronJob | Lit un bucket GCS, analyse, découpe (splits), vectorise et insère (upserts) les documents, idempotent |
| Retrieval API (FastAPI) | /search, /chat, /metrics, le point d'entrée unique du pipeline |
| Prometheus + Grafana | Métriques auto-hébergées et tableau de bord pour le pipeline |
Stockage : Qdrant et recherche hybride
Le texte est converti en vecteurs à l'aide d'un modèle d'embedding, et les vecteurs sont comparés par distance. C'est la manière efficace de stocker et de récupérer des connaissances, car les modèles comprennent mieux les vecteurs et les distances que le texte brut. Au moment de la requête, le vecteur d'entrée est comparé aux vecteurs stockés dans la base de données.
Qdrant est le choix open-source populaire pour cela. Il stocke les connaissances ingérées dans une collection versionnée nommée docs-v2.
Chaque fragment (chunk) est stocké avec deux vecteurs, et ce mode hybride est la plus grande amélioration de la qualité de tout le projet :
- Vecteur dense (Dense vector) (1024 dimensions, distance cosinus). Capture le sens. "Pod keeps restarting" correspond à "CrashLoopBackOff troubleshooting" même sans aucun mot en commun.
- Vecteur creux (Sparse vector) (BM25 avec un modificateur IDF). Capture les tokens exacts. Codes d'erreur, noms de secrets, flags comme
invalid_upstream_jsonou--max-batch-tokens. C'est précisément là que la recherche vectorielle pure est la plus faible.
Au moment de la requête, les deux recherches s'exécutent en parallèle et Qdrant fusionne les deux classements côté serveur avec le Reciprocal Rank Fusion (RRF), sans avoir besoin de normaliser les scores.
Les vecteurs denses et creux sont créés dans ingest/ingest.py et fusionnés dans retrieval/main.py.
Les serveurs d'embeddings, et une règle stricte
Les vecteurs doivent être produits deux fois : lors de l'ingestion pour les documents, et au moment de la requête pour la question. Les deux côtés doivent utiliser le même modèle, sinon les distances ne veulent rien dire. Le modèle d'embedding est lié à l'index. Le changer implique de re-vectoriser l'ensemble vers une nouvelle collection versionnée.
Deux serveurs CPU tournent sous TEI (Text Embeddings Inference, par Hugging Face) :
embed-tei: Qwen3-Embedding-0.6B, servi via son export ONNX. Il a remporté un benchmark contre llama.cpp, l'histoire complète est dansbench/results.md.rerank-tei: un cross-encoder (bge-reranker-base). La recherche récupère d'abord 50 candidats, de manière rapide et approximative. Le reranker recalcule ensuite le score de chaque paire (question, passage) conjointement et conserve le top 5. Plus lent par paire, mais beaucoup plus précis.
Déployer le niveau d'embeddings
Ingestion
Les documents résident dans un bucket GCS dédié, lu via Workload Identity. Le job d'ingestion est un CronJob Kubernetes, également déclenchable manuellement. Un seul pipeline gère tous les formats :
Quelques détails à connaître :
- Les PDF, DOCX et PPTX passent par Docling, qui convertit tout en Markdown, il n'y a donc qu'un seul pipeline pour tous les formats.
- Chaque fragment (chunk) est préfixé avec son fichier et le chemin de l'en-tête. Cette astuce simple a valu environ 10 points de précision de recherche dans mon prototype.
- Les identifiants de points (Point IDs) sont déterministes (
uuid5defichier#index_du_chunk). Relancer le job sur les mêmes documents ne fait rien (no-op). Je l'ai vérifié en direct : deux exécutions consécutives, nombre de points identique.
Déployer et lancer l'ingestion
API et Service (Serving)
Un petit service FastAPI sert de porte d'entrée. Trois routes :
/search: exécute le pipeline de recherche complet (embed, recherche hybride, rerank) et retourne les passages classés avec leurs sources et scores./chat: même pipeline, puis construit le prompt (règles système plus passages étiquetés plus la question) et l'envoie à la passerelle Envoy. La passerelle route vers le niveau CPU ou GPU, exactement comme pour n'importe quelle autre requête de l'article précédent. La réponse revient avec des citations[source#chunk]. Si les passages ne répondent pas à la question, le modèle a pour instruction de dire que ce n'est pas couvert au lieu de deviner./metrics: métriques OpenTelemetry pour Prometheus, détaillées dans la section suivante.
Interroger les deux routes
Une vraie réponse de /chat ressemble à ceci, raccourcie pour plus de lisibilité :
Réponse
Une mise en garde honnête sur la vitesse : sur le niveau CPU, une réponse au chat prend environ deux minutes aujourd'hui. L'étape de rerank coûte la majeure partie du temps pré-LLM pour 50 candidats, et le modèle 4B lit le prompt augmenté à environ 25 tokens par seconde. C'est un compromis mesuré avec un paramètre d'ajustement clair (RERANK_CANDIDATES), pas un mystère. Pointer GATEWAY_MODEL vers le niveau GPU rend le même pipeline rapide à chaque fois que le GPU est chaud.
Mesurer la qualité au lieu de deviner
Vous ne pouvez pas optimiser ce que vous ne pouvez pas mesurer. Avant de régler quoi que ce soit, j'ai construit un ensemble de référence (golden set) de 46 questions sur le corpus de départ (les propres docs de ce repo), paraphrasées exprès, incluant des questions sur des identifiants exacts et des questions hors périmètre qui doivent être refusées. Le harnais de test dans eval/ calcule le hit@k et le MRR via /search, et chaque changement affectant la recherche devait les améliorer pour être conservé :
| Étape (Stage) | hit@1 | hit@5 | MRR | Verdict |
|---|---|---|---|---|
| Vecteurs denses uniquement | 0.62 | 0.95 | 0.76 | référence (baseline) |
| + Hybride BM25, fusion RRF | 0.86 | 1.00 | 0.92 | conservé |
| + Rerank cross-encoder (50 vers 5) | 0.90 | 1.00 | 0.95 | conservé |
Interrogé sur le repo lui-même, le système répond avec des citations des bons documents, et décline les questions que le corpus ne couvre pas ("quelle est la capitale de la France ?" obtient un score de 0.03 contre 0.5 ou plus pour les questions pertinentes).
Une lecture honnête de ces chiffres : un hit@5 de 1.00 ne prouve pas un pipeline parfait. Cela prouve surtout que mon ensemble de test est trop facile. Onze petits fichiers Markdown bien structurés avec des préfixes d'en-tête sont proches des conditions idéales, et 46 questions ne permettent pas de distinguer "parfait" de "très bon". Les erreurs apparaîtront lorsque le corpus grandira à des centaines de documents plus brouillons, et c'est exactement le moment où les améliorations repoussées à plus tard (la recherche contextuelle en particulier) deviendront mesurables au lieu de spéculatives.
Monitoring et Observabilité
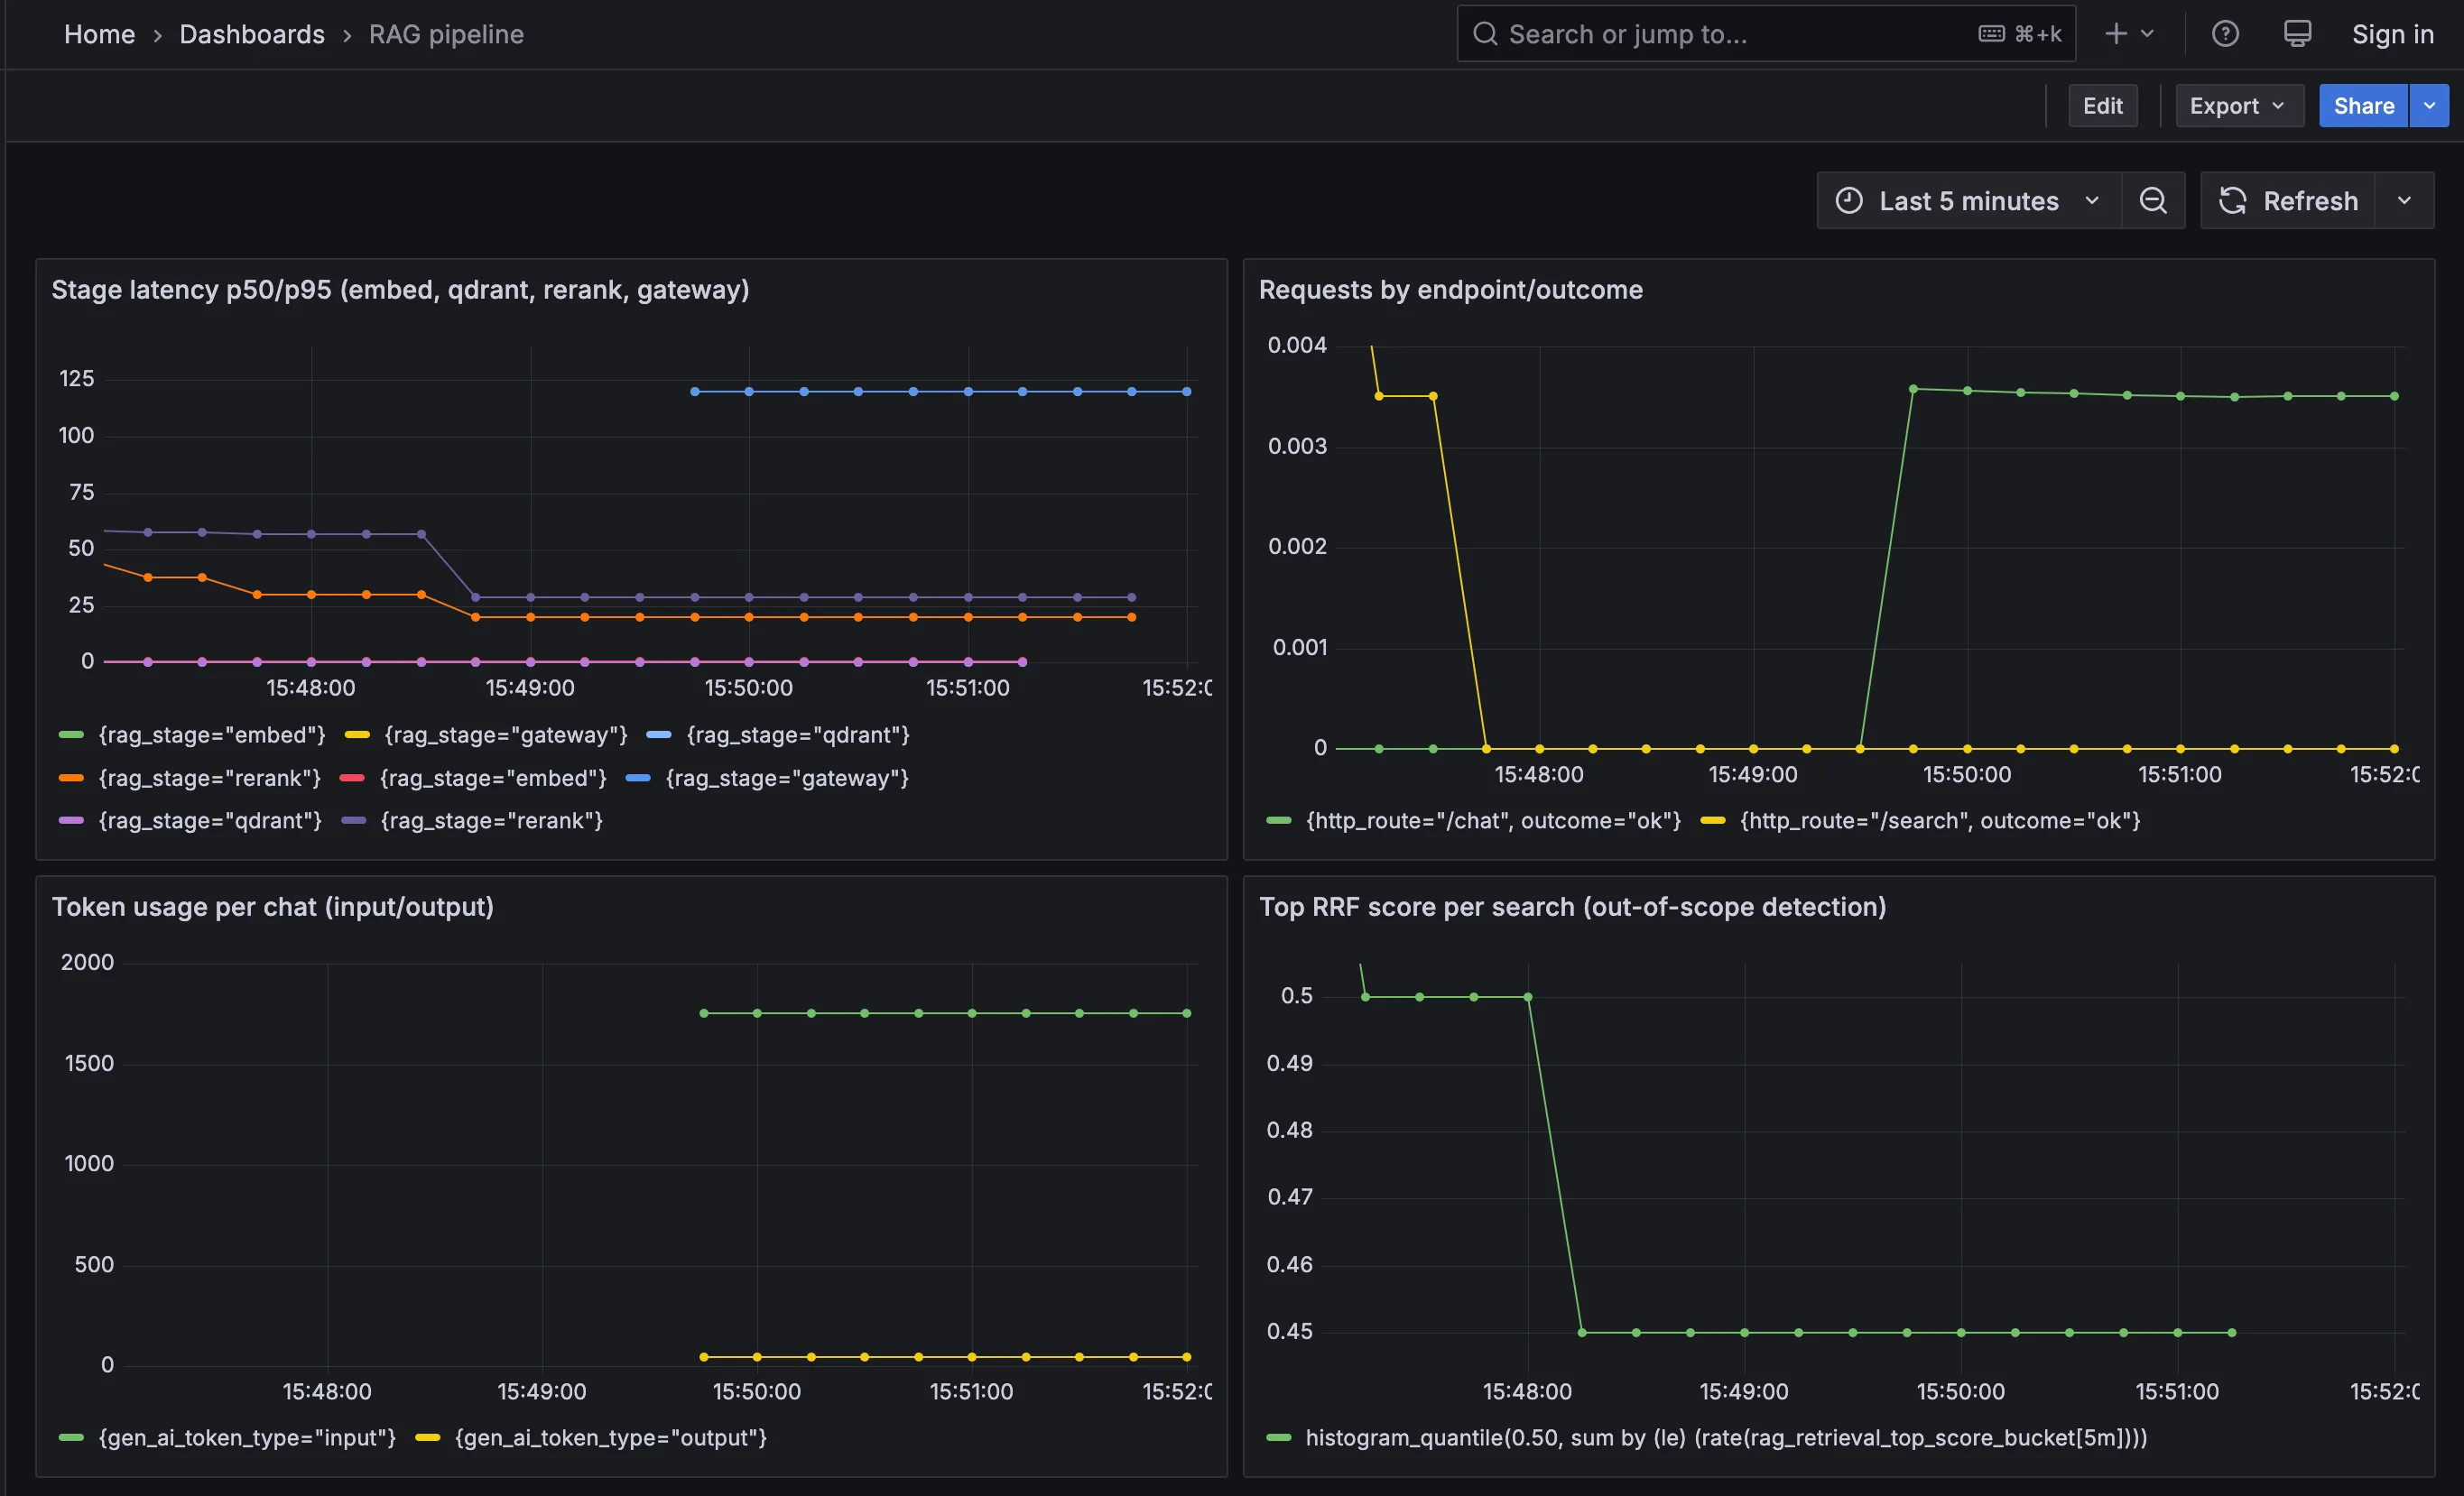
Le service de recherche émet des métriques OpenTelemetry en suivant les conventions sémantiques GenAI, collectées par un Prometheus auto-hébergé et affichées dans Grafana :
gen_ai.client.operation.duration: latence par appel au modèle (embed, rerank, chat completion)rag.retrieval.stage.duration: latence par étape du pipeline (embed, qdrant, rerank, gateway)gen_ai.client.token.usage: tokens d'entrée et de sortie par chatrag.retrieval.top_score: distribution des meilleurs scores de fusion, qui sépare les questions dans le périmètre (in-scope) de celles hors périmètre (out-of-scope)- Compteurs de requêtes par point de terminaison (endpoint) et par résultat
Le tableau de bord rend les leviers d'optimisation visibles : l'étape de rerank domine la latence pré-LLM avec 50 candidats, et l'étape de la passerelle montre la vitesse de traitement du prompt par le niveau CPU. Les deux sont des paramètres ajustables, pas des mystères.
Déployer la stack d'observabilité
Ce qui a cassé en cours de route
Les schémas bien propres cachent le fait que la majeure partie du temps de conception a été consacrée aux échecs. Voici la liste honnête, car c'est la partie que nous aurions voulu lire avant de commencer :
- TEI ne démarrait pas, peu importe la limite de mémoire. Son backend par défaut (candle) était tué par OOM (Out Of Memory) lors du préchauffage du modèle à 2, 3, 4 et même 6 Gi. La solution n'était pas plus de RAM, mais un backend différent (ONNX Runtime), un mode de pooling explicite (
--pooling last-token, l'export ONNX ne fournit pas de configuration de pooling), et un petit--max-batch-tokens, car la mémoire de préchauffage augmente avec cette valeur. Une taille de batch plus grande rejetait également les requêtes en masse avec un HTTP 422 jusqu'à ce que--max-client-batch-sizesoit augmenté. - llama.cpp était bizarrement lent. Il a répondu à une requête d'embedding de 4 tokens en environ 3.3 secondes, sur un nœud inactif, avec ou sans limites de CPU. Nous n'avons jamais complètement expliqué ce chiffre, et nous n'en avons pas eu besoin : TEI était six fois plus rapide, le benchmark a donc choisi le vainqueur et llama.cpp a été supprimé. Les benchmarks existent précisément pour que vous n'ayez pas à déboguer chaque mystère.
- La taille de nœud prévue était erronée. Le pool e2-standard-2, optimisé pour les coûts, ne pouvait héberger aucun des serveurs d'embeddings dans les configurations que nous avons essayées. Le pool est passé à e2-standard-4, soit environ 50 $ de plus par mois. Le plan initial supposait également que 2 Gi seraient suffisants pour un serveur d'embeddings. Ce n'était pas le cas.
- Nos propres budgets de latence étaient des chimères. Nous avions écrit "un lot de 100 chunks en moins de 5 secondes" dans le plan. Un modèle de 0.6B sur des cœurs e2 partagés traite environ 180 tokens par seconde, ce lot prend donc des minutes, pas des secondes. Le budget du chemin de requête (un embedding court en moins de 100 ms) a atterri à environ 110 ms et nous l'avons accepté. Les budgets sont aussi des hypothèses ; écrivez-les, puis laissez les mesures les corriger.
- Google Managed Prometheus n'a rien exporté, en silence. Le scraping fonctionnait, la configuration était correcte, et pourtant aucune métrique n'a atteint Cloud Monitoring, pas même les métriques natives de GKE, même après avoir corrigé une véritable lacune IAM sur le compte de service du nœud. Au lieu de perdre plus de temps dans une boîte noire de la plateforme, nous avons auto-hébergé un Prometheus standard dans le namespace et j'ai eu des tableaux de bord fonctionnels dans l'heure. La question de GMP reste ouverte comme un problème de plateforme à revoir.
Architecture Globale
Le namespace rag se trouve en amont de la stack. Les questions passent d'abord par l'API de recherche, et seul le prompt final (question plus contexte récupéré) atteint la passerelle Envoy, qui le traite ensuite avec les modèles hiérarchisés de l'article précédent.
Le guide de déploiement complet (runbook) se trouve dans k8s/rag/README.md, et la référence technique détaillée dans docs/rag-implementation.md.
Conclusion
L'ajout de ce namespace RAG s'aligne sur les meilleures pratiques de fin 2025 et 2026 : découpage (chunking) sensible à la structure, recherche hybride, reranking par cross-encoder, et évaluation en tant que métrique de premier plan. La qualité de la recherche l'emporte sur le volume de points de données, en particulier avec un petit corpus où chaque échec est visible.
Les pratiques évoluent encore, principalement vers des boucles orientées agents (agentic loops) où un planificateur décide quand et comment chercher, et vers un contexte plus riche par fragment (chunk). Ces évolutions sont prévues, pas ignorées : le harnais d'évaluation et la supervision (monitoring) sont déjà en place, donc chacune d'elles devra prouver sa valeur sur le même ensemble de référence (golden set) avant de gagner sa place dans la stack.
Et ensuite ?
Si vous souhaitez reproduire ce parcours d'apprentissage ou le prolonger, voici l'ordre que je suivrais. Chaque étape est petite, a un déclencheur clair, et enseigne une compétence distincte :
- Mettre le corpus à l'échelle, puis regarder l'évaluation casser. Déplacez quelques centaines de vrais documents dans le bucket, étendez l'ensemble de référence en même temps, et remesurez. C'est là que vous apprenez ce que coûte réellement le chunking, car le hit@5 va chuter et les modes de défaillance (tableaux coupés au milieu, fragments ambigus, collisions d'acronymes) deviendront enfin visibles.
- Recherche contextuelle, avec un objectif mesurable désormais. Un LLM écrit une phrase de contexte par chunk au moment de l'ingestion (Anthropic rapporte 35 à 67 % d'échecs de recherche en moins). Sur mon corpus actuel, il n'y avait pas de marge d'amélioration, cela a donc été reporté. Après l'étape 1, cela devient une vraie expérience avec un rapport avant et après, et cela vous enseigne l'utilisation des LLM au moment de l'ingestion sans toucher au chemin de requête.
- Recherche orientée agents (Agentic retrieval). Laissez un planificateur appeler le pipeline comme un outil (le serveur Qdrant MCP est l'entrée naturelle) au lieu de forcer chaque question à passer par la recherche. C'est le modèle de 2026, et il pose une vraie question de conception à laquelle je dois encore une réponse : comment cela devrait-il coexister avec le routeur sémantique, qui fait déjà une forme primitive de triage ?
- Coût par requête. Les métriques enregistrent déjà les tokens par chat et les heures de nœud sont connues. Le travail restant est arithmétique : le coût pour 1 000 requêtes, auto-hébergé contre un service RAG managé. Cet article achèvera la trilogie : qualité, latence, coût.
- Évaluation au niveau de la réponse. Mon harnais mesure la recherche, pas les réponses. Les métriques de style Ragas (fidélité, précision du contexte) comblent cette lacune, et les construire vous apprend d'où proviennent réellement les hallucinations lorsque la recherche est déjà correcte.
Le schéma derrière tout cela est la véritable leçon de ce projet : choisissez un changement, mesurez-le par rapport à un ensemble en lequel vous avez confiance, ne le gardez que si les chiffres bougent. Tout le reste n'est que de la décoration.