Mise à l'échelle de vLLM à zéro avec KEDA sur GKE
Dans l'article précédent, j'ai construit une pile Kubernetes de base sur GKE qui déploie vLLM sur un nœud GPU pour servir des modèles, et j'ai analysé en profondeur l'aspect tarifaire de cette stack. Les prix des instances Spot sont attractifs, mais leur disponibilité est très limitée.
Je veux que mon petit assistant de code coûte moins cher pour cette PoC. Sur les stacks de niveau entreprise, l'efficacité et le prix sont généralement les facteurs de décision.
Je pourrais détruire entièrement la stack à chaque fois, mais cela signifie attendre longtemps et tout reconfigurer à partir de zéro à chaque exécution.
Mettre à l'échelle le GPU à zéro tout en gardant le cluster actif est l'option la moins chère qui répond à cette contrainte. Ce n'est pas la plus simple : détruire la stack ou une simple mise à l'échelle programmée (scheduled scale-down) serait plus simple, et le prix à payer ici est une première requête lente. Mais le coût d'inactivité devient négligeable comparé à des pods GPU toujours allumés, et c'est honnêtement amusant à manipuler. L'implémentation complète se trouve sur mon dépôt public : iheb24/vllm-gke.
Le plan : KEDA et l'add-on HTTP
KEDA gère ce cas d'usage brillamment, et il est devenu le choix incontournable des développeurs pour les solutions d'entreprise et de production. KEDA est un autoscaler orienté événements (event-driven) : il agit sur des métriques externes plutôt que sur des ressources de calcul comme le CPU ou la mémoire, et il ne met à l'échelle que le nombre de pods. Il prend en charge des sources telles que :
- les files d'attente (queues)
- les tâches planifiées (cron)
- les systèmes de monitoring (Datadog / Prometheus)
- les bases de données
Sur ma simple stack à pod unique, je vais ajouter le scaling KEDA au cluster. Mon objectif est de mettre à l'échelle à zéro lorsque le pod n'est pas utilisé.
Une façon de mesurer l'utilisation est le nombre de requêtes entrantes. Je pourrais techniquement connecter une file d'attente à KEDA pour surveiller cela, mais les files d'attente classiques nous poussent vers un flux asynchrone. Il existe une option plus simple pour ce cas d'usage : le KEDA HTTP add-on. Il installe un intercepteur dans le cluster qui écoute et relaye toutes les requêtes entrantes, et il expose également les métriques de scaling, y compris le nombre de requêtes en attente.
L'intercepteur agit comme un proxy. Il transmet la requête à vLLM lorsque les pods sont prêts, ou la retient pendant que KEDA met à l'échelle le déploiement de zéro à un et que le cluster autoscaler provisionne un nœud GPU.
Ce que coûte un démarrage à froid (Cold start)
J'ai implémenté cette stratégie sur le dépôt afin de pouvoir garder le cluster actif pendant plusieurs jours et démarrer l'assistant rapidement en cas de besoin. "Rapidement" est très relatif ici, car un modèle GPU ne se réveille pas instantanément.
Un démarrage à froid complet prend environ 4 minutes et se divise en cinq phases distinctes :
| Phase | Fenêtre de temps | Ce qui se passe |
|---|---|---|
| 1. Le déclencheur | 0 à 5s | La requête atteint le proxy KEDA. La file d'attente montre 1 requête en attente, donc KEDA indique à Kubernetes de mettre à l'échelle le déploiement vLLM de 0 à 1. Le pod est créé mais reste Pending, car aucune machine GPU n'existe. |
| 2. Provisionnement matériel | 0,5 à 2,5 min | Le délai le plus long. Le cluster autoscaler de GKE détecte le pod Pending et demande à l'API Compute Engine une nouvelle VM g2-standard-8. Google Cloud trouve de la capacité dans europe-west4-a, démarre la VM, installe les pilotes NVIDIA, configure le réseau et attache le nœud au cluster. |
| 3. Stockage et image | 2,5 à 3 min | Le pod est planifié. Le disque persistant de 50 Go avec les poids du modèle en cache est attaché à la nouvelle machine, et l'image massive vllm/vllm-openai est téléchargée. |
| 4. Chargement du modèle et VRAM | 3 à 4 min | Le conteneur démarre. vLLM lit le modèle Qwen de 14B depuis le disque et le copie via le bus PCIe dans la VRAM du L4, puis profile la VRAM restante pour la scinder en blocs de cache KV PagedAttention. Le serveur API démarre et la route /health passe au vert. |
| 5. La réponse | ~4 min | L'intercepteur voit le test de santé réussir, libère la requête qu'il retenait depuis 4 minutes et streame la réponse vers l'IDE. |
Une chose aide déjà beaucoup ici : un nœud froid téléchargerait normalement aussi le modèle, ce qui prend du temps. Nous avons résolu cela dans l'article précédent en ajoutant un disque persistant de 50 Go qui stocke les poids du modèle. Le disque est simplement détaché et ré-attaché entre les machines, ce qui est un énorme gain de temps.
Tous ces temps de réponse doivent être mesurés pour votre modèle spécifique, car ils façonnent la stratégie de mise à l'échelle pour votre cas d'usage. KEDA n'est qu'un "scaler". Il réagit aux métriques, mais nous sommes responsables de la stratégie, et la stratégie découle toujours des contraintes auxquelles nous faisons face.
Sur les stacks de niveau entreprise, la haute disponibilité est une nécessité. Étant donné que démarrer un pod peut prendre plusieurs minutes, la stratégie doit inclure des pods prêts inactifs (idle) pour répondre à la contrainte de disponibilité, puis se mettre à l'échelle en fonction des requêtes en attente et d'autres métriques. Pour un usage personnel, lancer une requête et attendre quelques minutes la première fois n'est pas vraiment un casse-tête, surtout compte tenu des économies que la mise à l'échelle à zéro (scale-to-zero) apporte.
Tout cela est configurable dans KEDA pour obtenir le comportement exact de mise à l'échelle souhaité. Il convient également de noter qu'un déploiement Kubernetes zonal réduit encore plus le coût de la stack pour un usage personnel.
| Composant | Entreprise (Régional, Toujours Allumé) | Personnel (Zonal, Scale-to-Zero) |
|---|---|---|
| GKE Control Plane | 73,00 $ (HA Régional) | 0,00 $ (Zonal Niveau Gratuit) |
| Nœuds Système | 147,00 $ (3x e2-standard-2) | 49,00 $ (1x e2-standard-2) |
| Nœud GPU (L4) | 600,00 $ (1x g2-standard-8, 24/7) | 0,00 $ (Mis à l'échelle à 0) |
| Stockage du Modèle | 2,50 $ (Disque Persistant 50 Go) | 2,50 $ (Disque Persistant 50 Go) |
| Coût d'Inactivité Total | ~822,50 $ / mois | ~51,50 $ / mois |
| Usage Actif (20 h) | (Inclus dans le coût de base) | 17,00 $ (~0,85 $ / h) |
| Facture Mensuelle Finale | ~822,50 $ | ~68,50 $ (91% d'Économies) |
Remarque : Les coûts d'inactivité personnels peuvent être davantage réduits à environ 15 $/mois en utilisant la tarification Spot pour le nœud système unique. La projection entreprise ci-dessus est basée sur la même stack, testée pendant quelques heures et extrapolée pour établir une base de référence mensuelle.
Pour quelques jours d'utilisation, c'est très significatif pour un usage personnel.
Changements d'implémentation
L'implémentation de cette stratégie sur le dépôt vllm-gke a nécessité quelques modifications. La première étape facile a été de passer les manifestes au format Helm pour une utilisation simplifiée.
Sur le cluster, un nouveau nœud est ajouté pour héberger KEDA et l'intercepteur. Dans les manifestes, plusieurs changements ont été apportés, en commençant par une "readiness probe" pour que Kubernetes sache quand vLLM est prêt, en se basant sur la route /health déjà exposée par le serveur.
readiness-probe.yaml
Cette route signale que le serveur vLLM est prêt. Le serveur peut toujours rencontrer des erreurs ou planter en cours d'exécution. Lorsque cette route renvoie 200 pour la première fois, Kubernetes sait que le pod est prêt et KEDA peut lui transmettre des requêtes. Techniquement, les premières requêtes que le serveur vLLM reçoit sont les tests de santé (health checks), avant que KEDA ne laisse passer le vrai trafic.
La mise à l'échelle à zéro s'effectue le mieux avec l'add-on KEDA HTTP. Les métriques Prometheus, les files d'attente, la mémoire et le CPU sont tous absents lorsqu'aucune machine n'est en marche, KEDA n'a donc aucun signal pour savoir quand réveiller le GPU. Avec l'add-on HTTP, nous déployons un HTTPScaledObject avec la configuration suivante. Nous mettons à l'échelle avec un maximum d'un seul GPU, et la période de refroidissement (cooldown) est de 5 minutes, basée sur les requêtes capturées par le proxy.
keda-scaledobject.yaml
En action
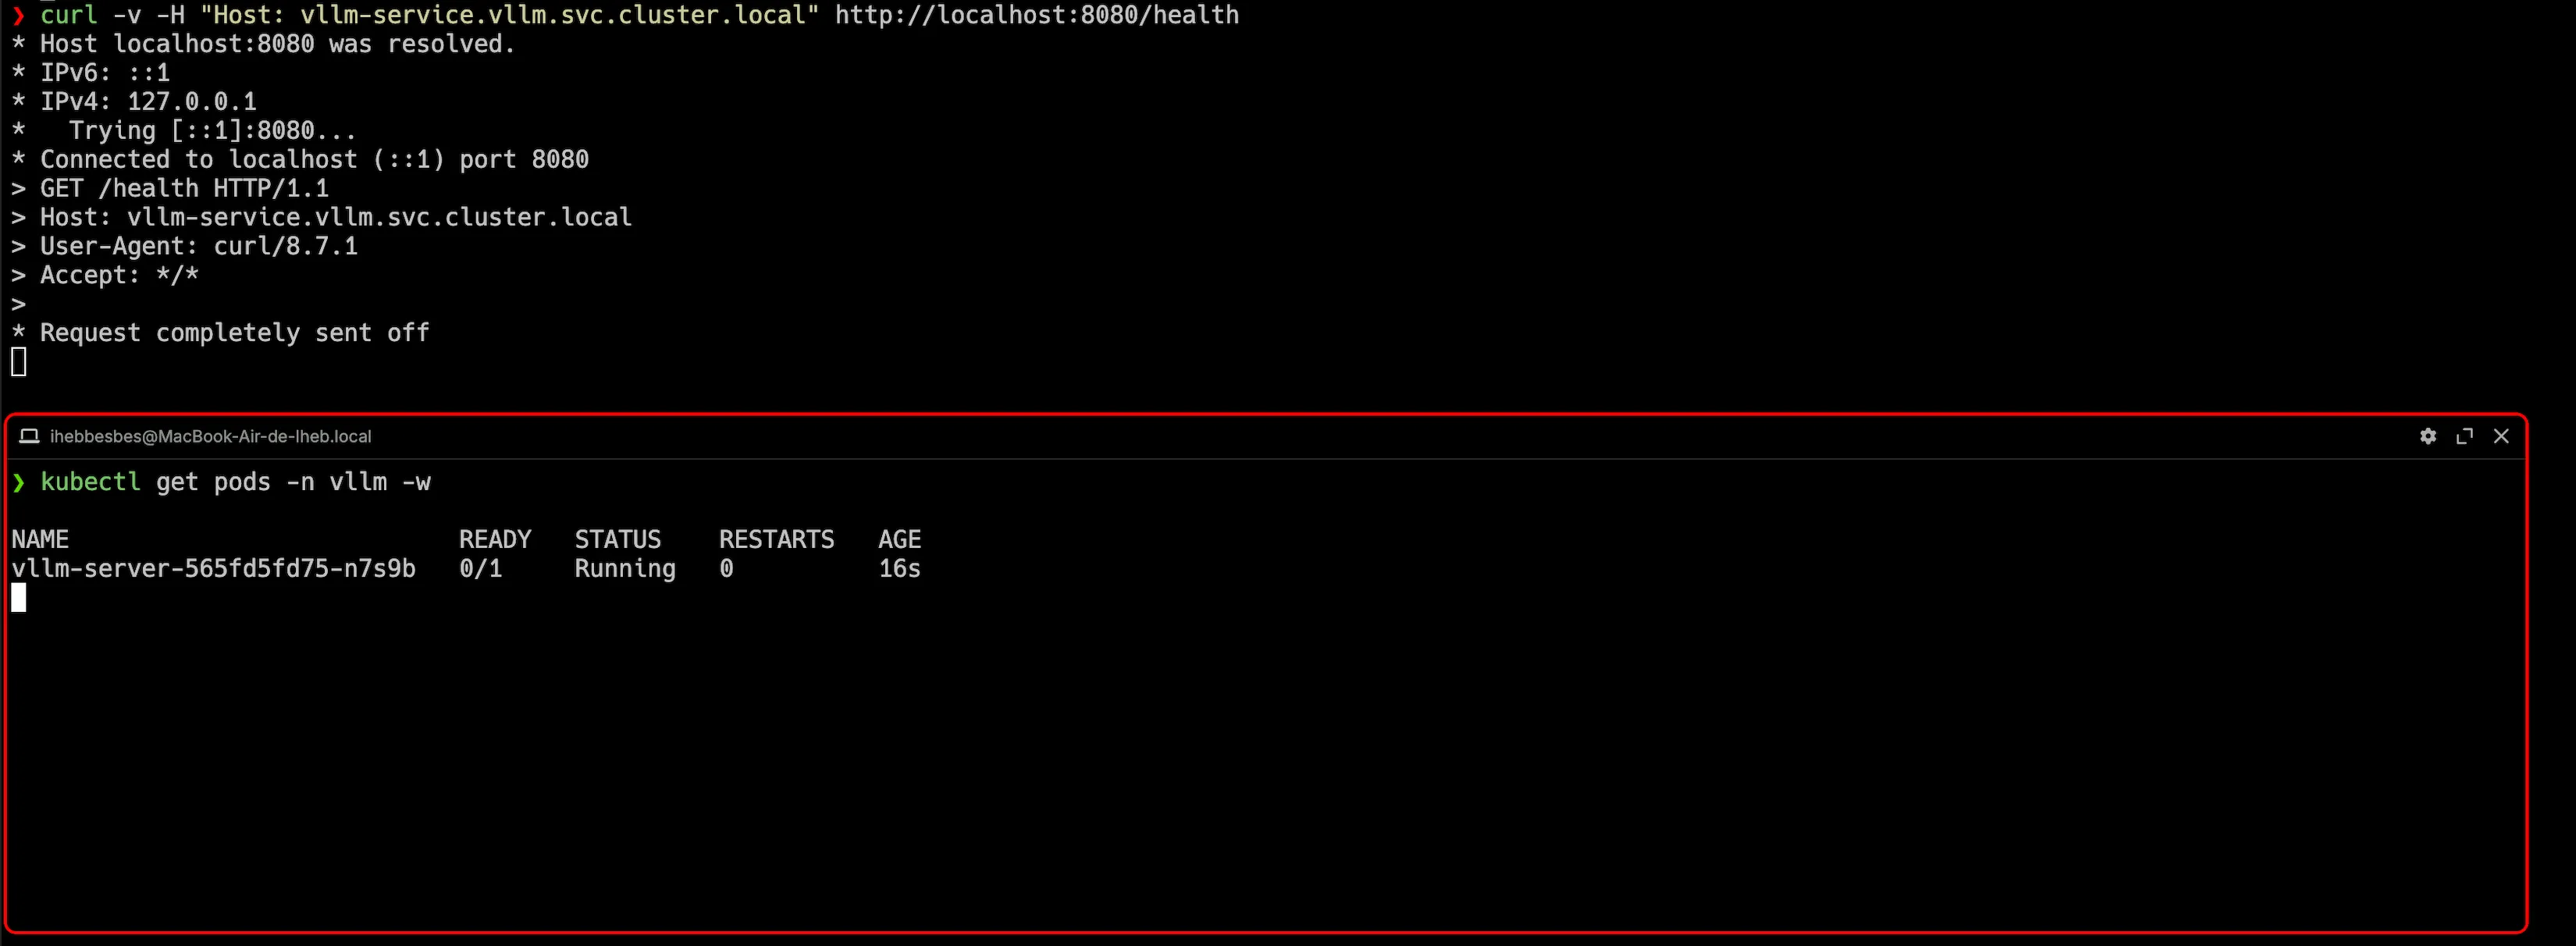
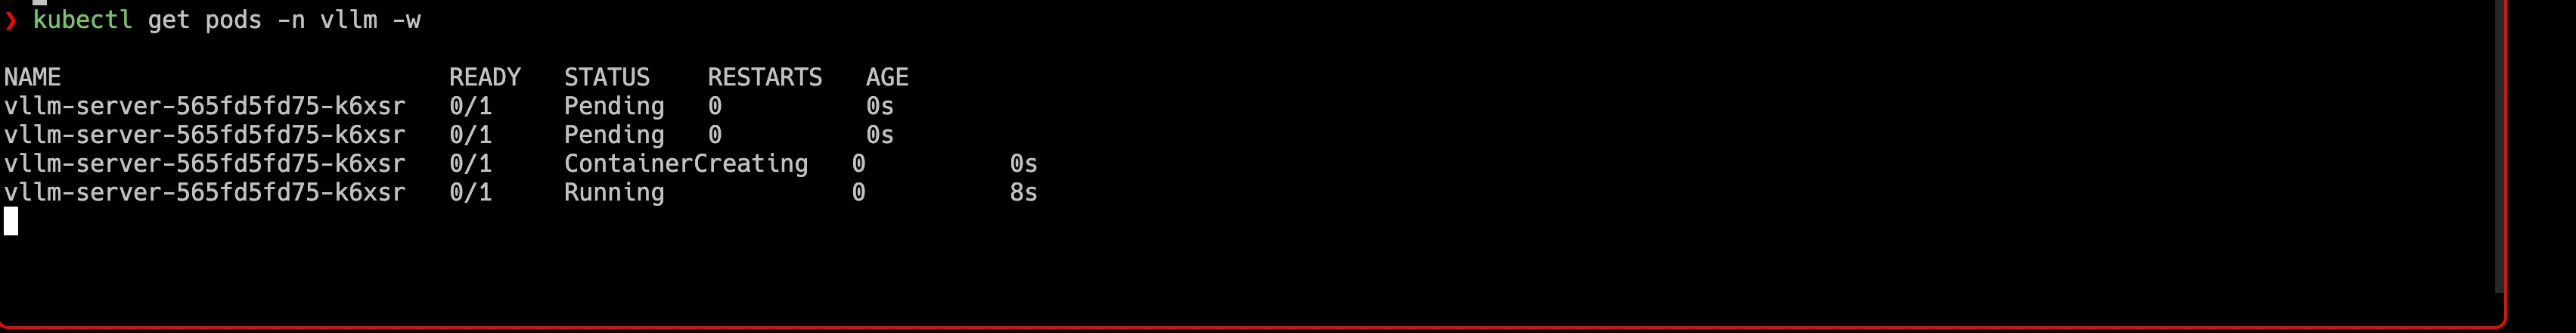
Le résultat est amusant à observer. Après avoir déployé le nouveau nœud KEDA et configuré l'IP, la clé API, ainsi que le proxy de port-forward comme décrit dans l'article précédent, j'ai commencé par envoyer une requête au cluster avec curl. L'appel est resté en attente. Immédiatement, on peut voir sur le nœud vLLM un nouveau pod en cours de provisionnement.
Après un petit moment, la machine devient prête. La route de santé a répondu 200, et l'appel curl a été livré environ 3 minutes plus tard, à peu près à une seconde d'intervalle, ce qui correspond aux phases de démarrage à froid vues ci-dessus. L'en-tête de réponse confirme que la machine sortait d'un démarrage à froid : X-Keda-Http-Cold-Start: True.
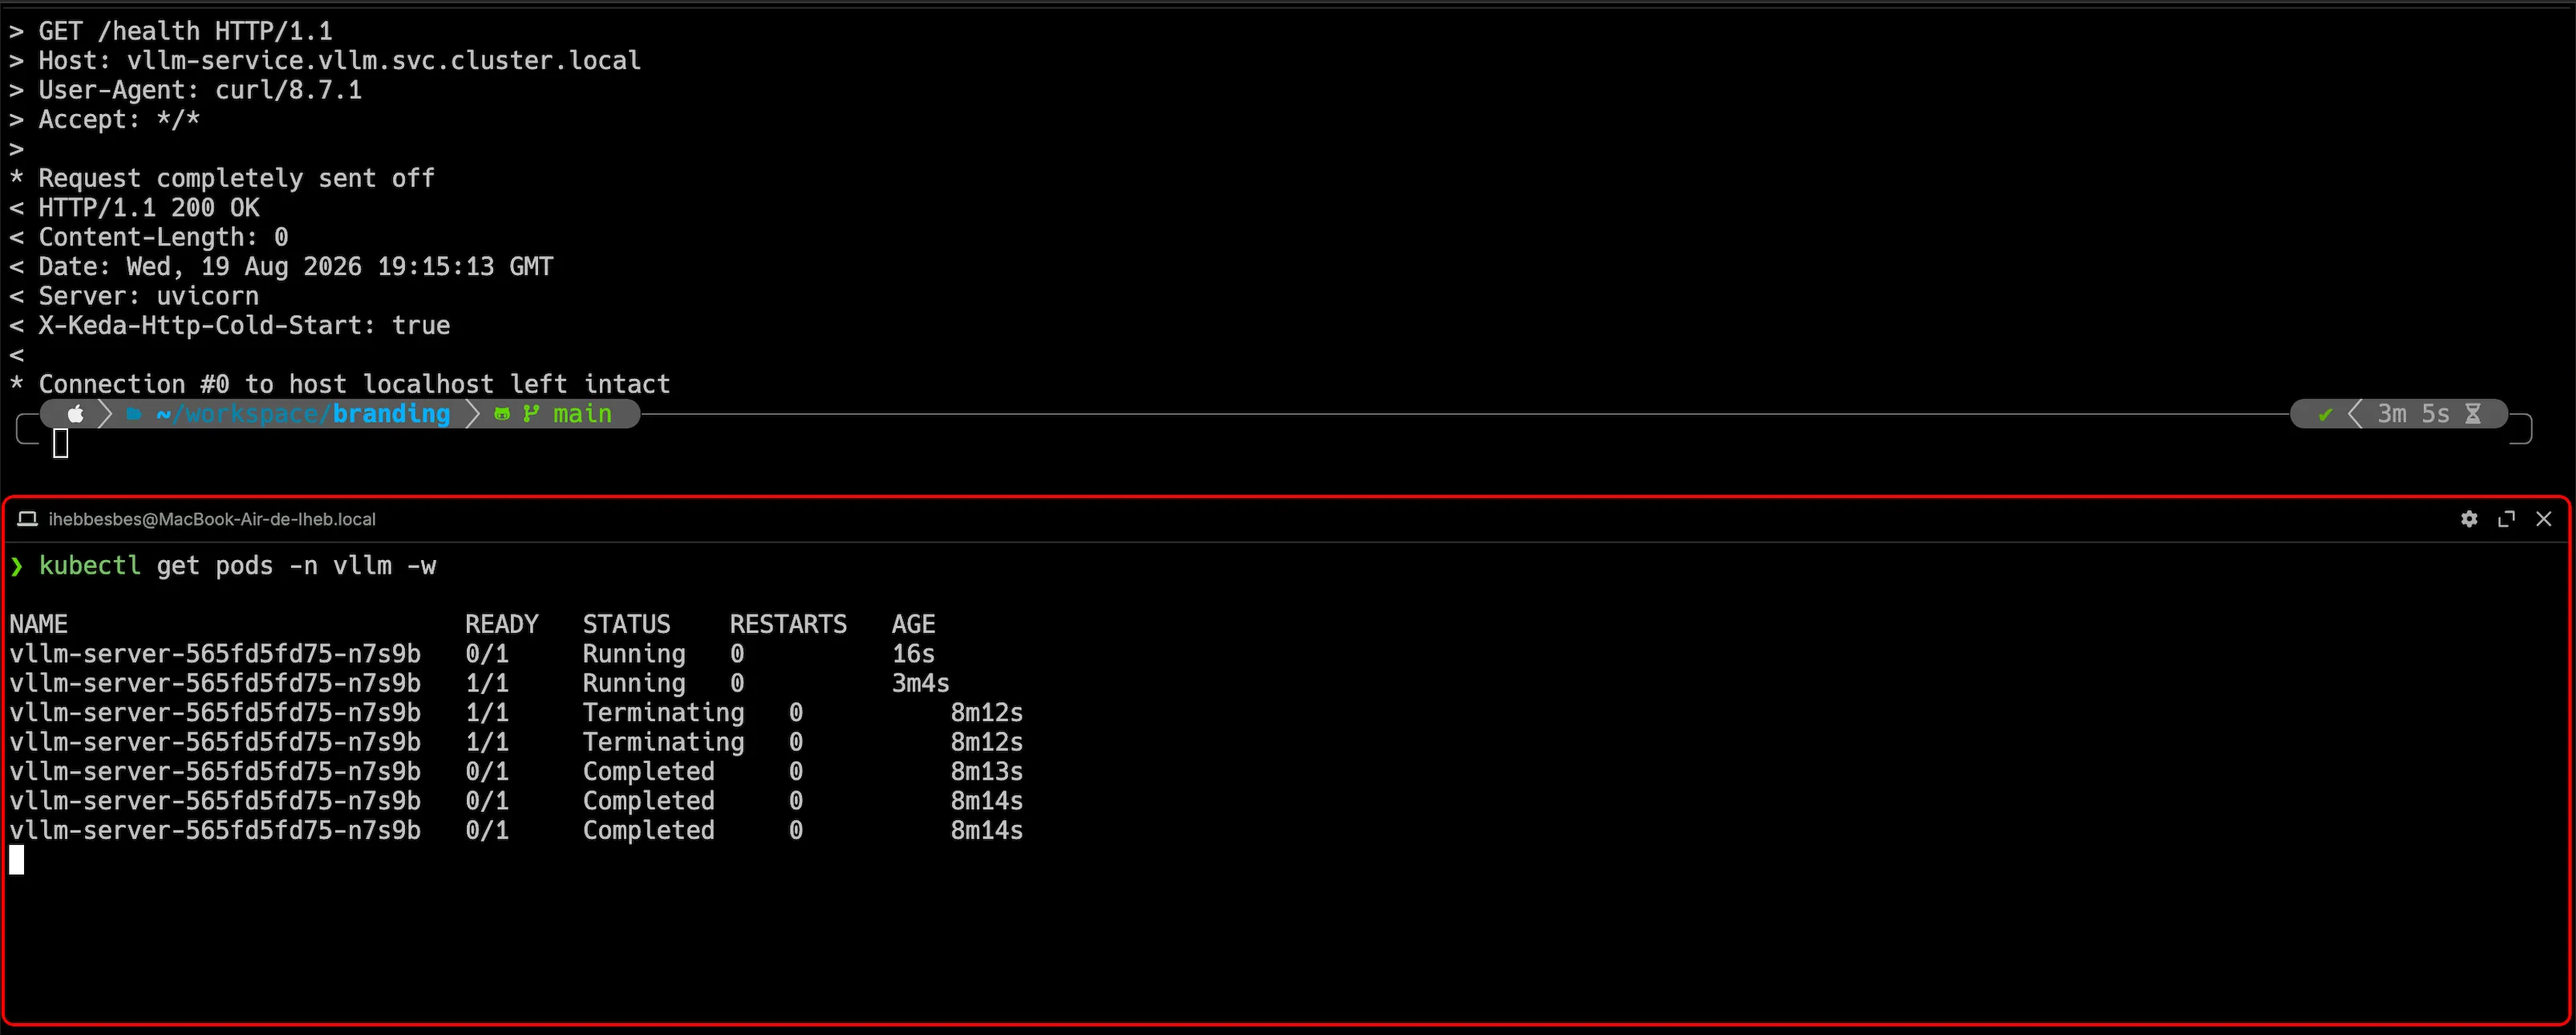
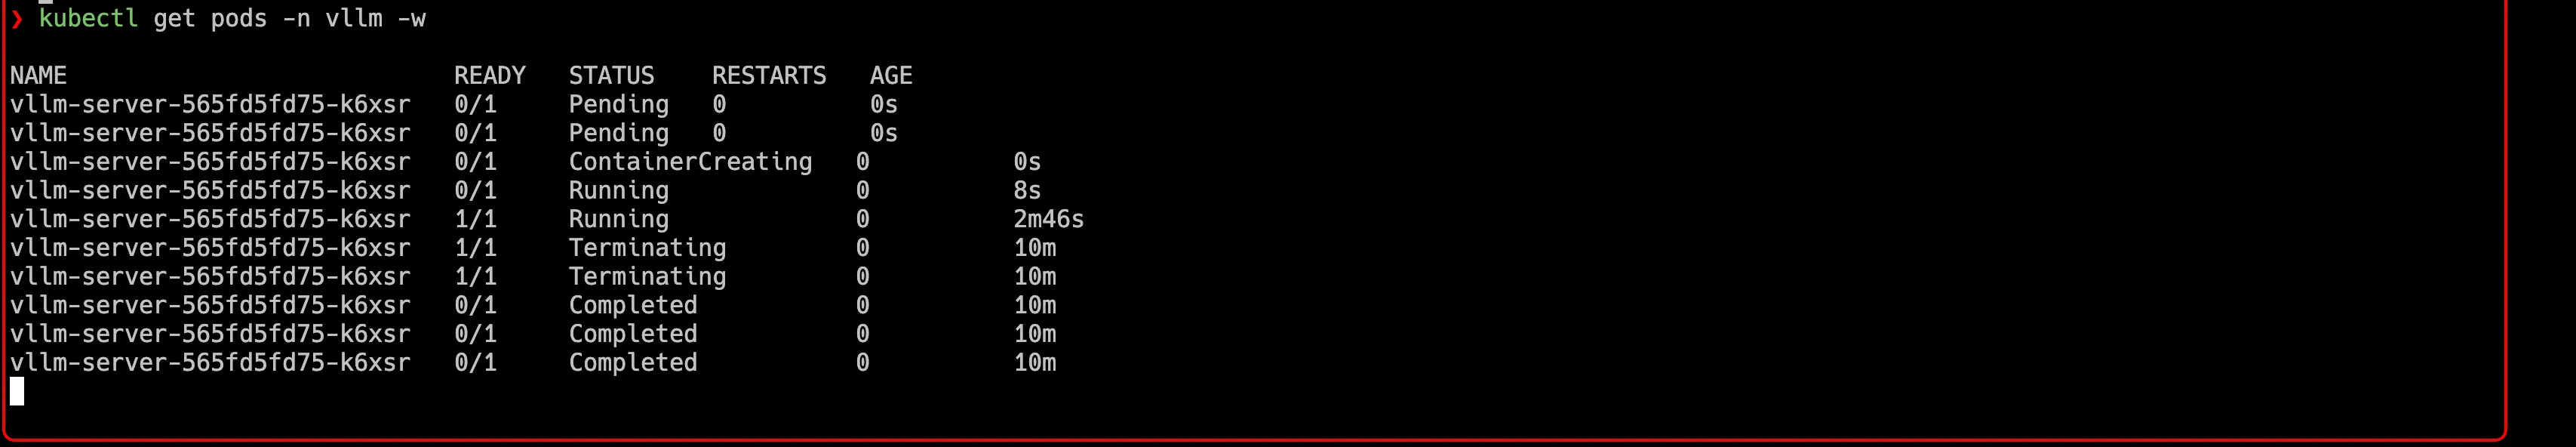
Après 5 minutes et 8 secondes, la machine a commencé à se terminer car aucune autre requête n'a été envoyée au GPU.
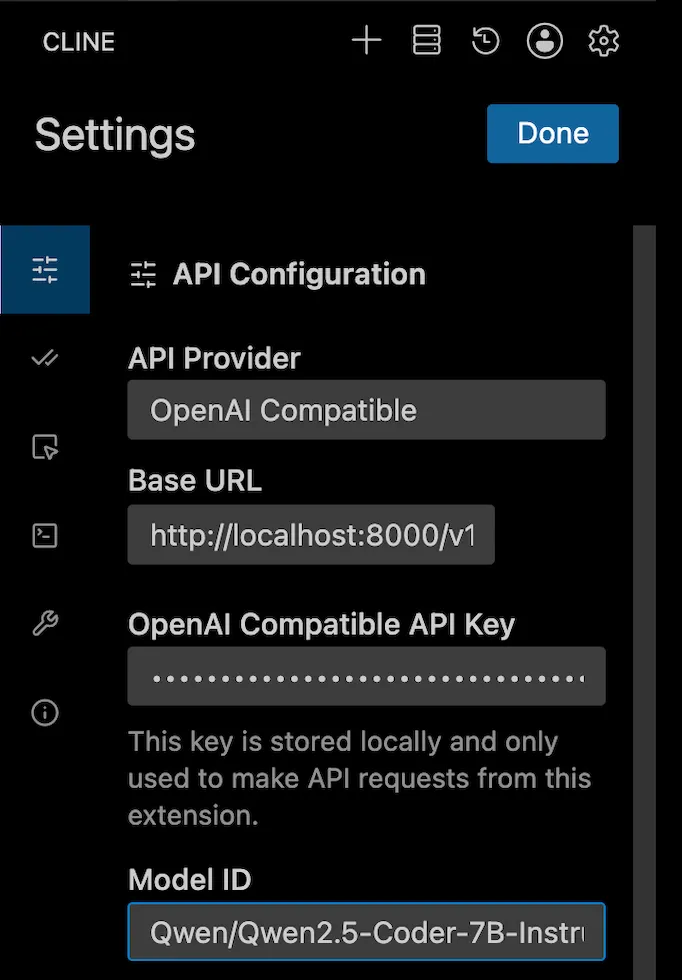
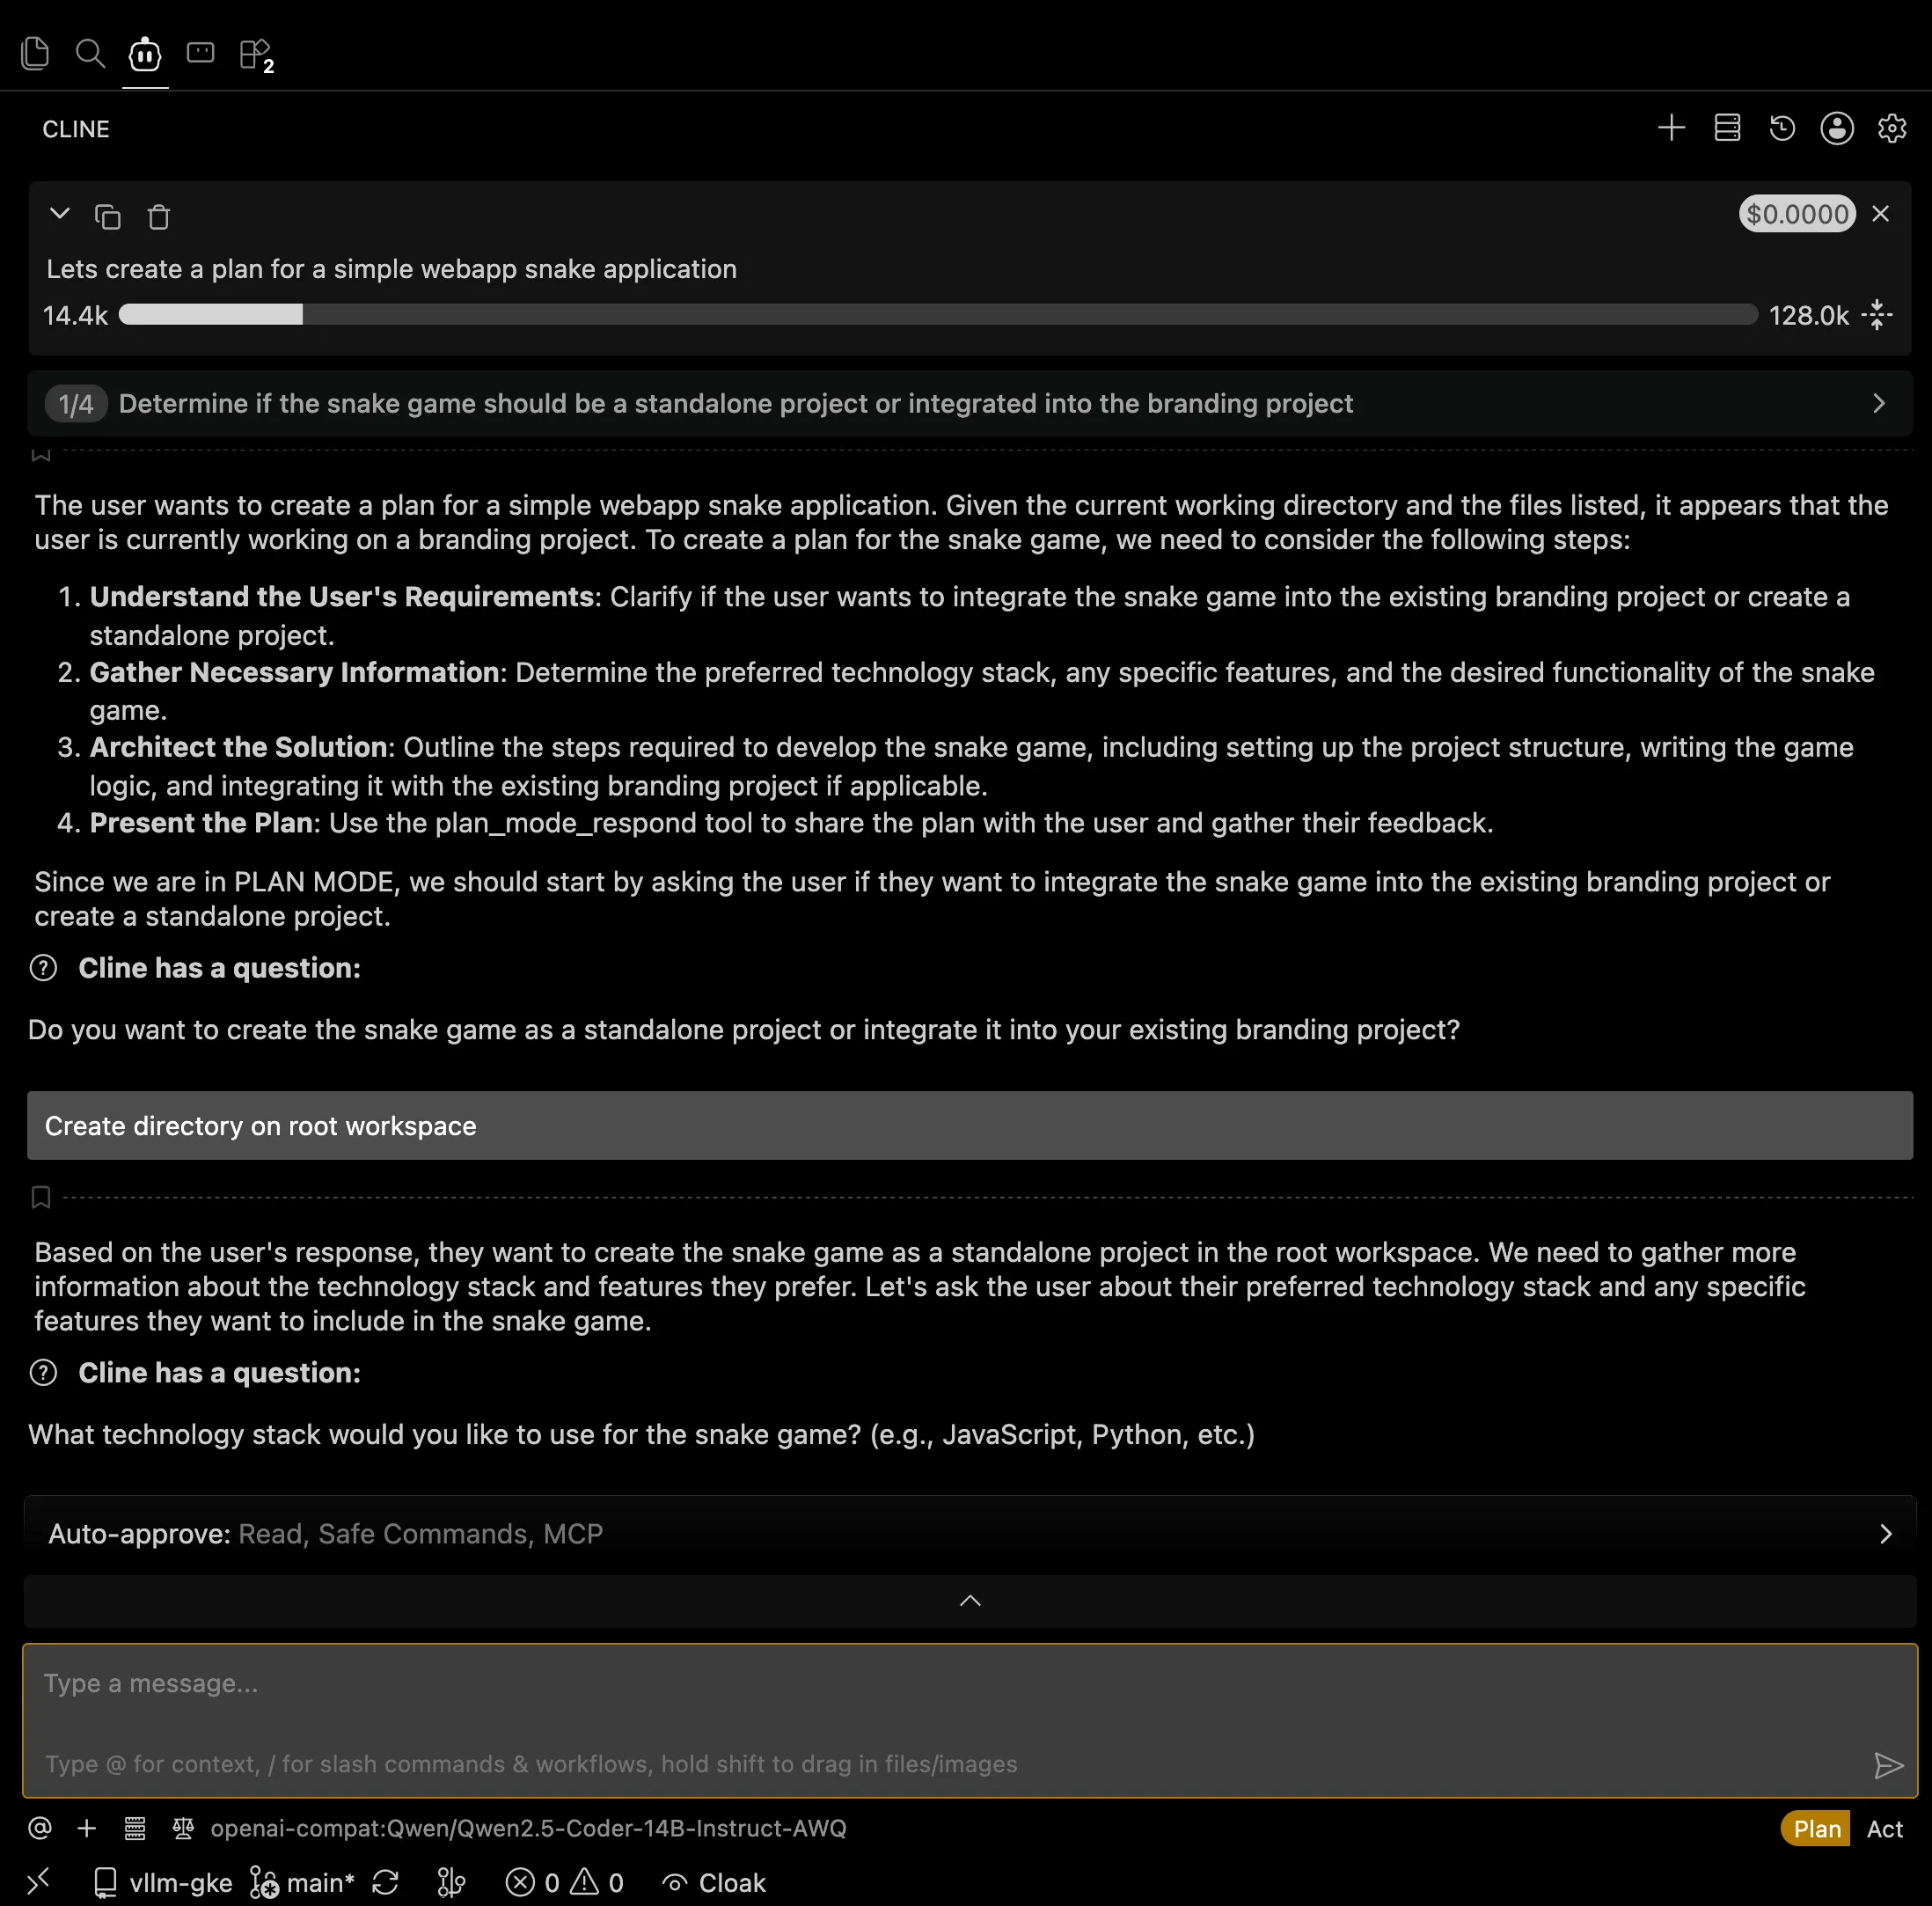
J'ai ensuite utilisé la même configuration Cline que dans l'article précédent.
Envoyer une autre requête signifie attendre de nouveau, puisque le GPU a été terminé. Avec Cline, il enverra la requête et attendra une réponse de mon cluster.
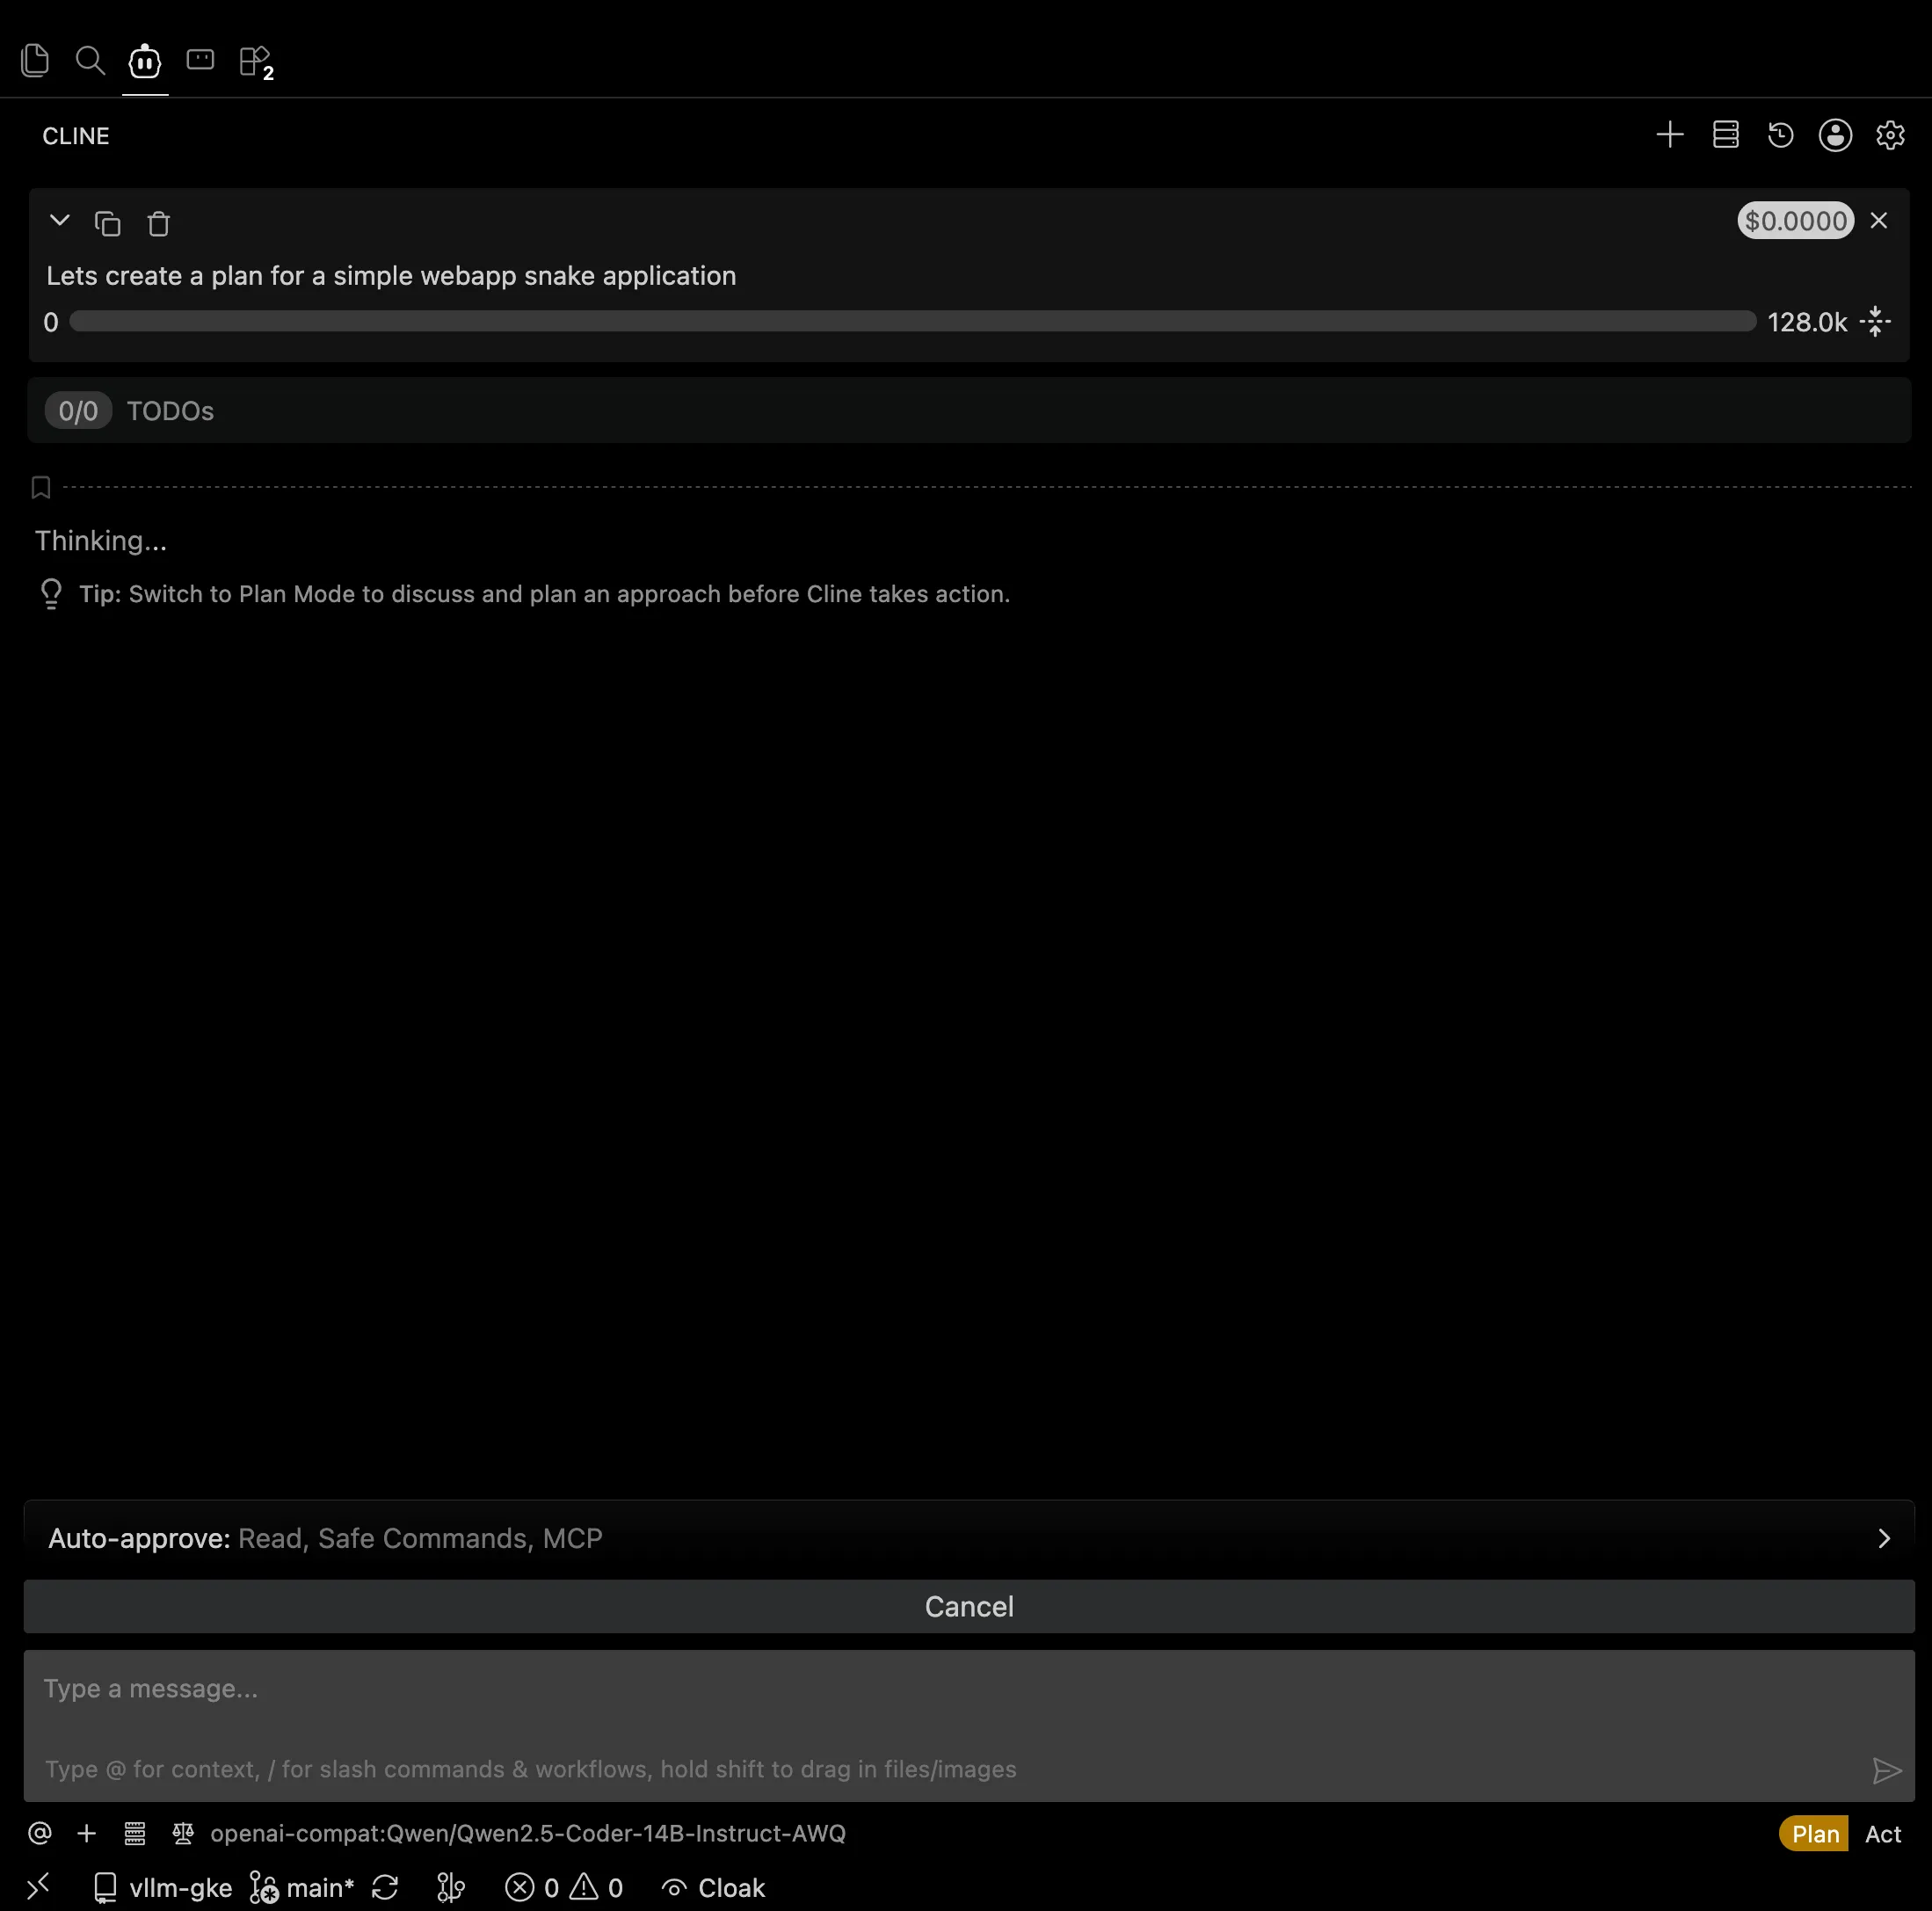
Une fois la machine prête, la réponse est récupérée de vLLM, et l'assistant peut répondre immédiatement aux prochains prompts puisque la machine est chaude. Laisser le GPU sans requêtes pendant 5 minutes réduit à nouveau l'échelle de la machine comme prévu.
Pièges et conclusions
Un compagnon comme Cline expirera (time out) sur ses requêtes après 3 tentatives. Neuf fois sur dix, j'ai eu un démarrage du GPU dès la première requête, mais je peux rencontrer des erreurs ou des pannes GPU comme d'habitude. Dans ce cas, Cline expire, et le piège est que ces requêtes restent en attente sur l'intercepteur HTTP, bloquées jusqu'à ce que le déploiement soit réparé. Prenez soin de vider la file d'attente ou de figer la mise à l'échelle après plusieurs requêtes échouées, car elles resteront bloquées. Si la mise à l'échelle à zéro est requise dans un environnement de production, ce comportement affaiblit l'add-on HTTP : il devrait être accompagné d'un mécanisme de maintenance pour les opérations de file d'attente et la mise à l'échelle, par exemple en tuant ou en recréant les machines lorsque la stratégie se désynchronise. Il vaut également la peine de souligner explicitement que l'add-on HTTP est toujours en version bêta et n'est pas encore totalement mature pour la production. Bien qu'il serve parfaitement de preuve de concept pour un usage personnel, un environnement de niveau entreprise nécessiterait soit une alternative plus robuste sans de tels enrichissements, soit de s'appuyer sur des outils complémentaires pour le rendre véritablement prêt pour la production.
Ce qui est brillant avec KEDA, c'est qu'il vous donne la main pour choisir votre propre stratégie et l'adapter sur mesure au comportement dont vous avez besoin. Le même outil utilisé dans cet exemple de scale-to-zero fonctionne avec des contraintes de haute disponibilité sur une stack de production, et il peut être enrichi avec des métriques cron ou des métriques systèmes. Cela offre une grande variété de personnalisations pour un riche catalogue de cas d'usage.