vLLM Scale-to-Zero sur GKE: KEDA & Datadog
Note : Cet article est la suite de mon précédent post, Scaling vLLM to Zero with KEDA on GKE. Le code source complet de l'architecture décrite ci-dessous est disponible dans le dépôt vllm-gke sur la branche
proxy-datadog-scaling.
Sur ma stack vLLM GKE, je voulais ajouter une surveillance des métriques et garder un œil attentif sur ce qui se passe à l'intérieur du serveur vLLM. La surveillance est particulièrement importante lorsque vous hébergez des charges de travail d'IA sur des GPU, pour plusieurs raisons :
- Dimensionner les machines et ajuster les performances en fonction de l'utilisation réelle
- Détecter les problèmes plus rapidement grâce aux symptômes des métriques et aux indicateurs personnalisés
- Avoir une vue centralisée de ce qui se passe sur les GPU et les serveurs
Ces points sont presque obligatoires lors de l'hébergement de charges de travail d'IA, à la fois pour l'optimisation des coûts et pour une meilleure expérience utilisateur.
Datadog est l'une des solutions les plus connues pour la surveillance des actifs cloud. Elle est appréciée pour sa configuration facile et son approche intuitive, et donne aux équipes les bons outils pour construire une solide stratégie de surveillance. Son offre ne cesse de croître, en particulier autour de la surveillance Kubernetes et des capacités liées à l'IA.
Je me suis récemment inscrit pour un essai et je l'ai testé sur ma stack. L'objectif était double : explorer les fonctionnalités de surveillance Kubernetes de Datadog, et créer un tableau de bord dédié avec des métriques personnalisées collectées directement depuis les endpoints Prometheus de ma stack.
J'ai également poussé la preuve de concept plus loin en déplaçant la logique de mise à l'échelle (scaling) du KEDA HTTP Add-On vers le scaler Datadog de KEDA, ce qui donne une meilleure visibilité sur la présence des pods et l'utilisation globale.
Tout ce qui est décrit ci-dessous est implémenté dans le dépôt vllm-gke, sur la branche dédiée proxy-datadog-scaling.
Fonctionnalités de surveillance Datadog
Avec Datadog, plusieurs zones de la plateforme aident à surveiller une stack Kubernetes :
- Une page Kubernetes dédiée, avec :
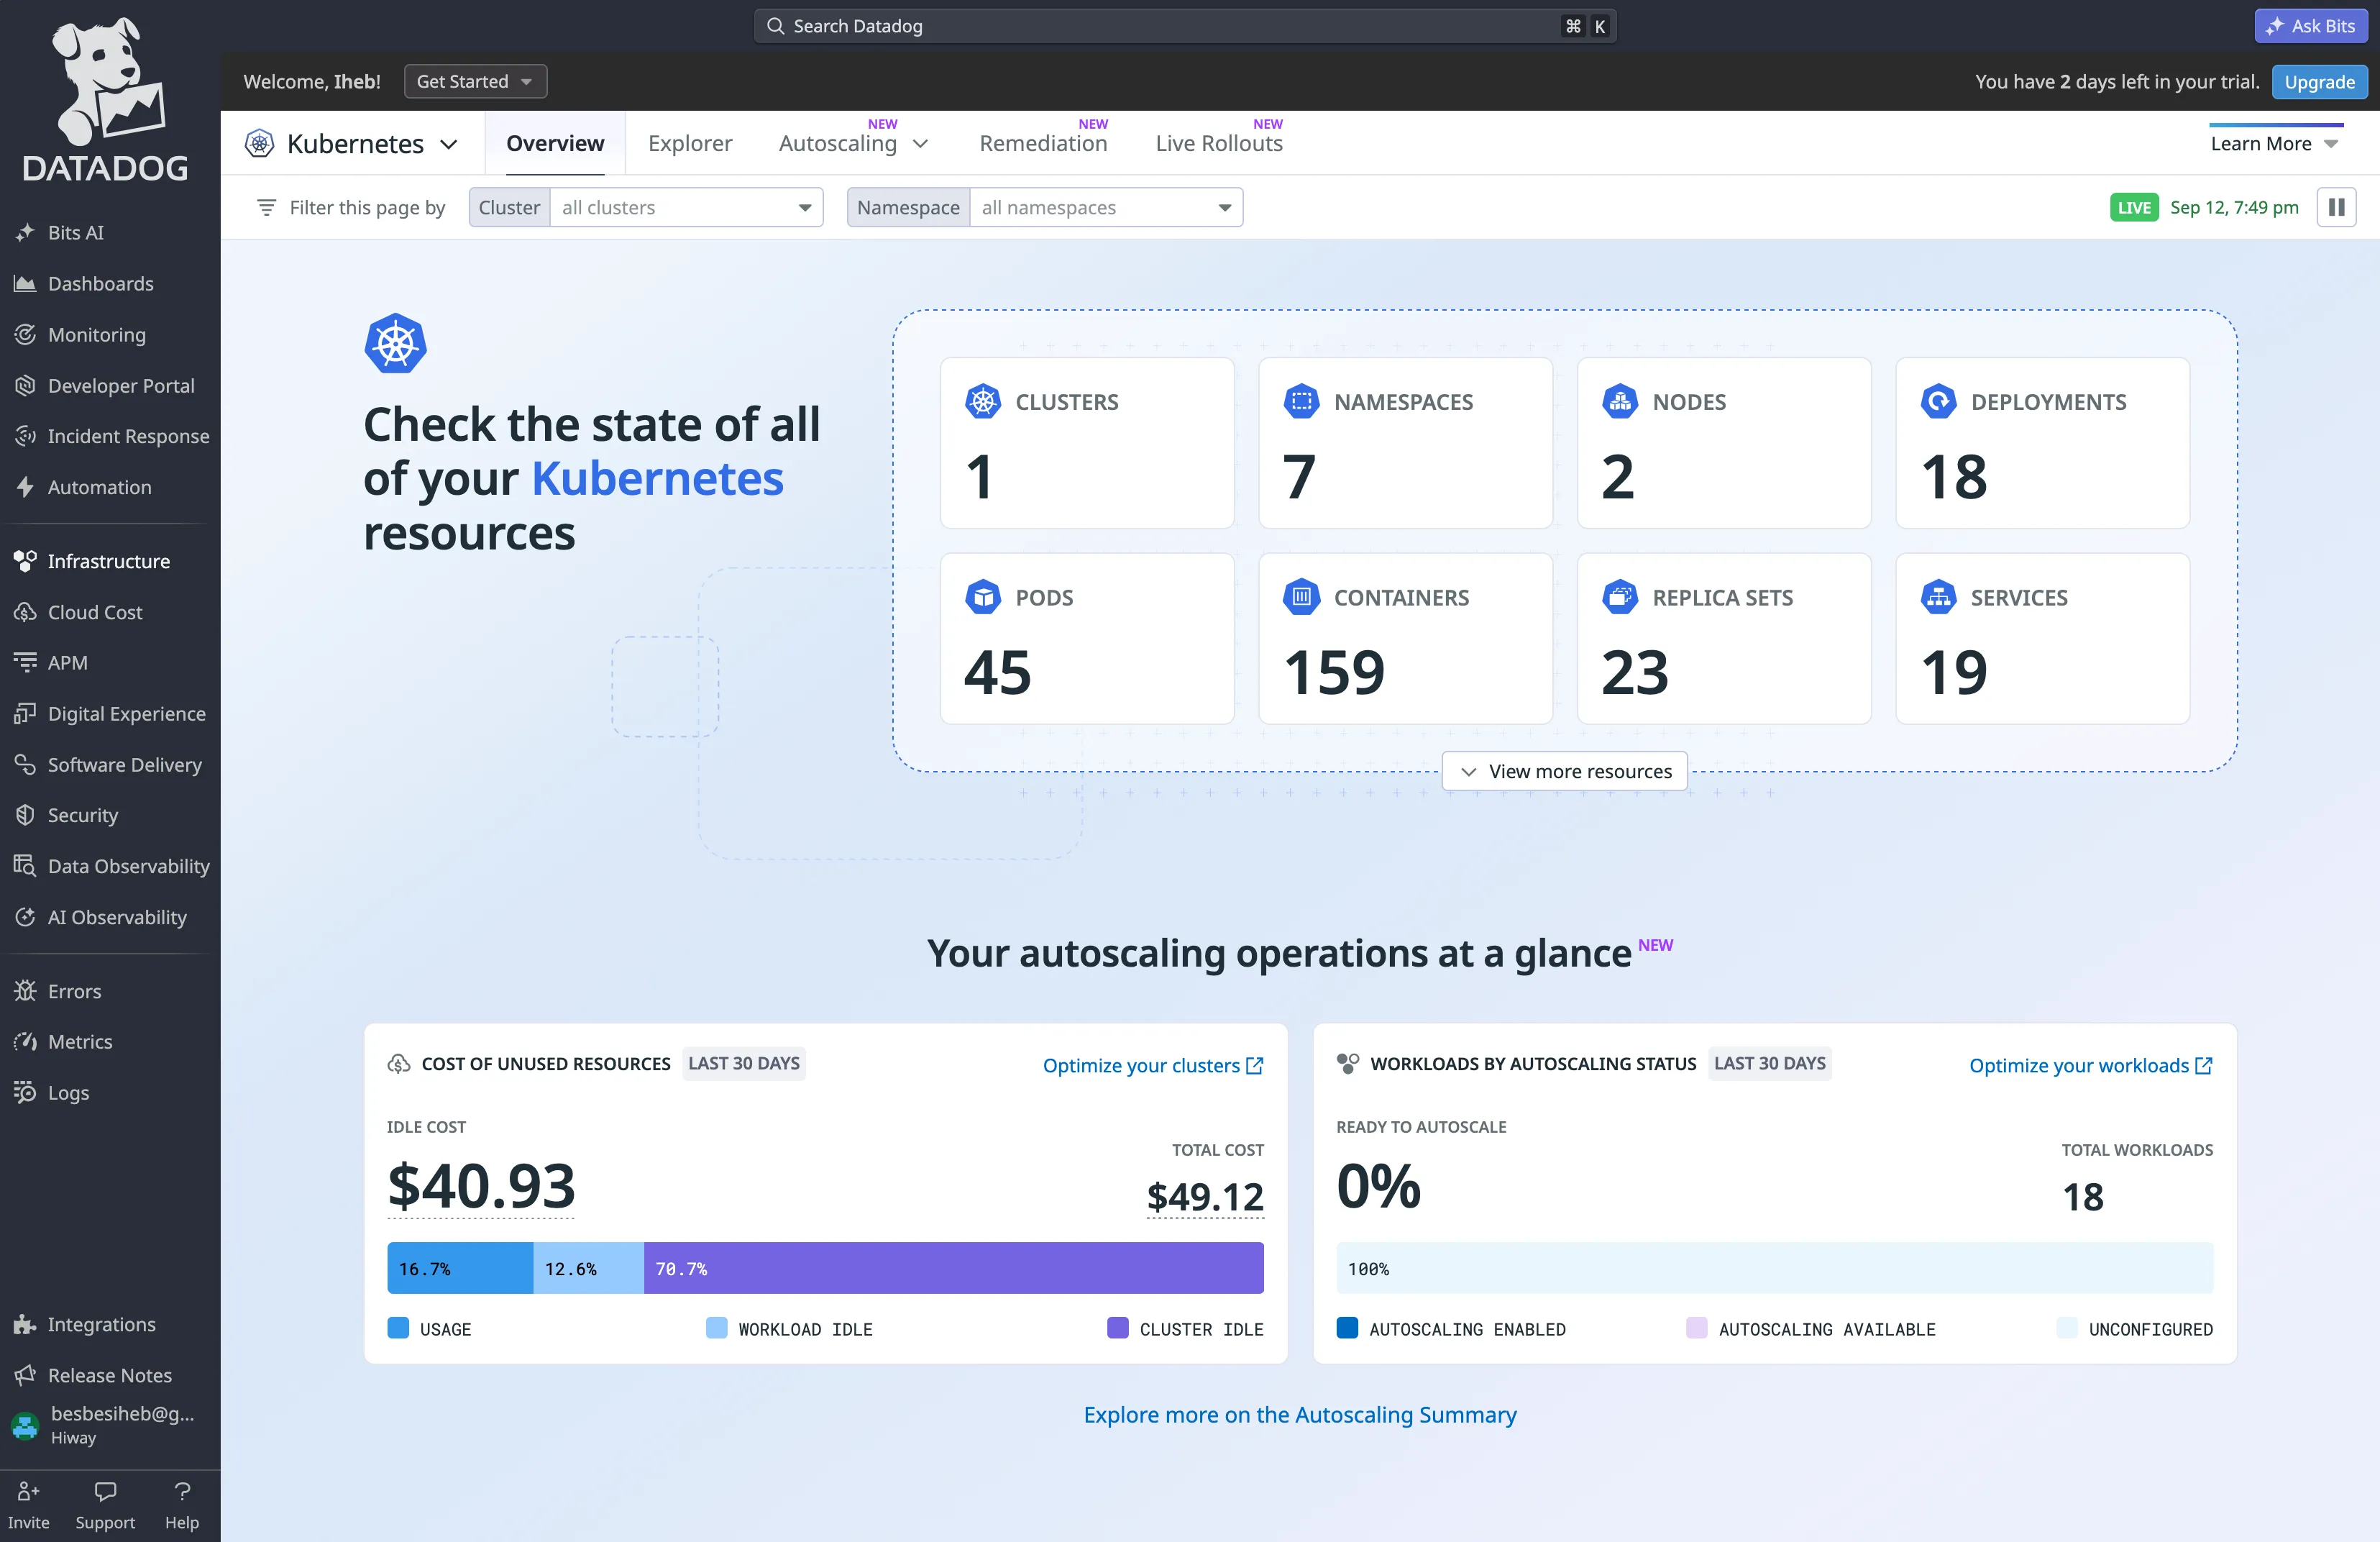
- Un onglet Overview résumant les clusters sous surveillance
- Un onglet Explorer qui permet de plonger dans les nœuds, les pods, la configuration réseau, le stockage, etc.
- Un onglet Autoscaling offrant des capacités de mise à l'échelle automatique basées sur des stratégies personnalisées et les métriques collectées pendant la surveillance (idéal pour les charges de travail asynchrones ou de longue durée)
- Un onglet Remediation : lorsque l'agent Datadog est présent sur une charge de travail, il signale son état de santé et peut déclencher des actions de remédiation définies pour restaurer les charges de travail défaillantes
- Un onglet Rollouts avec des stratégies de déploiement et de rollout personnalisables
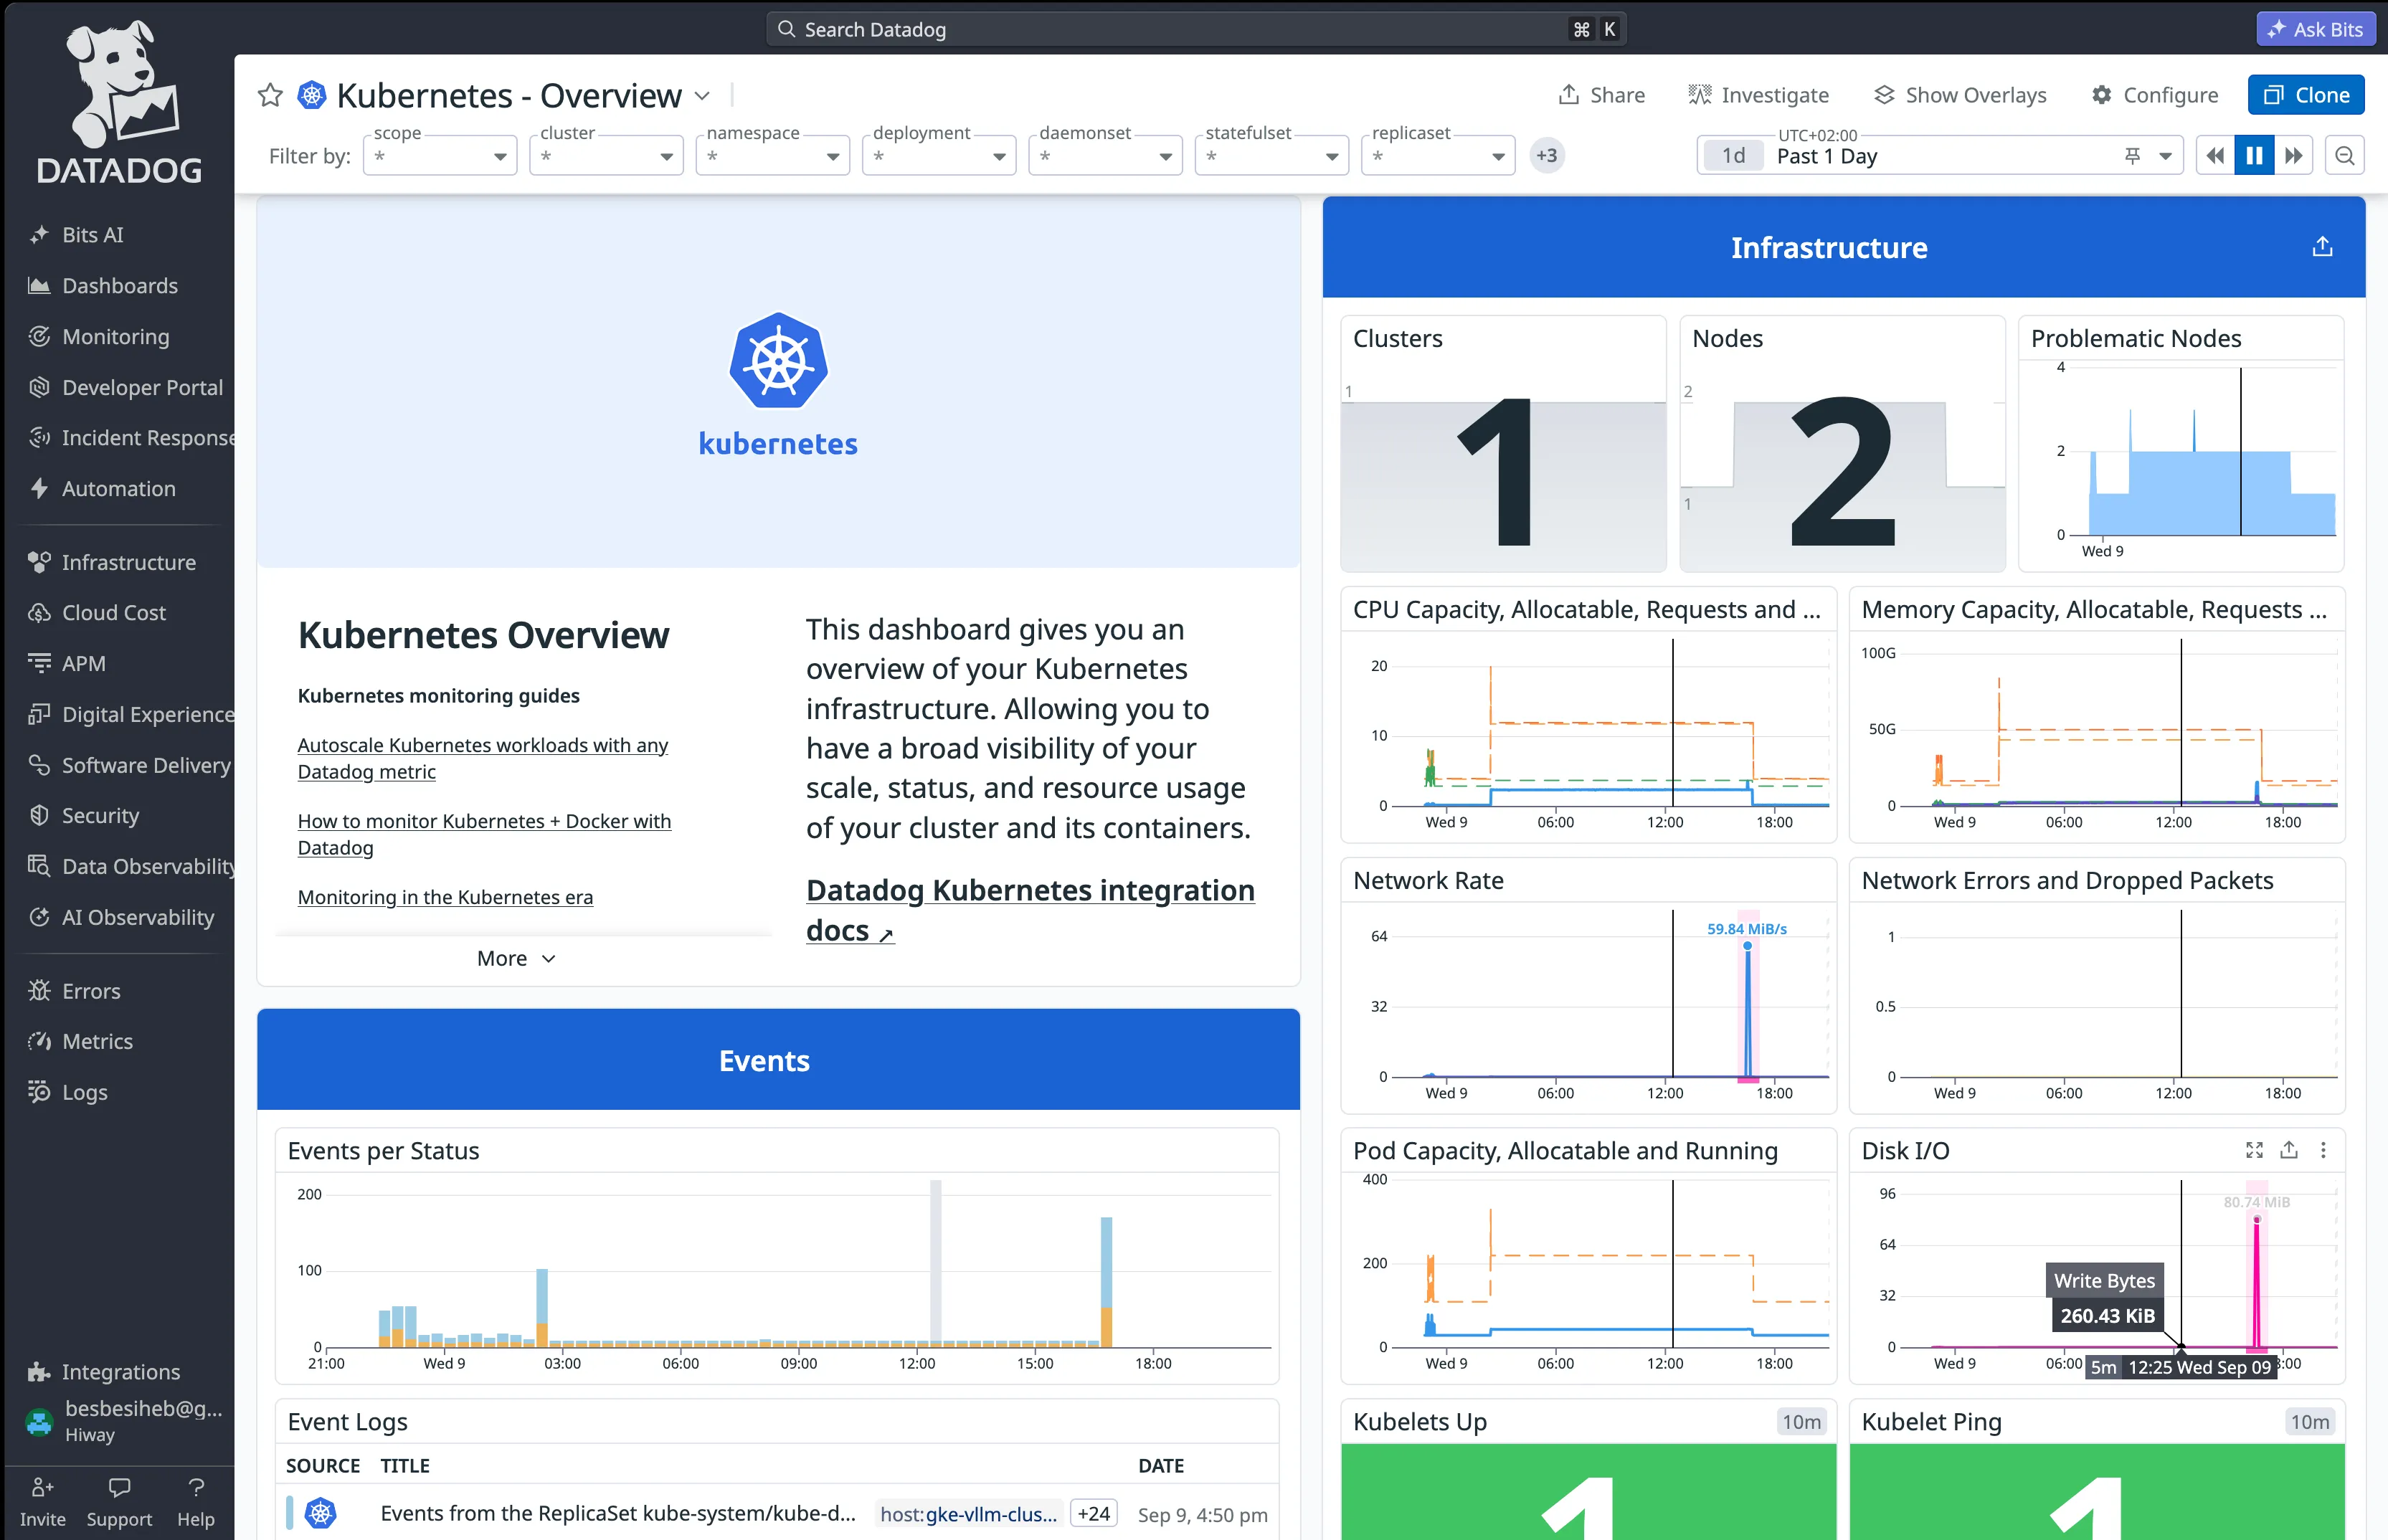
- Un tableau de bord d'aperçu géré (managed overview), généré automatiquement, qui suit toutes les métriques Kubernetes scrapées avec plusieurs sections surveillées et un système de filtrage des métriques
- Des emails de résumé quotidiens avec des métriques et des avertissements concernant les événements importants
- De nombreux autres actifs explorables, plus une page de métriques dédiée pour les découvrir et les interroger
Connexion de l'Agent Datadog
La collecte de métriques sur Datadog est simple. Elle repose sur un agent dédié s'exécutant dans le cluster, qui collecte les métriques exposées par les charges de travail annotées sur leur endpoint /metrics.
Prérequis
- Un compte Datadog avec accès à une clé API (également disponible dans l'essai)
- L'Agent Datadog installé et s'exécutant dans le cluster
- Des charges de travail annotées qui exposent des métriques
Une fois ces conditions remplies, les métriques deviennent disponibles dans Datadog presque instantanément. Vous pouvez les explorer via les actifs gérés décrits ci-dessus ou via des tableaux de bord personnalisés.
Clé API
- Connectez-vous à votre compte Datadog.
- Allez dans Organization Settings -> API Keys.
- Créez une nouvelle clé (ou copiez-en une existante).
Installation de l'Agent
Exportez votre clé API en tant que variable d'environnement, puis exécutez le script d'installation fourni dans le dépôt. Le script installe le chart Helm de Datadog et active prometheusScrape, de sorte que l'agent récupère automatiquement les métriques vLLM.
Installer l'Agent Datadog
En coulisses, le script exécute :
Commande d'installation Helm
Une fois que tout est déployé, les métriques deviennent visibles dans Datadog. Voici un exemple de la page Overview décrite ci-dessus :
D'autres métriques sont disponibles sur le tableau de bord d'aperçu géré, généré automatiquement :
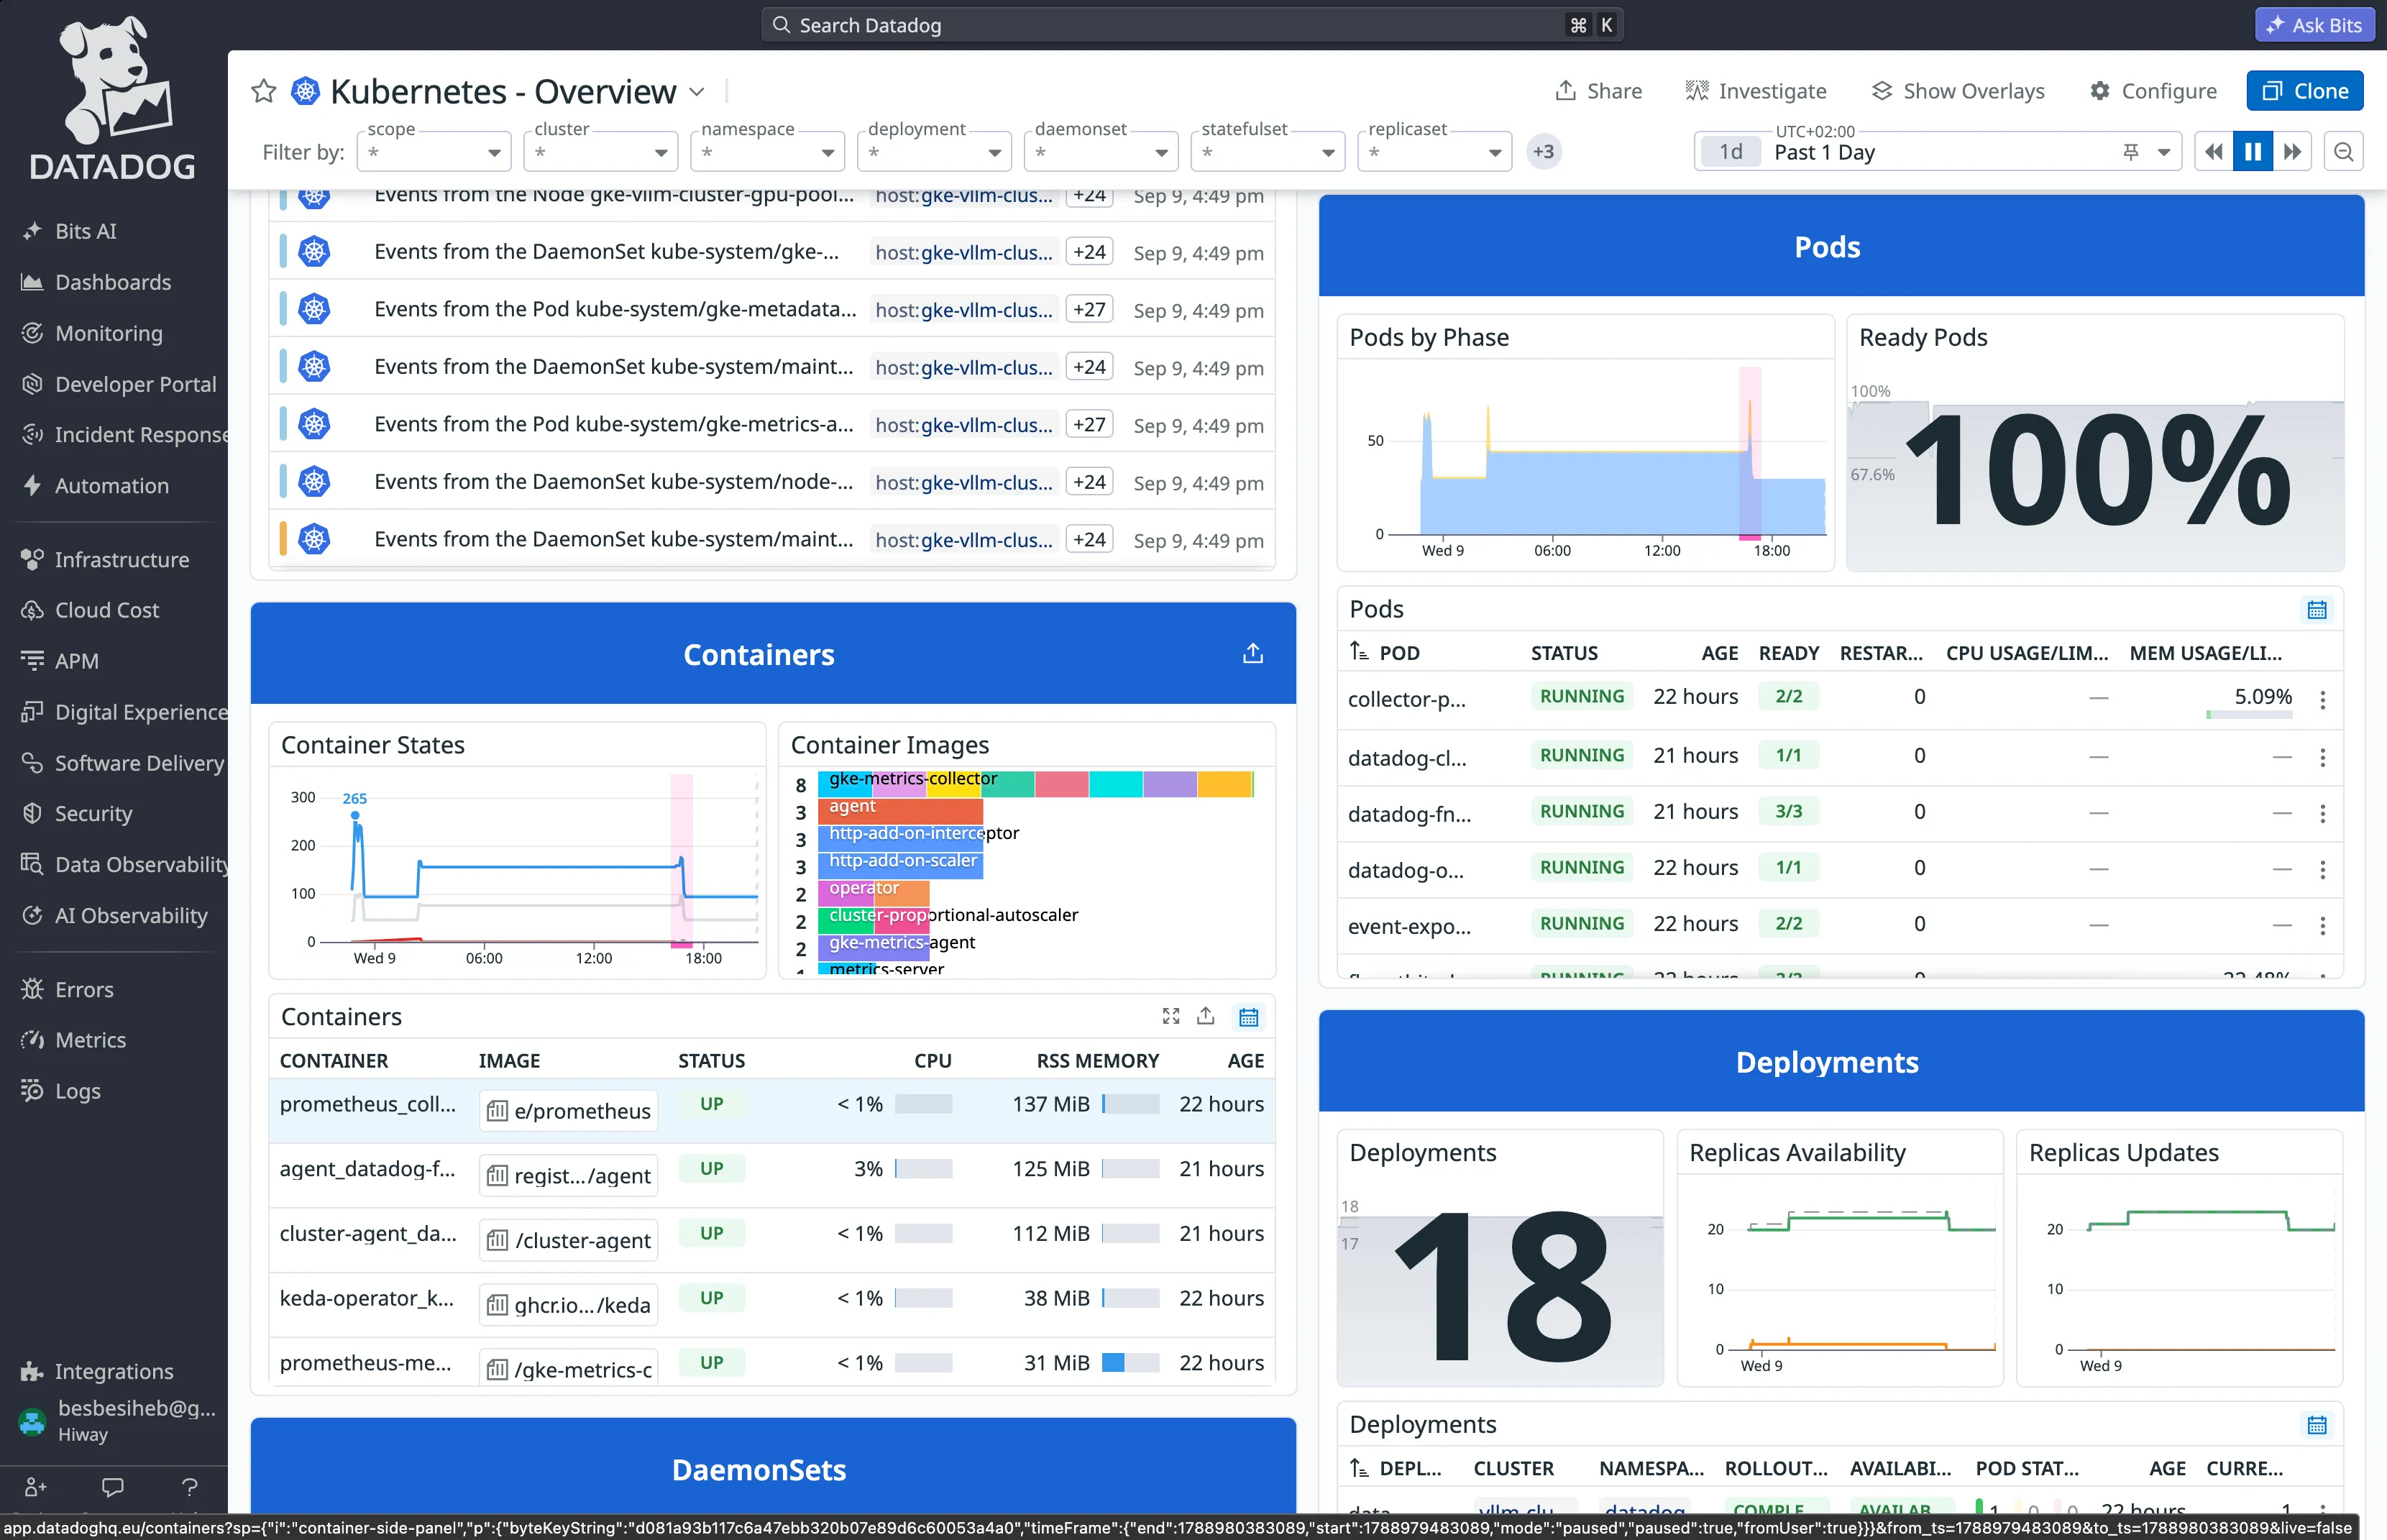
Ces vues peuvent être explorées plus en détail pour créer des widgets personnalisés et des tableaux qui correspondent à vos attentes en matière de surveillance.
Scraping des métriques vLLM
Au-delà des métriques au niveau du cluster, j'étais vraiment intéressé par ce qui se passe à l'intérieur du serveur vLLM lui-même. Étant donné que prometheusScrape a été activé lors de l'installation de l'agent, l'Agent Datadog peut déjà collecter des métriques Prometheus. Je n'avais qu'à lui indiquer où trouver les métriques vLLM, en utilisant une annotation sur le déploiement du serveur vLLM dans le chart Helm. Il scrape ensuite toutes les métriques exposées :
Annotation OpenMetrics vLLM
C'est très facile à mettre en place. En pratique, choisir quelles métriques surveiller et concevoir la disposition du tableau de bord a pris plus de temps que la connexion du cluster lui-même. Mon objectif était de suivre ce qui se passe à l'intérieur du serveur vLLM, je me suis donc concentré sur la latence, le temps jusqu'au premier token (TTFT), la mise en file d'attente interne, et des métriques similaires.
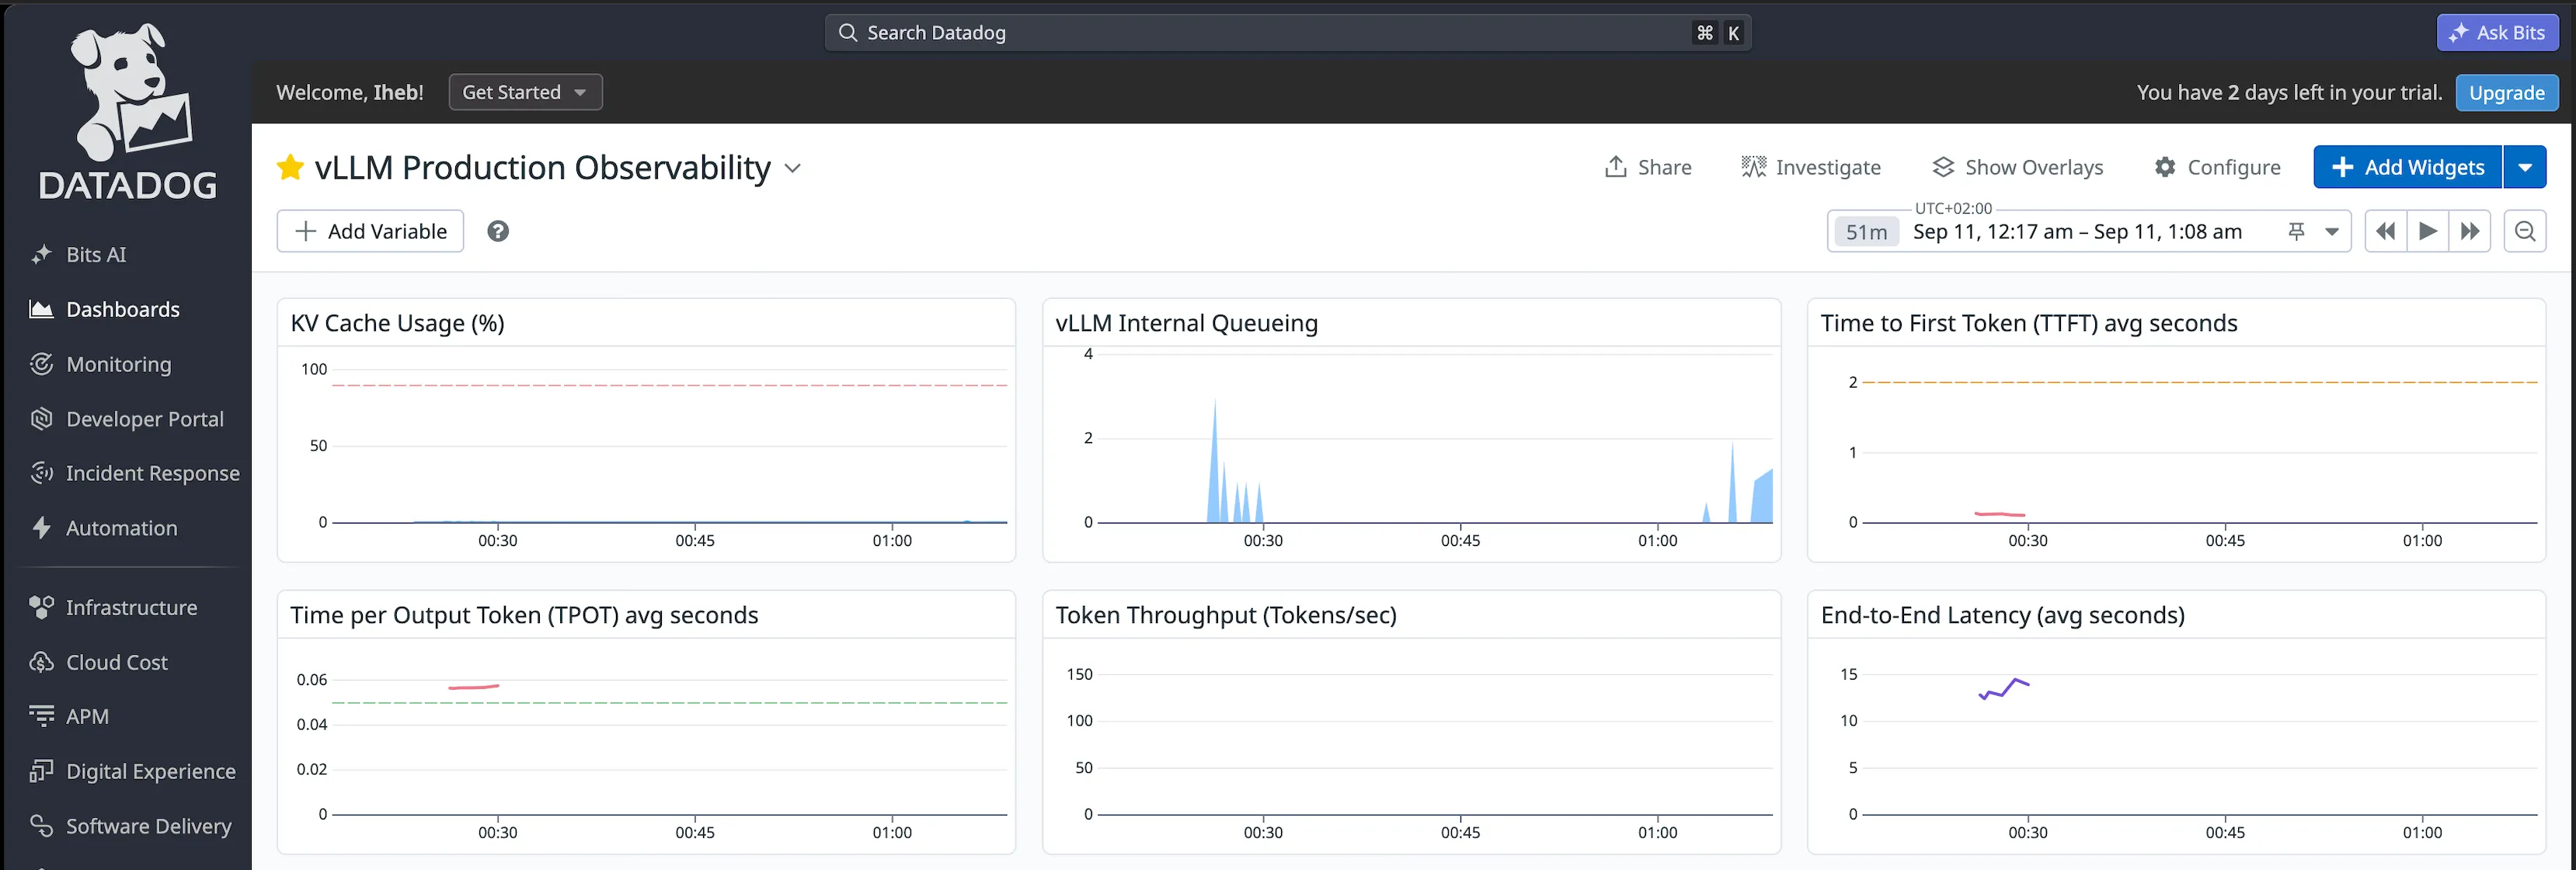
Ces métriques changent avec l'utilisation. Elles sont importantes pour comprendre la charge globale sur le serveur et comment il traite les requêtes. Le scraping n'est pas en temps réel, mais il s'en rapproche : l'agent met à jour les métriques à un intervalle régulier, donc à tout moment je peux lire les valeurs que je recherche.
Le diagramme ci-dessous résume comment les métriques circulent des charges de travail vers Datadog :
Toute l'expérience de configuration a été facile et entièrement réalisable sur l'essai Datadog. En quelques jours après l'activation de l'essai, j'avais connecté le cluster et construit un tableau de bord personnalisé. Cela m'a laissé libre de me concentrer sur la stratégie : quelles métriques exporter et comment les exploiter.
Mise à l'échelle avec le scaler Datadog
Je voulais également explorer la fonctionnalité d'autoscaling de Datadog. Elle fonctionne directement, avec des procédures prêtes à l'emploi pour scaler les charges de travail Kubernetes à la hausse et à la baisse en fonction de nombreuses métriques. Cependant, elle est mieux adaptée aux stacks asynchrones.
Mon but ici est de scaler à zéro, donc je suis confronté à la même contrainte abordée dans mon article précédent : lorsque la stack est scalée à zéro, rien ne tourne pour enregistrer les appels entrants. vLLM ne peut pas savoir que des requêtes arrivent s'il n'est pas provisionné et opérationnel. J'avais précédemment résolu ce problème avec le KEDA HTTP Add-On, qui était encore en version bêta mais scalait élégamment la stack en fonction de sa métrique interne de requêtes en attente.
L'ajout d'une file d'attente ou d'un point d'entrée devant la stack résoudrait le problème immédiatement, et je pourrais même utiliser le scaler Datadog directement. Mais la stack ne serait plus synchrone, ce qui compliquerait la communication avec les compagnons d'assistance au code qui s'appuient sur des échanges synchrones avec le cluster d'IA.
Certaines solutions suggèrent une approche basée sur des tâches cron (cron), puis un scaling sur les requêtes entrantes. Avec des métriques personnalisées, Datadog permet de faire mieux.
L'idée est de créer une métrique personnalisée qui représente le nombre de requêtes actives sur le serveur vLLM et de la pousser vers Datadog. Cela résout joliment la contrainte. Cependant, puisqu'un pod vLLM met plusieurs minutes à provisionner son GPU, la première requête serait abandonnée avant que quoi que ce soit ne soit prêt. Le KEDA HTTP Add-On et Knative résolvent cela avec une couche d'interception située entre le client et le serveur : elle retient les requêtes jusqu'à ce que le backend soit monté en charge et prêt à servir.
Je peux obtenir le même résultat avec un intercepteur personnalisé qui signale une métrique personnalisée à Datadog. Le flux ressemble à ceci :
- Le proxy reçoit un appel entrant et le met en attente
- Il expose le nombre de requêtes actives sous forme de jauge (gauge) Prometheus
- L'Agent Datadog scrape cette jauge et la pousse vers Datadog
- Le scaler Datadog KEDA interroge la valeur de la métrique depuis l'API Datadog
- KEDA scale le déploiement vLLM en conséquence
- Une fois que le pod est prêt, le proxy transfère la requête en attente vers le serveur vLLM
Le meilleur aspect de cette approche est que la stack est désormais surveillée et scalée via Datadog, depuis un point centralisé unique. À l'échelle de la production, avec plusieurs clusters, tout peut être géré au même endroit. Comparée à l'approche du HTTP Add-On, il y a une petite latence ajoutée, car le signal de scaling fait maintenant un aller-retour via Datadog au lieu d'être décidé à l'intérieur du cluster. Cette latence est minimale, et facile à accepter une fois que tout est regroupé dans le même tableau de bord. Pour que cela fonctionne, j'ai ajouté un petit serveur proxy "always on" (toujours allumé) qui écoute les requêtes entrantes et les signale, afin qu'une décision de scaling puisse être prise en cas de besoin.
Notez les deux directions du flux de données : l'Agent Datadog pousse les métriques vers Datadog, tandis que l'opérateur KEDA tire les métriques depuis Datadog pour prendre des décisions de scaling.
KEDA s'authentifie à la fois avec une DD_API_KEY et une DD_APP_KEY (les clés d'application font 40 caractères). Elles sont mappées de manière sécurisée via un Secret Kubernetes et une ressource TriggerAuthentication :
KEDA TriggerAuthentication
Le reverse proxy personnalisé (vllm-proxy) expose une jauge Prometheus nommée vllm_proxy_active_requests.
L'Agent Datadog scrape le proxy grâce à une annotation sur le pod dans proxy-deployment.yaml :
Annotation de scrape du Proxy
Avec ces nouvelles métriques, j'ai pu compléter mon tableau de bord avec plus de widgets d'utilisation :
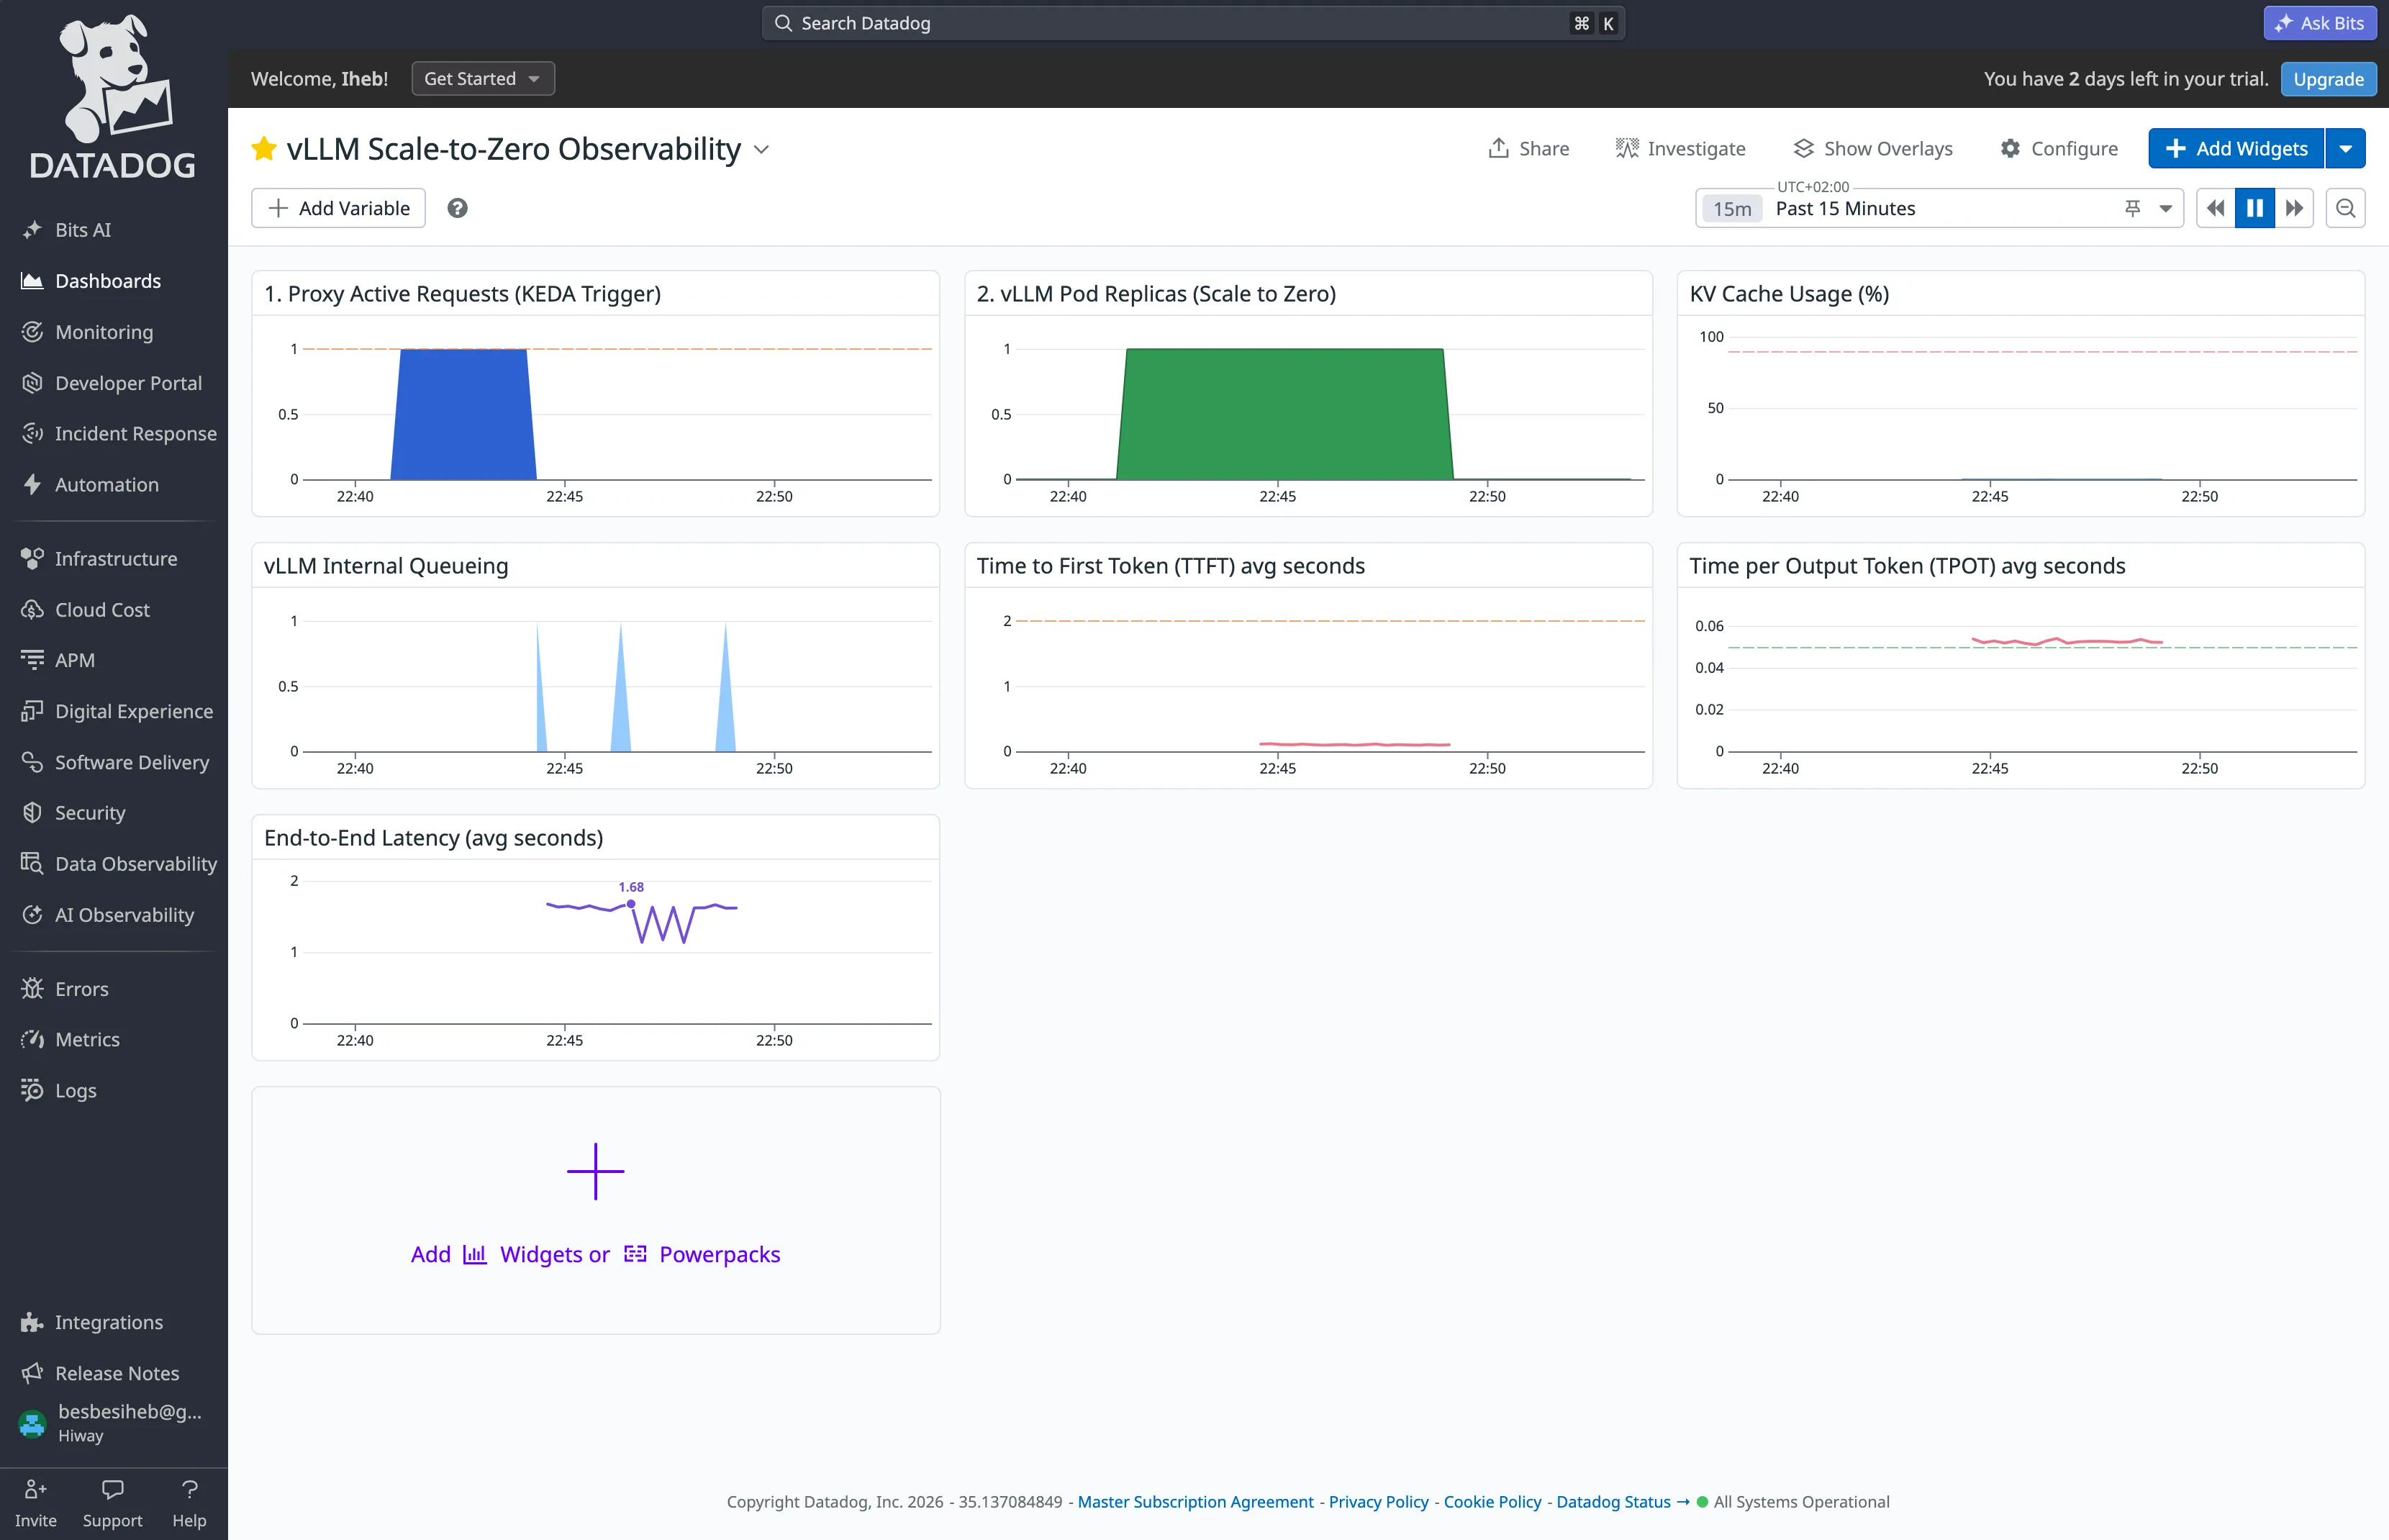
Les widgets montrent les requêtes proxy actives et les pods GPU. Dès qu'une requête arrive, le proxy la met en attente pendant plusieurs minutes le temps que le pod provisionne le GPU et commence à répondre. Environ cinq minutes après la dernière activité (la valeur par défaut de cooldownPeriod dans KEDA, qui est de 300 secondes), le pod se scale vers le bas (scale down) et les autres métriques s'arrêtent, puisque le GPU a été libéré. Cela donne une représentation visuelle directe du scale-out (montée en charge) et scale-in (baisse en charge) pilotés par les requêtes sur ce cluster.
Code source du tableau de bord
Tableau de bord d'Observabilité vLLM Scale-to-Zero
Conclusion
Dans l'ensemble, l'intégration de Datadog et la connexion de son agent à mon cluster a été une expérience très facile. C'est une solution solide qui continue d'ajouter des fonctionnalités alignées sur les tendances actuelles et futures de l'IA. Au-delà du scaler, la fonctionnalité de remédiation est très intéressante, tout comme les capacités natives d'IA, qui peuvent même détecter les hallucinations. Pour les contextes de production avec plusieurs stacks Kubernetes sous forte charge, Datadog apporte une réelle valeur ajoutée : des capacités de surveillance à 360 degrés, plus un certain contrôle sur le scaling et les déploiements.