Déployer des agents ADK
Déployer des agents ADK
Dans mes articles précédents, j'ai construit un assistant de données BigQuery avec Google ADK et évalué son comportement. Dans les deux cas, l'agent s'exécutait localement dans mon terminal. Cet article s'inscrit dans la continuité : sortir ce même agent de ma machine pour le déployer sur GCP.
J'explore trois chemins de déploiement, tous pilotés par l'outil agents-cli de Google. Un agent défini avec ADK peut être déployé sur un backend Agent Engine géré (désormais appelé Agent Runtime sous Agent Platform dans la console, ce qui correspond à la cible agent_runtime) ou sur un backend Cloud Run. Cloud Run se décline lui-même en deux variantes : un service entièrement auto-généré (scaffoldé) pour démarrer rapidement, et un service géré par Terraform pour les équipes qui souhaitent de l'infrastructure as code. La CLI accepte également une cible gke pour les clusters Kubernetes, que je laisse de côté ici pour me concentrer sur les options serverless.
J'ai créé le dépôt agent-on-gcp pour présenter ces méthodes. La branche main contient le code source de l'agent ainsi que les scripts qui le déploient et le détruisent. Une seconde branche, feature/cloudrun-agent, ajoute une configuration Terraform qui provisionne l'infrastructure Cloud Run sur laquelle l'agent est déployé.
Prérequis
Tous les chemins nécessitent un compte de service (service account) pour l'agent. Il permet à l'agent d'appeler les services dont il a besoin pour répondre aux prompts, d'écrire la télémétrie et les journaux (logs), et d'atteindre le serveur MCP ainsi que le registre de compétences (skills registry).
La bonne pratique consiste à restreindre ce compte de service exactement à ce que fait l'agent, afin que l'exécution des outils reste sous contrôle. Comme cet agent est un assistant de données BigQuery, il est limité aux capacités d'accès aux données ainsi qu'à l'observabilité. Les rôles attachés au principal sont :
roles/bigquery.dataViewerroles/bigquery.jobUserroles/aiplatform.userroles/mcp.toolUserroles/cloudtrace.agentroles/monitoring.metricWriterroles/logging.logWriter
Le dépôt inclut le nécessaire pour provisionner ce compte de service. Sur main, cela est effectué par le script setup_iam.sh, qui crée le compte de service bq-agent-sa et lui accorde les rôles ci-dessus. Sur feature/cloudrun-agent, cela est pris en charge par le module IAM Terraform avec la même liste de rôles.
NOTE
Les scripts de déploiement Agent Engine et Cloud Run appellent automatiquement l'étape de provisionnement IAM, il n'y a donc aucune commande séparée à exécuter.
Agent Engine vs Cloud Run
Honnêtement, les deux méthodes sont excellentes et répondent à des cas d'usage spécifiques. Deux propriétés constituent les véritables facteurs différenciants et peuvent aider à faire un choix :
- Fonctionnalités gérées : Agent Engine intègre nativement la gestion des sessions, la mémoire, le contrôle des révisions et le traçage de sécurité. Cloud Run fournit un point de terminaison conteneurisé et rien de plus, tout le reste est à construire soi-même.
- Maîtrise de l'infrastructure : Cloud Run offre un contrôle total sur l'infrastructure, du scaling au réseau en passant par le stockage personnalisé des sessions. Agent Engine abstrait entièrement ces aspects.
Les deux méthodes de déploiement peuvent ensuite être publiées sur la plateforme Gemini Enterprise, mais avec des approches différentes, comme je le détaillerai dans la conclusion.
Agent Engine
Déploiement
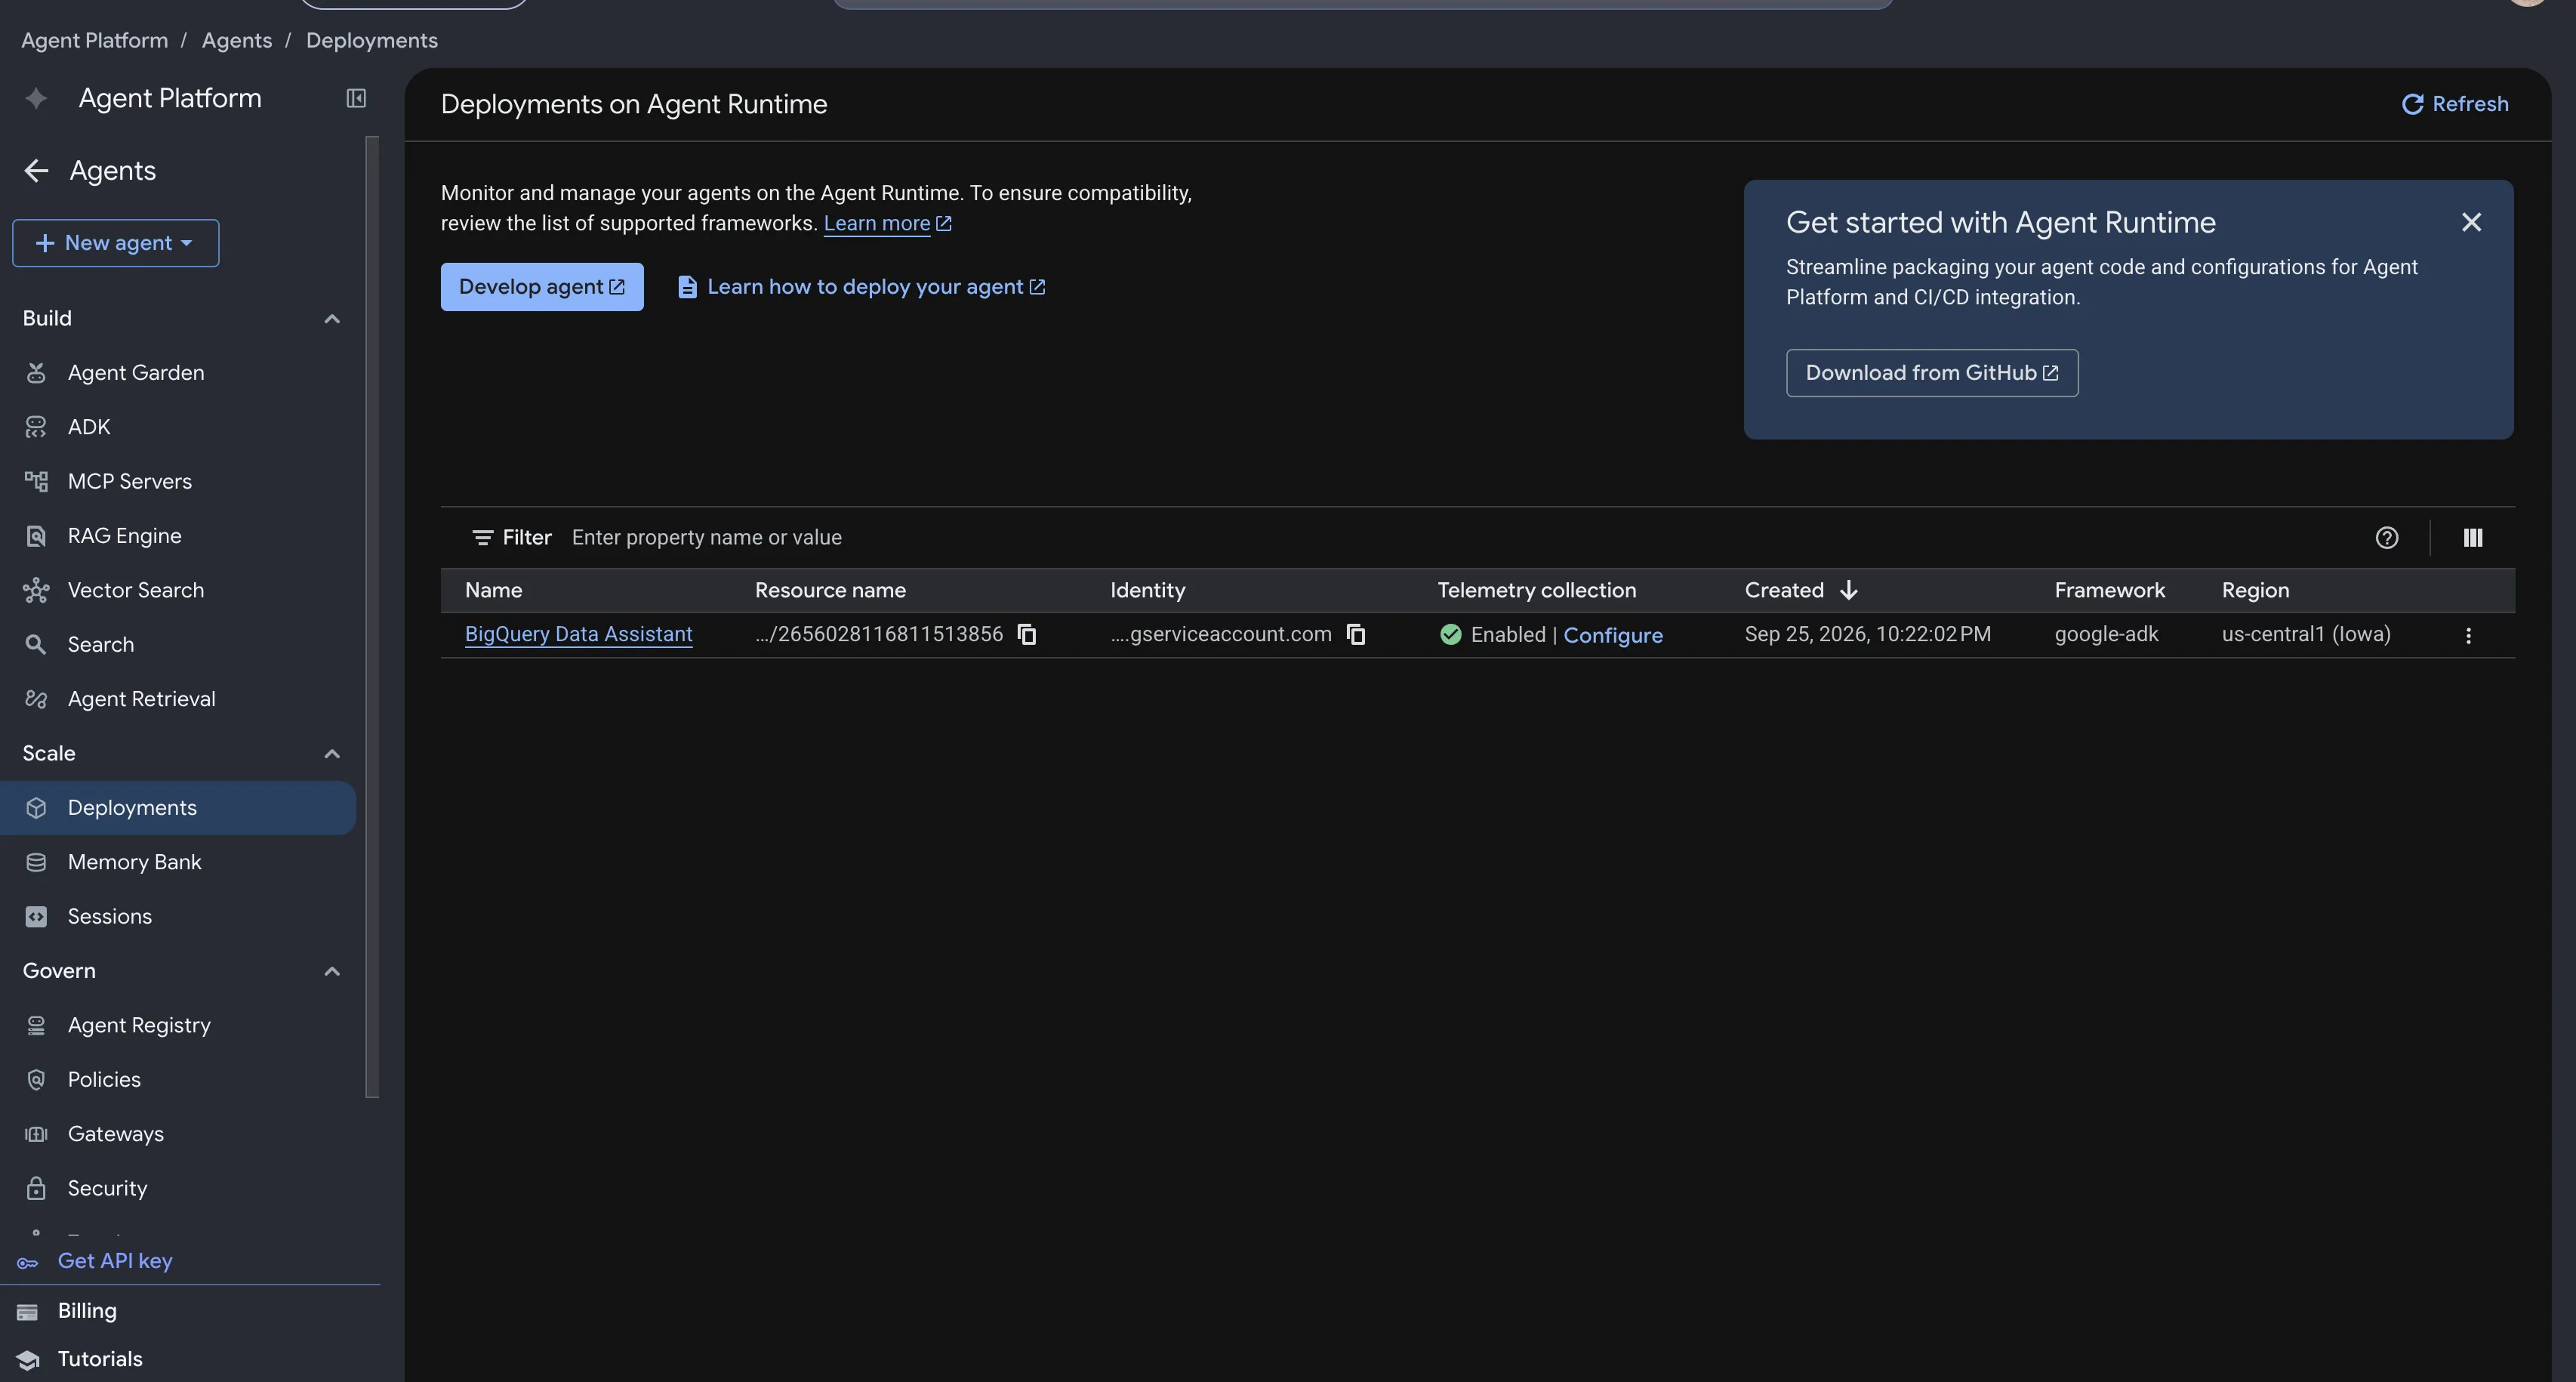
Agent Engine est un excellent choix lorsque vous souhaitez un écosystème géré pour l'IA et l'exécution d'agents. Il propose une variété de fonctionnalités sous Agent Platform > Agents > Deployments dans la console Google Cloud.
agents-cli peut déployer un agent ADK sur Agent Engine à partir de la seule définition du code. Il génère (scaffolde) le Dockerfile, la configuration et les fichiers de déploiement pour vous :
Générer le scaffold pour Agent Engine
Par défaut, vous gardez le contrôle sur la configuration générée, et vous pouvez la modifier en éditant le fichier agents-cli-manifest.yaml généré avant de déployer.
Le déploiement construit l'image conteneur et provisionne une ressource reasoningEngine pour exécuter l'agent :
Déployer sur Agent Engine
Au-delà des paramètres évidents, la commande de déploiement accepte :
--service-account: le compte de service de l'agent, déjà créé à ce stade.--update-env-vars: active ici la télémétrie, ce qui offre un bien meilleur suivi de l'exécution de l'agent.
Le déploiement complet est automatisé par un seul script, deploy_agent_runtime.sh :
Déployer Agent Engine via le script
Ce script crée le compte de service, nettoie tout scaffold précédent, génère une nouvelle configuration, la patche (le modèle de scaffold épingle actuellement une version d'ADK sans l'extra mcp, le patch corrige donc cette version pour que MCP fonctionne directement) et déploie enfin l'Agent Engine :
Vous pouvez détruire la pile déployée avec destroy_agent_runtime.sh :
Détruire la pile Agent Engine
Le script supprime les liaisons du compte de service, nettoie le scaffold et supprime l'agent via un appel API direct (ou agent_engines.delete() depuis le SDK Vertex AI), car l'outil CLI ne propose aucune commande pour détruire les agents déployés :
Supprimer le reasoning engine
Les déploiements sont suivis par un fichier d'état, deployment_metadata.json, écrit dans src/agent/. Il enregistre, entre autres, l'identifiant du reasoning engine, et c'est ce qui fait qu'un redéploiement effectue une mise à jour au lieu de créer un doublon. Le supprimer signifie que le prochain déploiement créera un nouveau moteur. La façon dont vous le gérez dépend de votre usage : en production, il devrait être stocké à distance pour que la CI puisse y accéder, tandis que pour des tests ou des projets individuels, le conserver localement suffit.
Tests
La page de l'agent dans la console regorge de vues d'ensemble et d'outils pratiques.
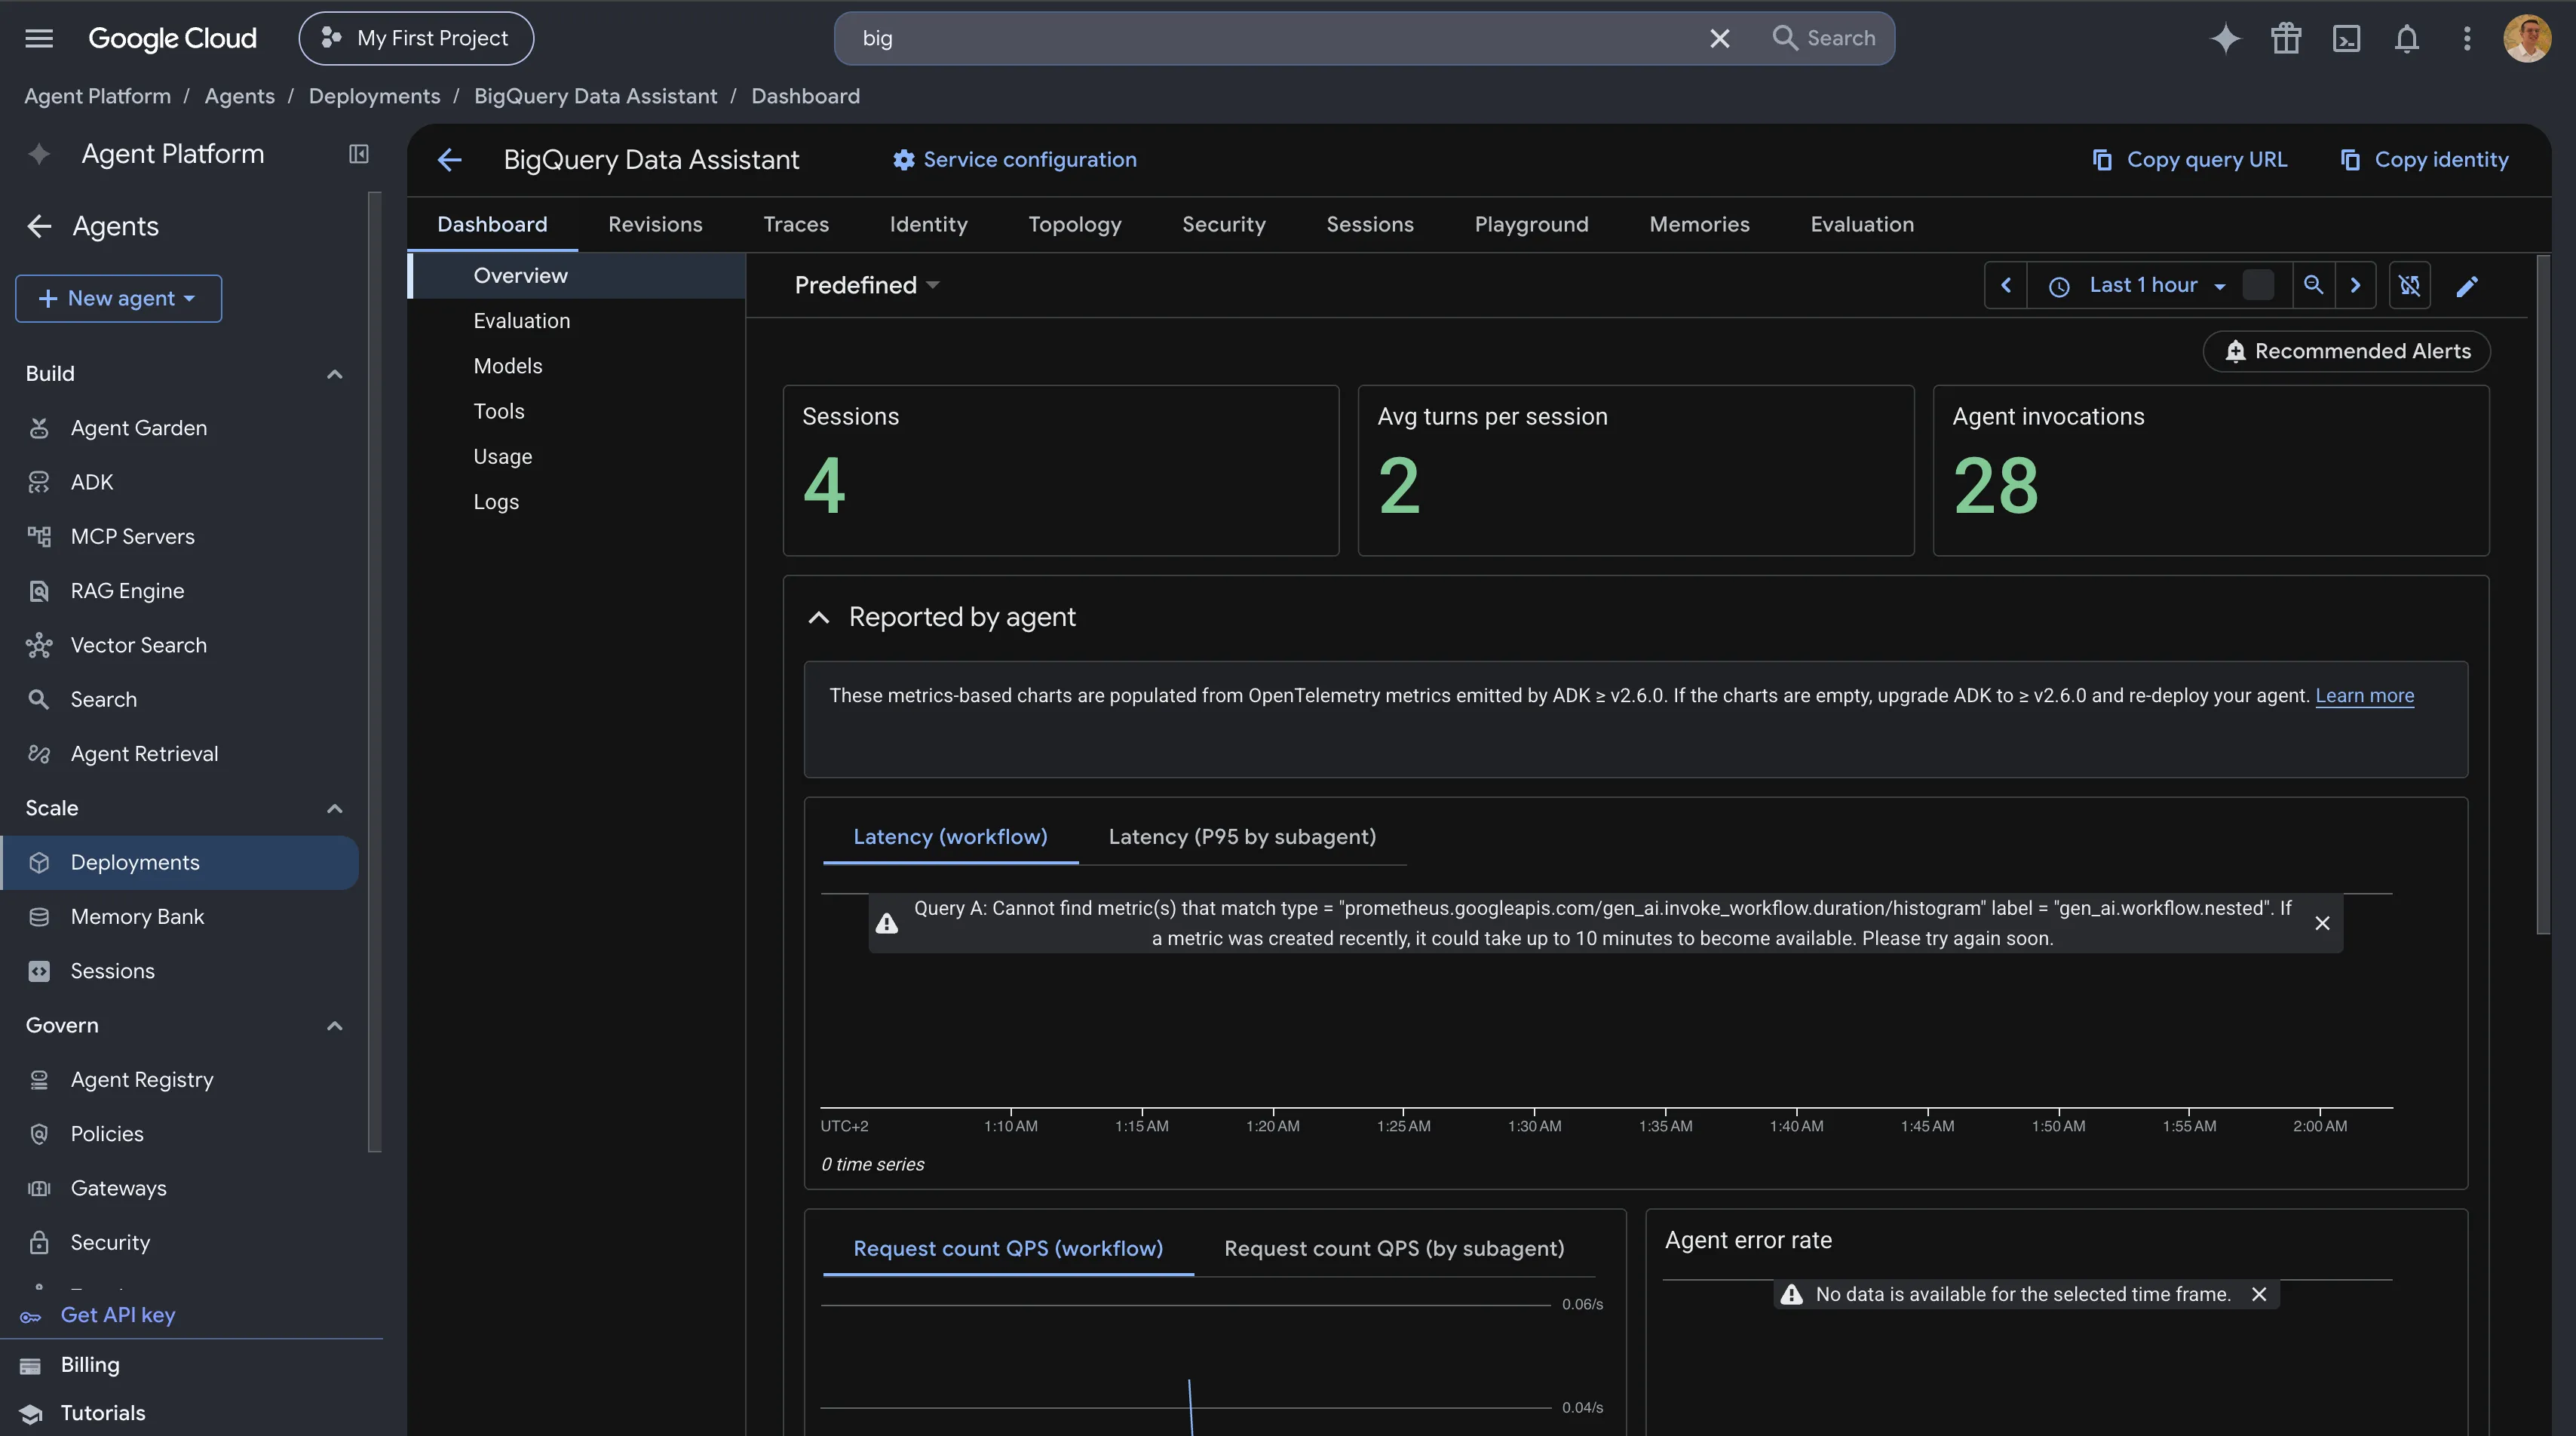
Sur la vue d'ensemble (Overview), je peux suivre les invocations de l'agent, y compris les appels tracés aux sous-agents, les données réseau et les métriques d'exécution :
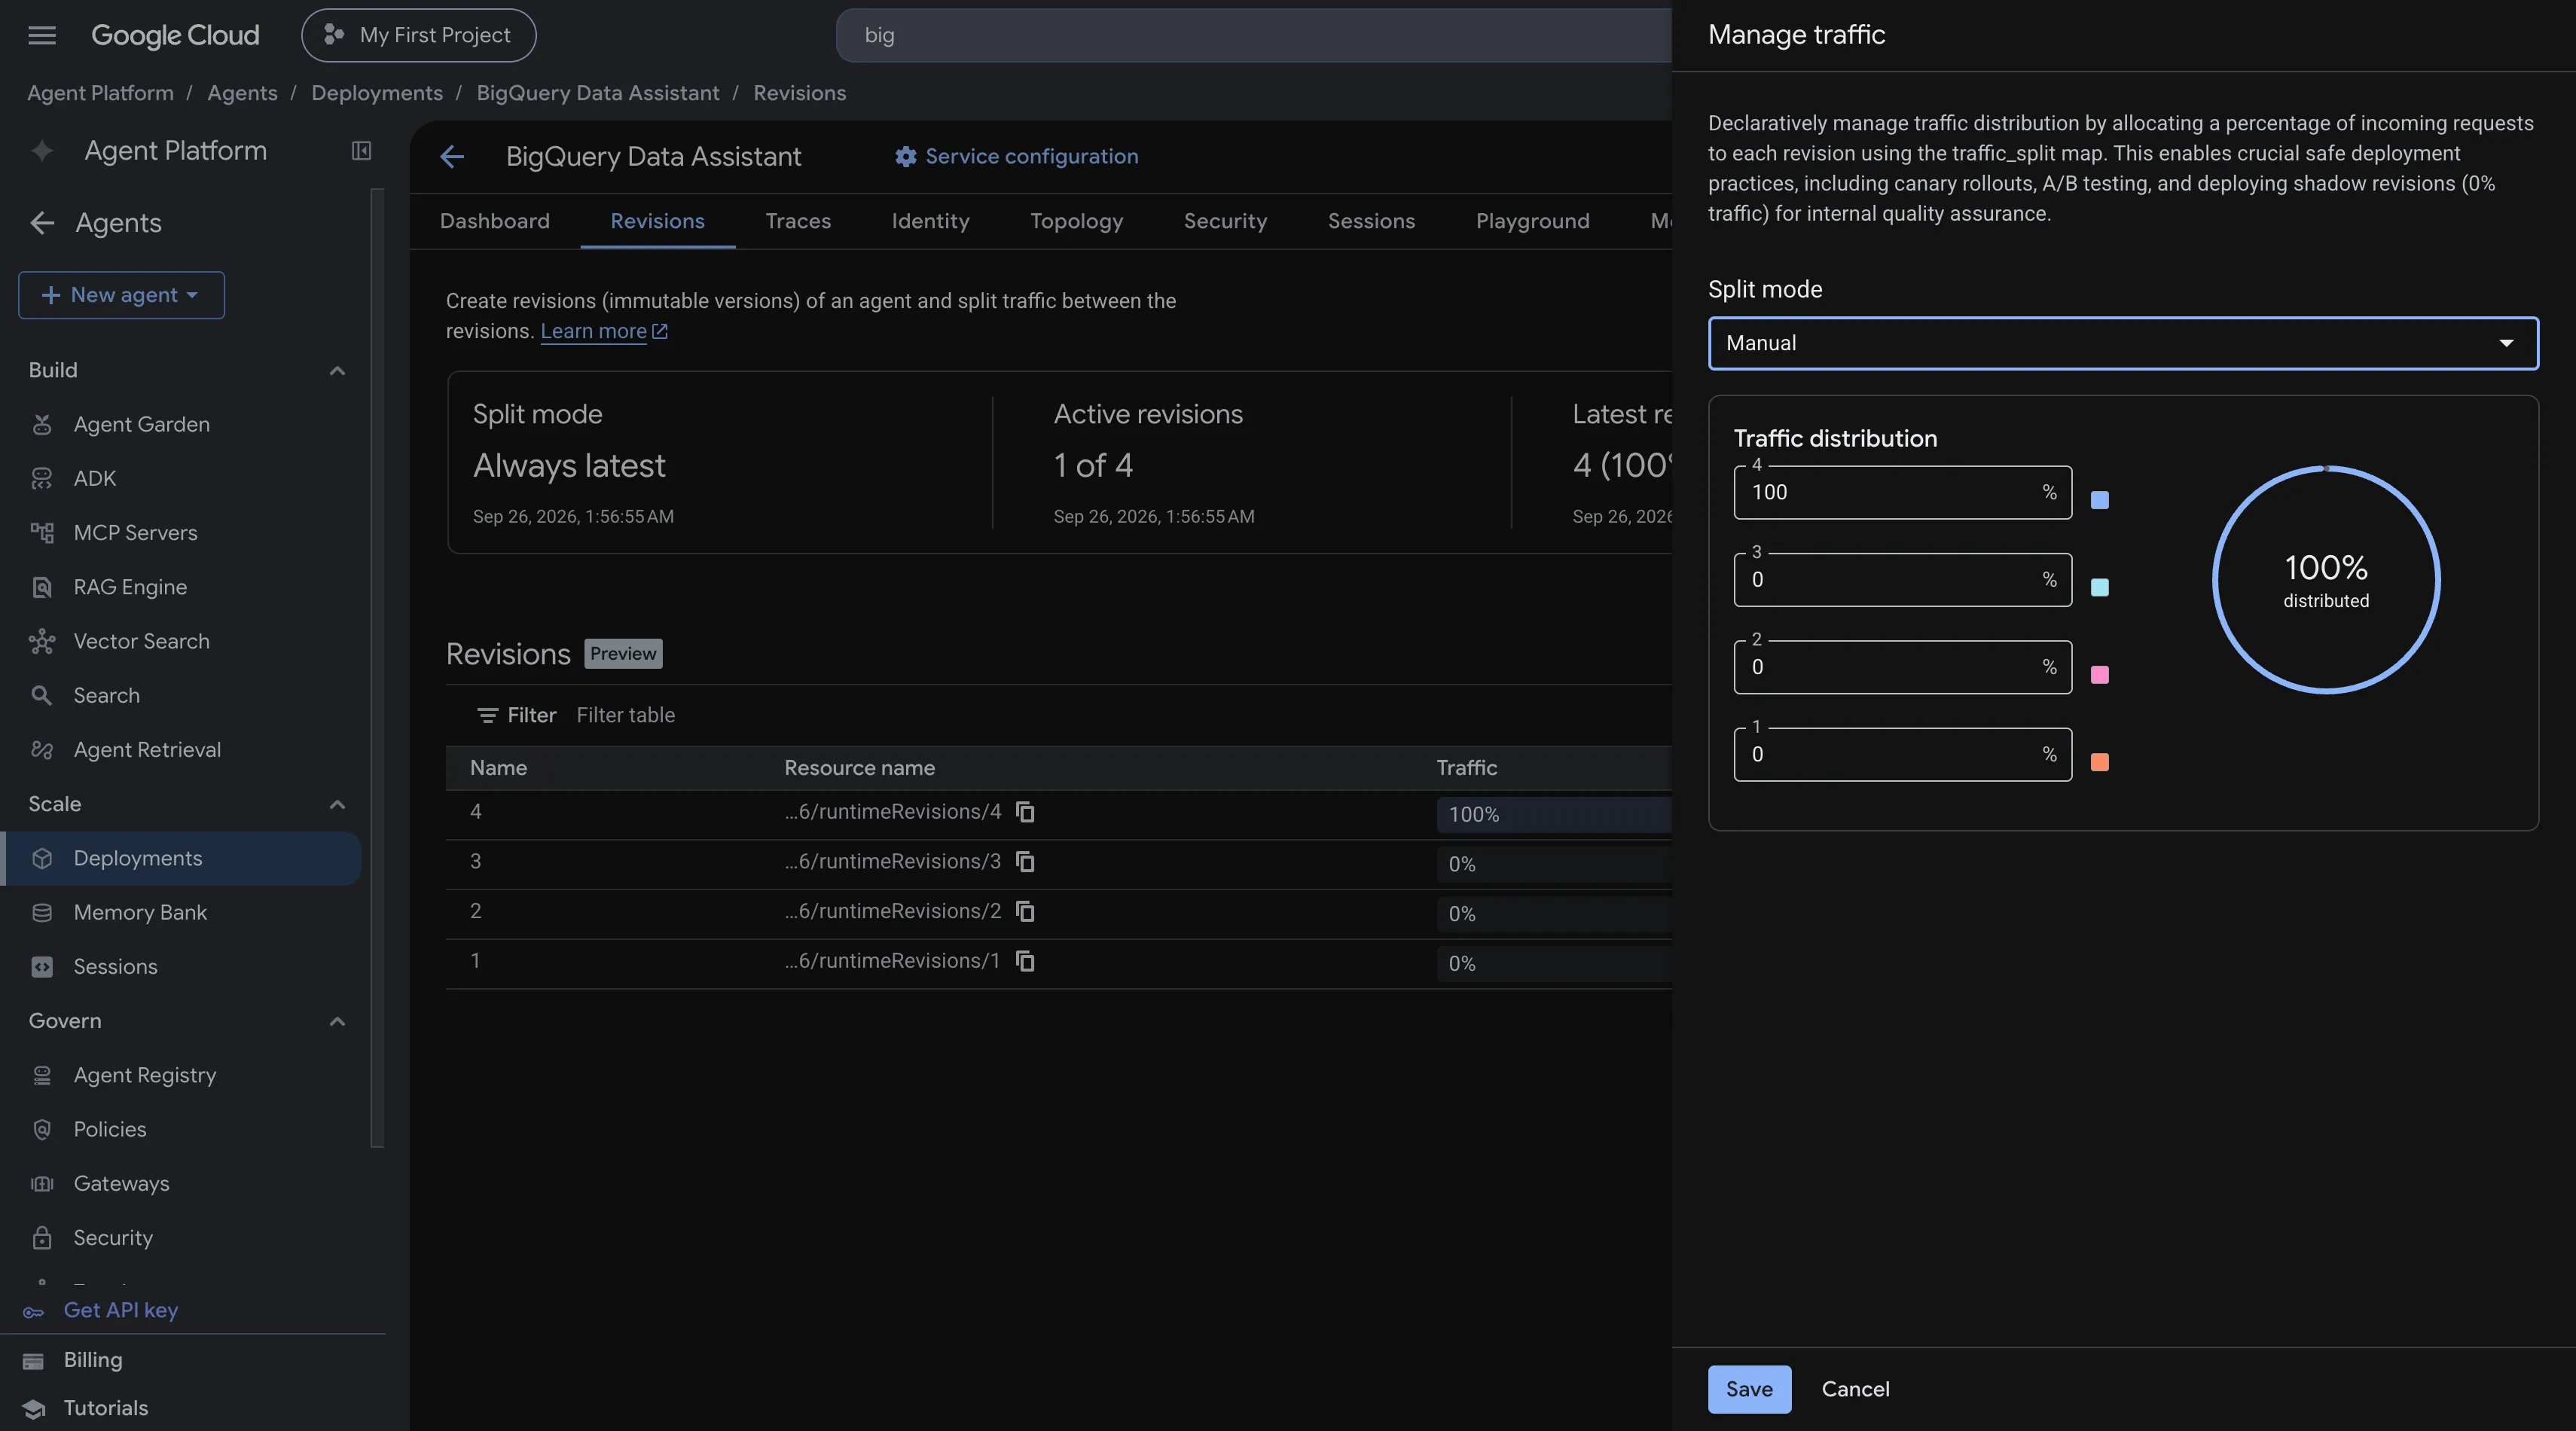
Sur la page des révisions, je peux choisir quelle révision servir après des mises à jour, et même répartir le trafic par pourcentage. Cela couvre les déploiements canari (canary rollouts) et les retours en arrière (rollbacks) rapides en production :
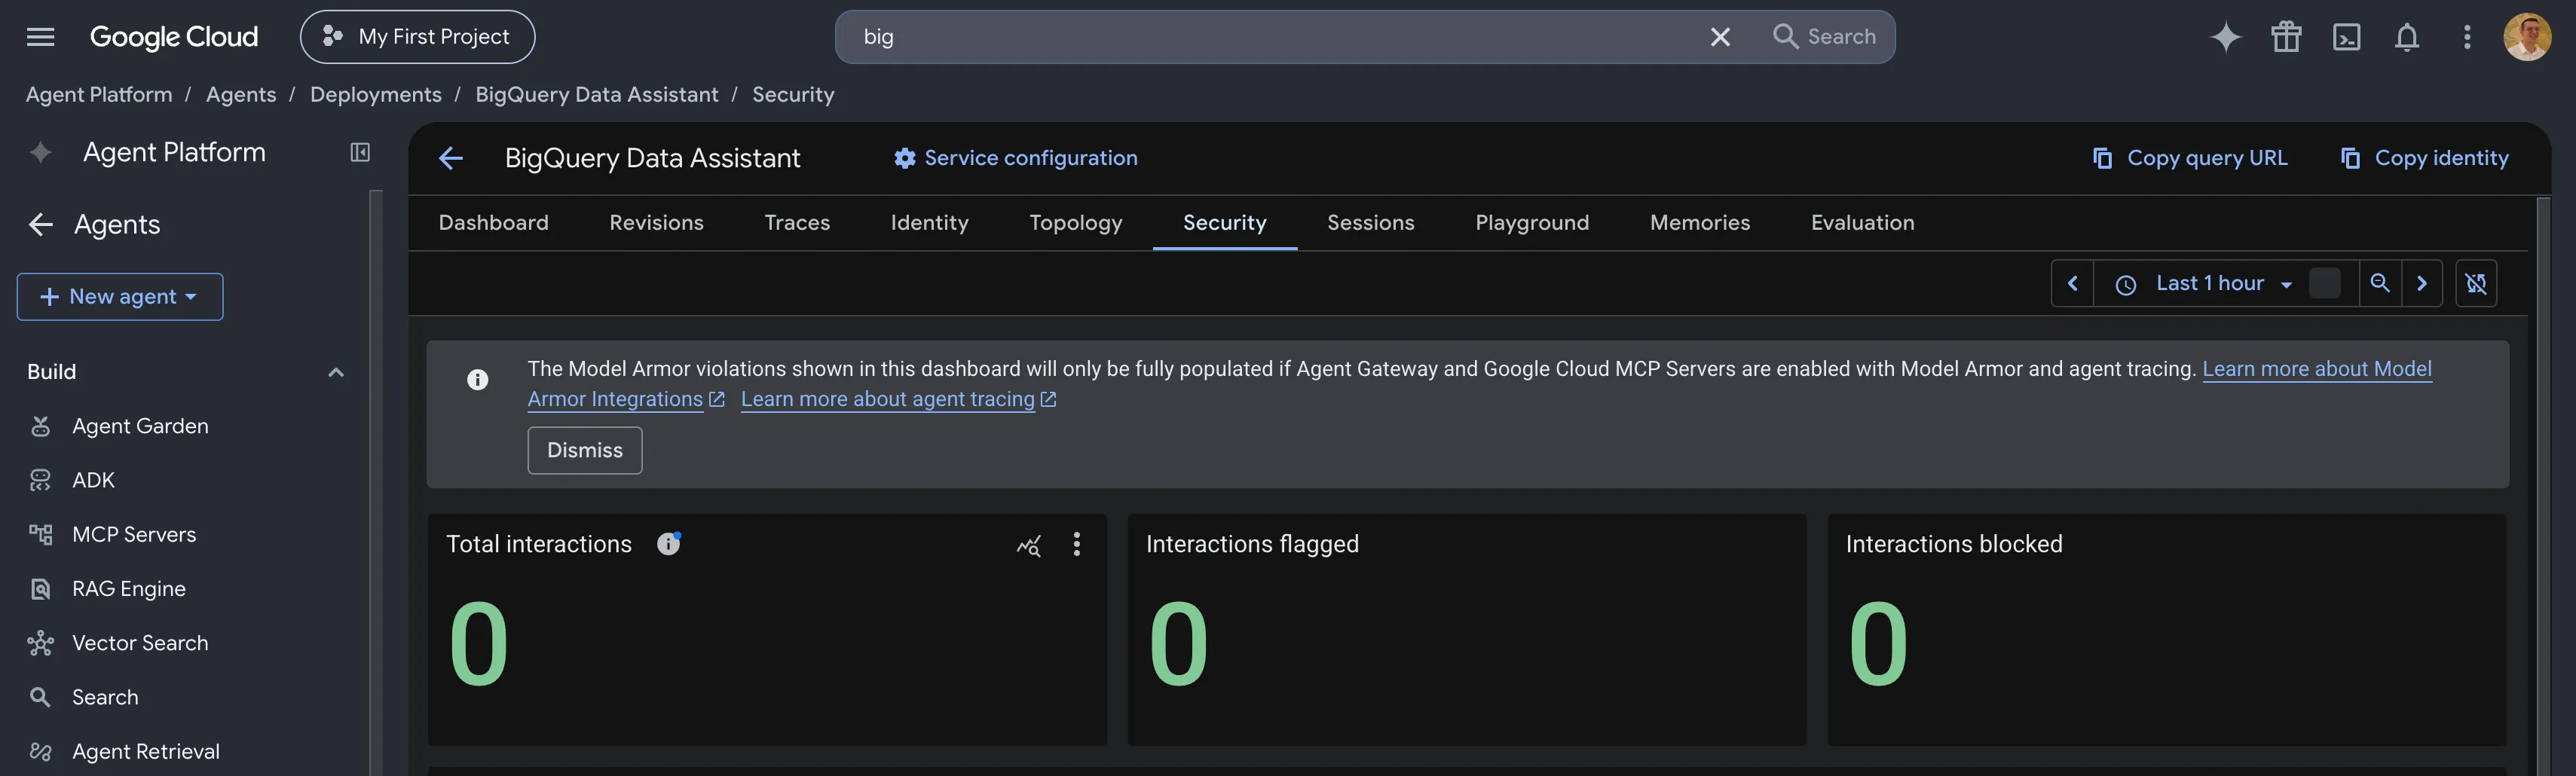
Il existe également un onglet de sécurité traçant les violations détectées dans les conversations, aligné sur les paramètres de sécurité définis dans le code ADK. J'aborderai la sécurité plus en détail dans les prochains articles :
L'onglet mémoire (Memory) est utilisé pour les banques de mémoire (memory banks), un stockage de mémoire à long terme qui permet à l'agent de retenir des informations persistées dans le temps. Il peut être utilisé pour enrichir l'agent avec des connaissances.
Sur l'onglet Playground, je peux interagir directement avec l'agent et suivre les sessions :
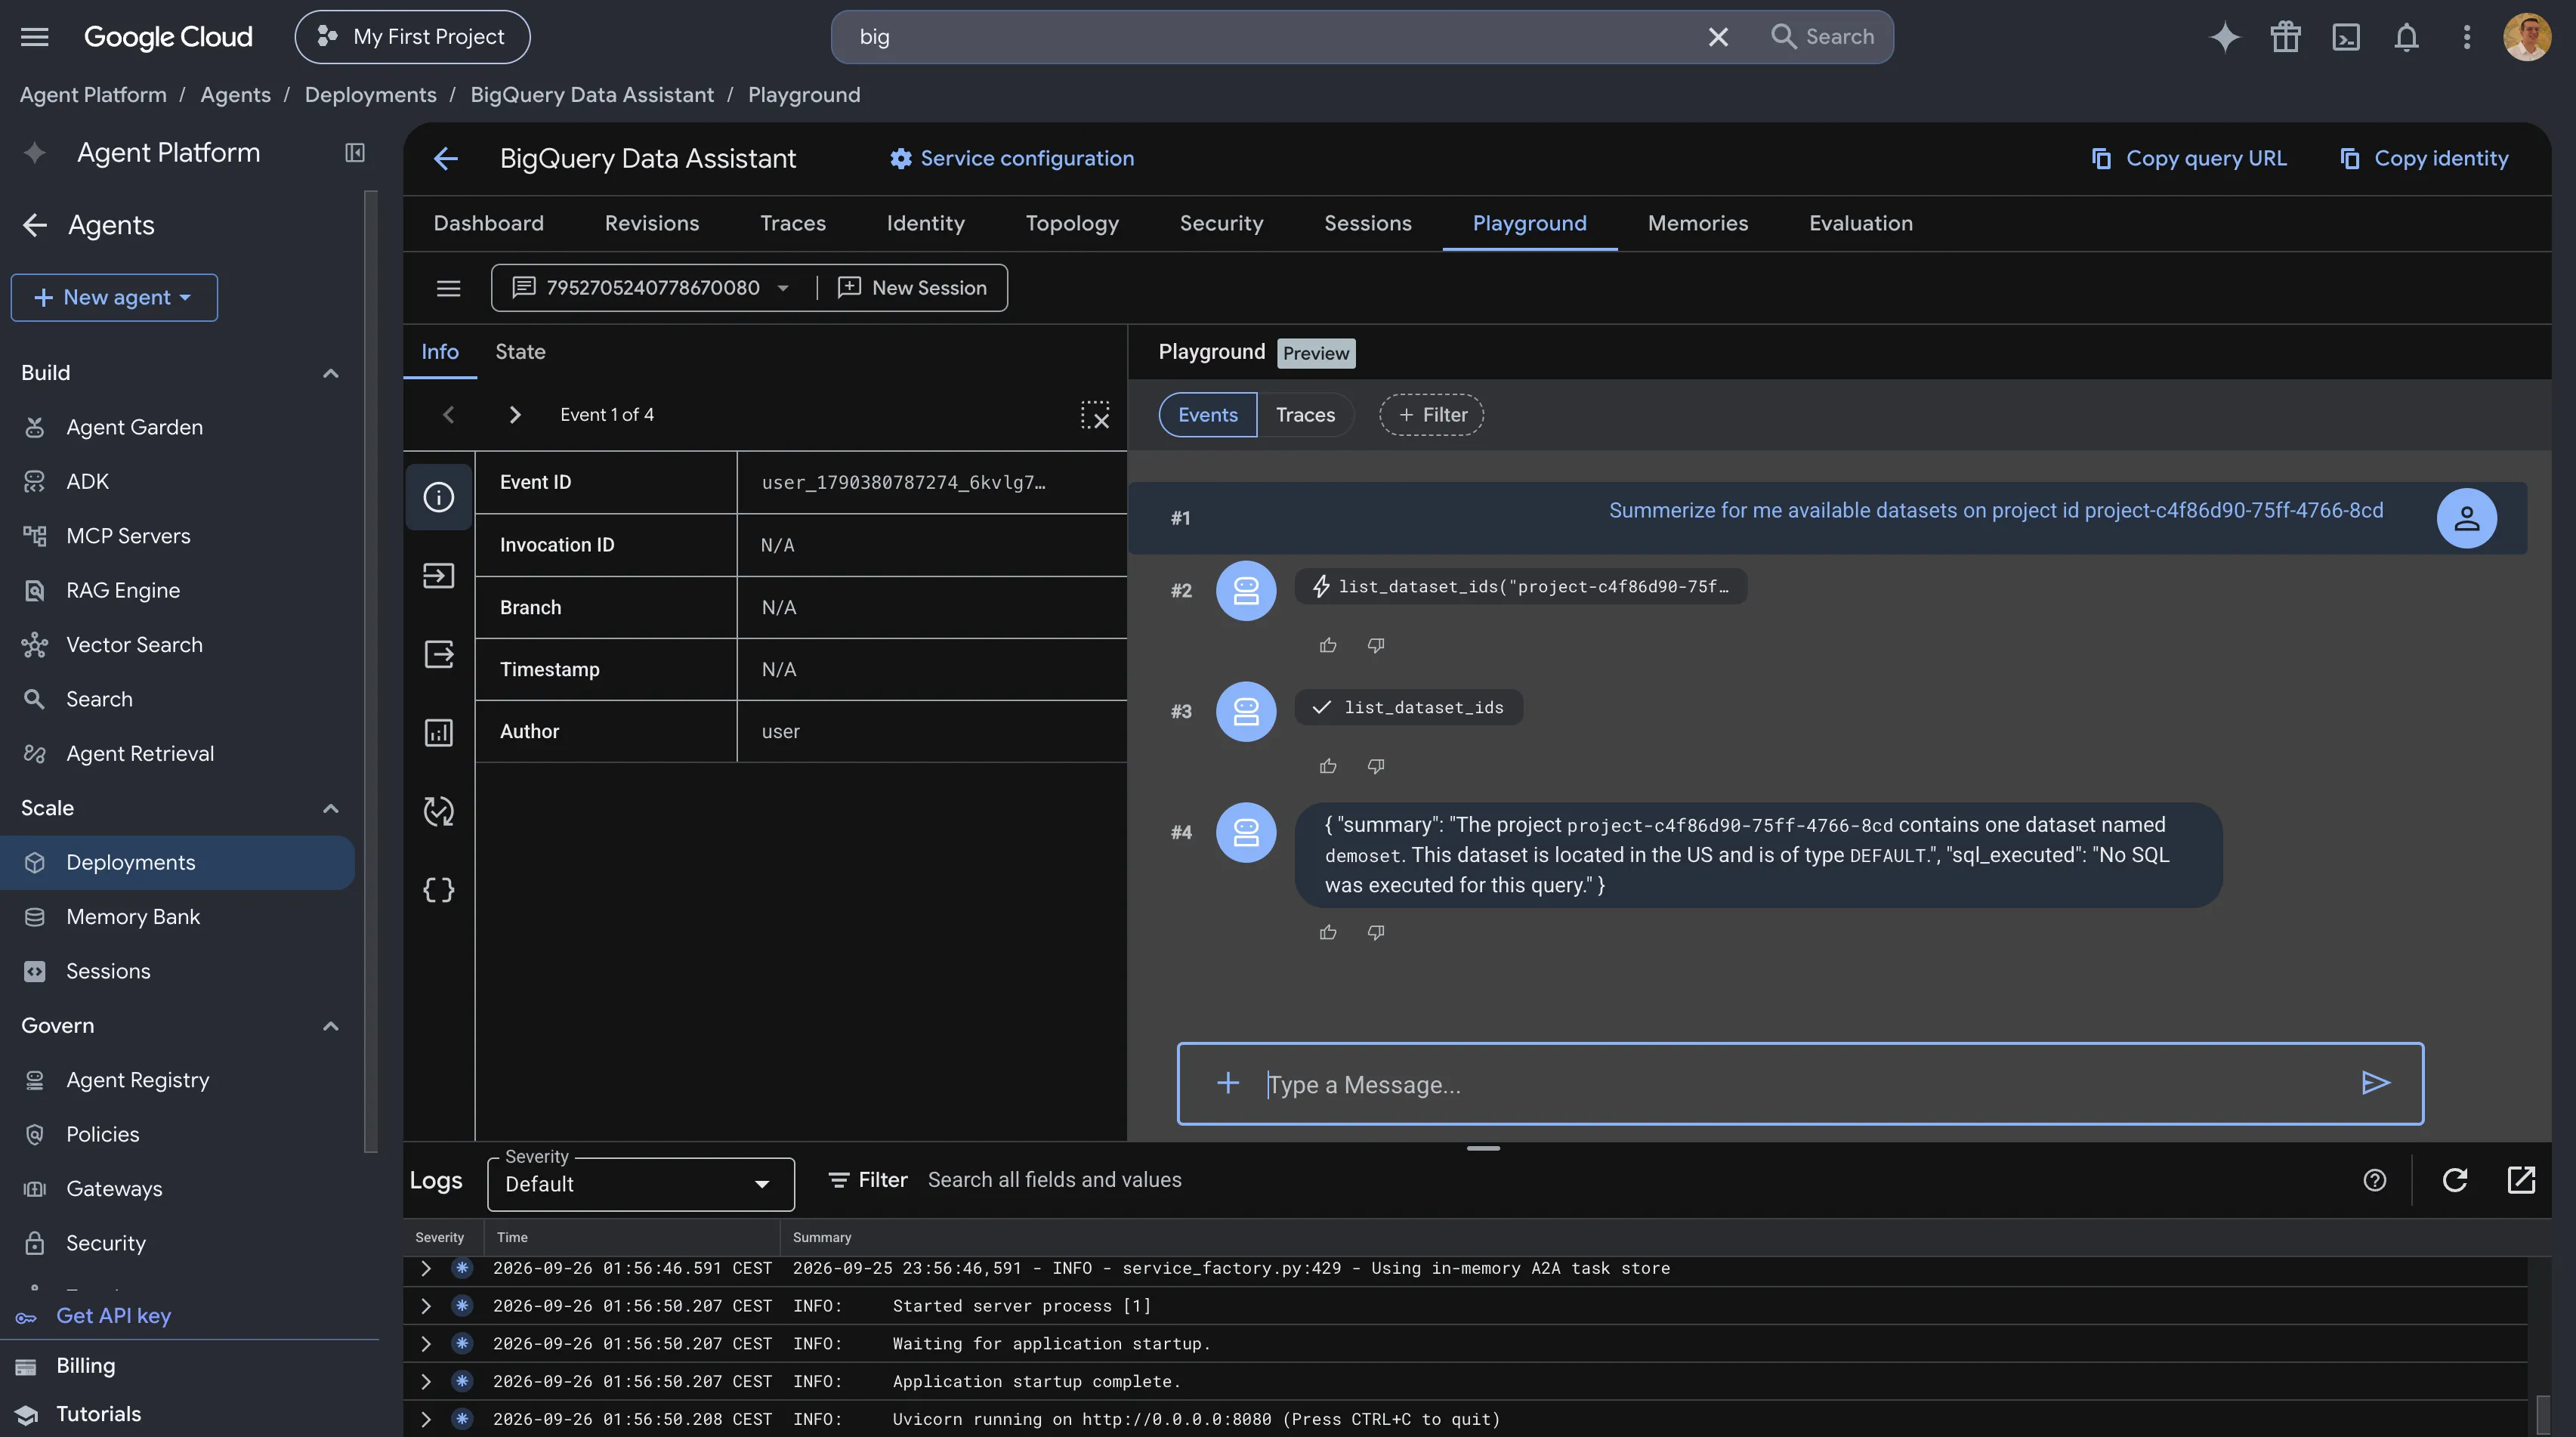
Je peux démarrer une nouvelle session ou en reprendre une ancienne pour la poursuivre, car le moteur stocke nativement les sessions et conserve l'historique des sessions précédentes :
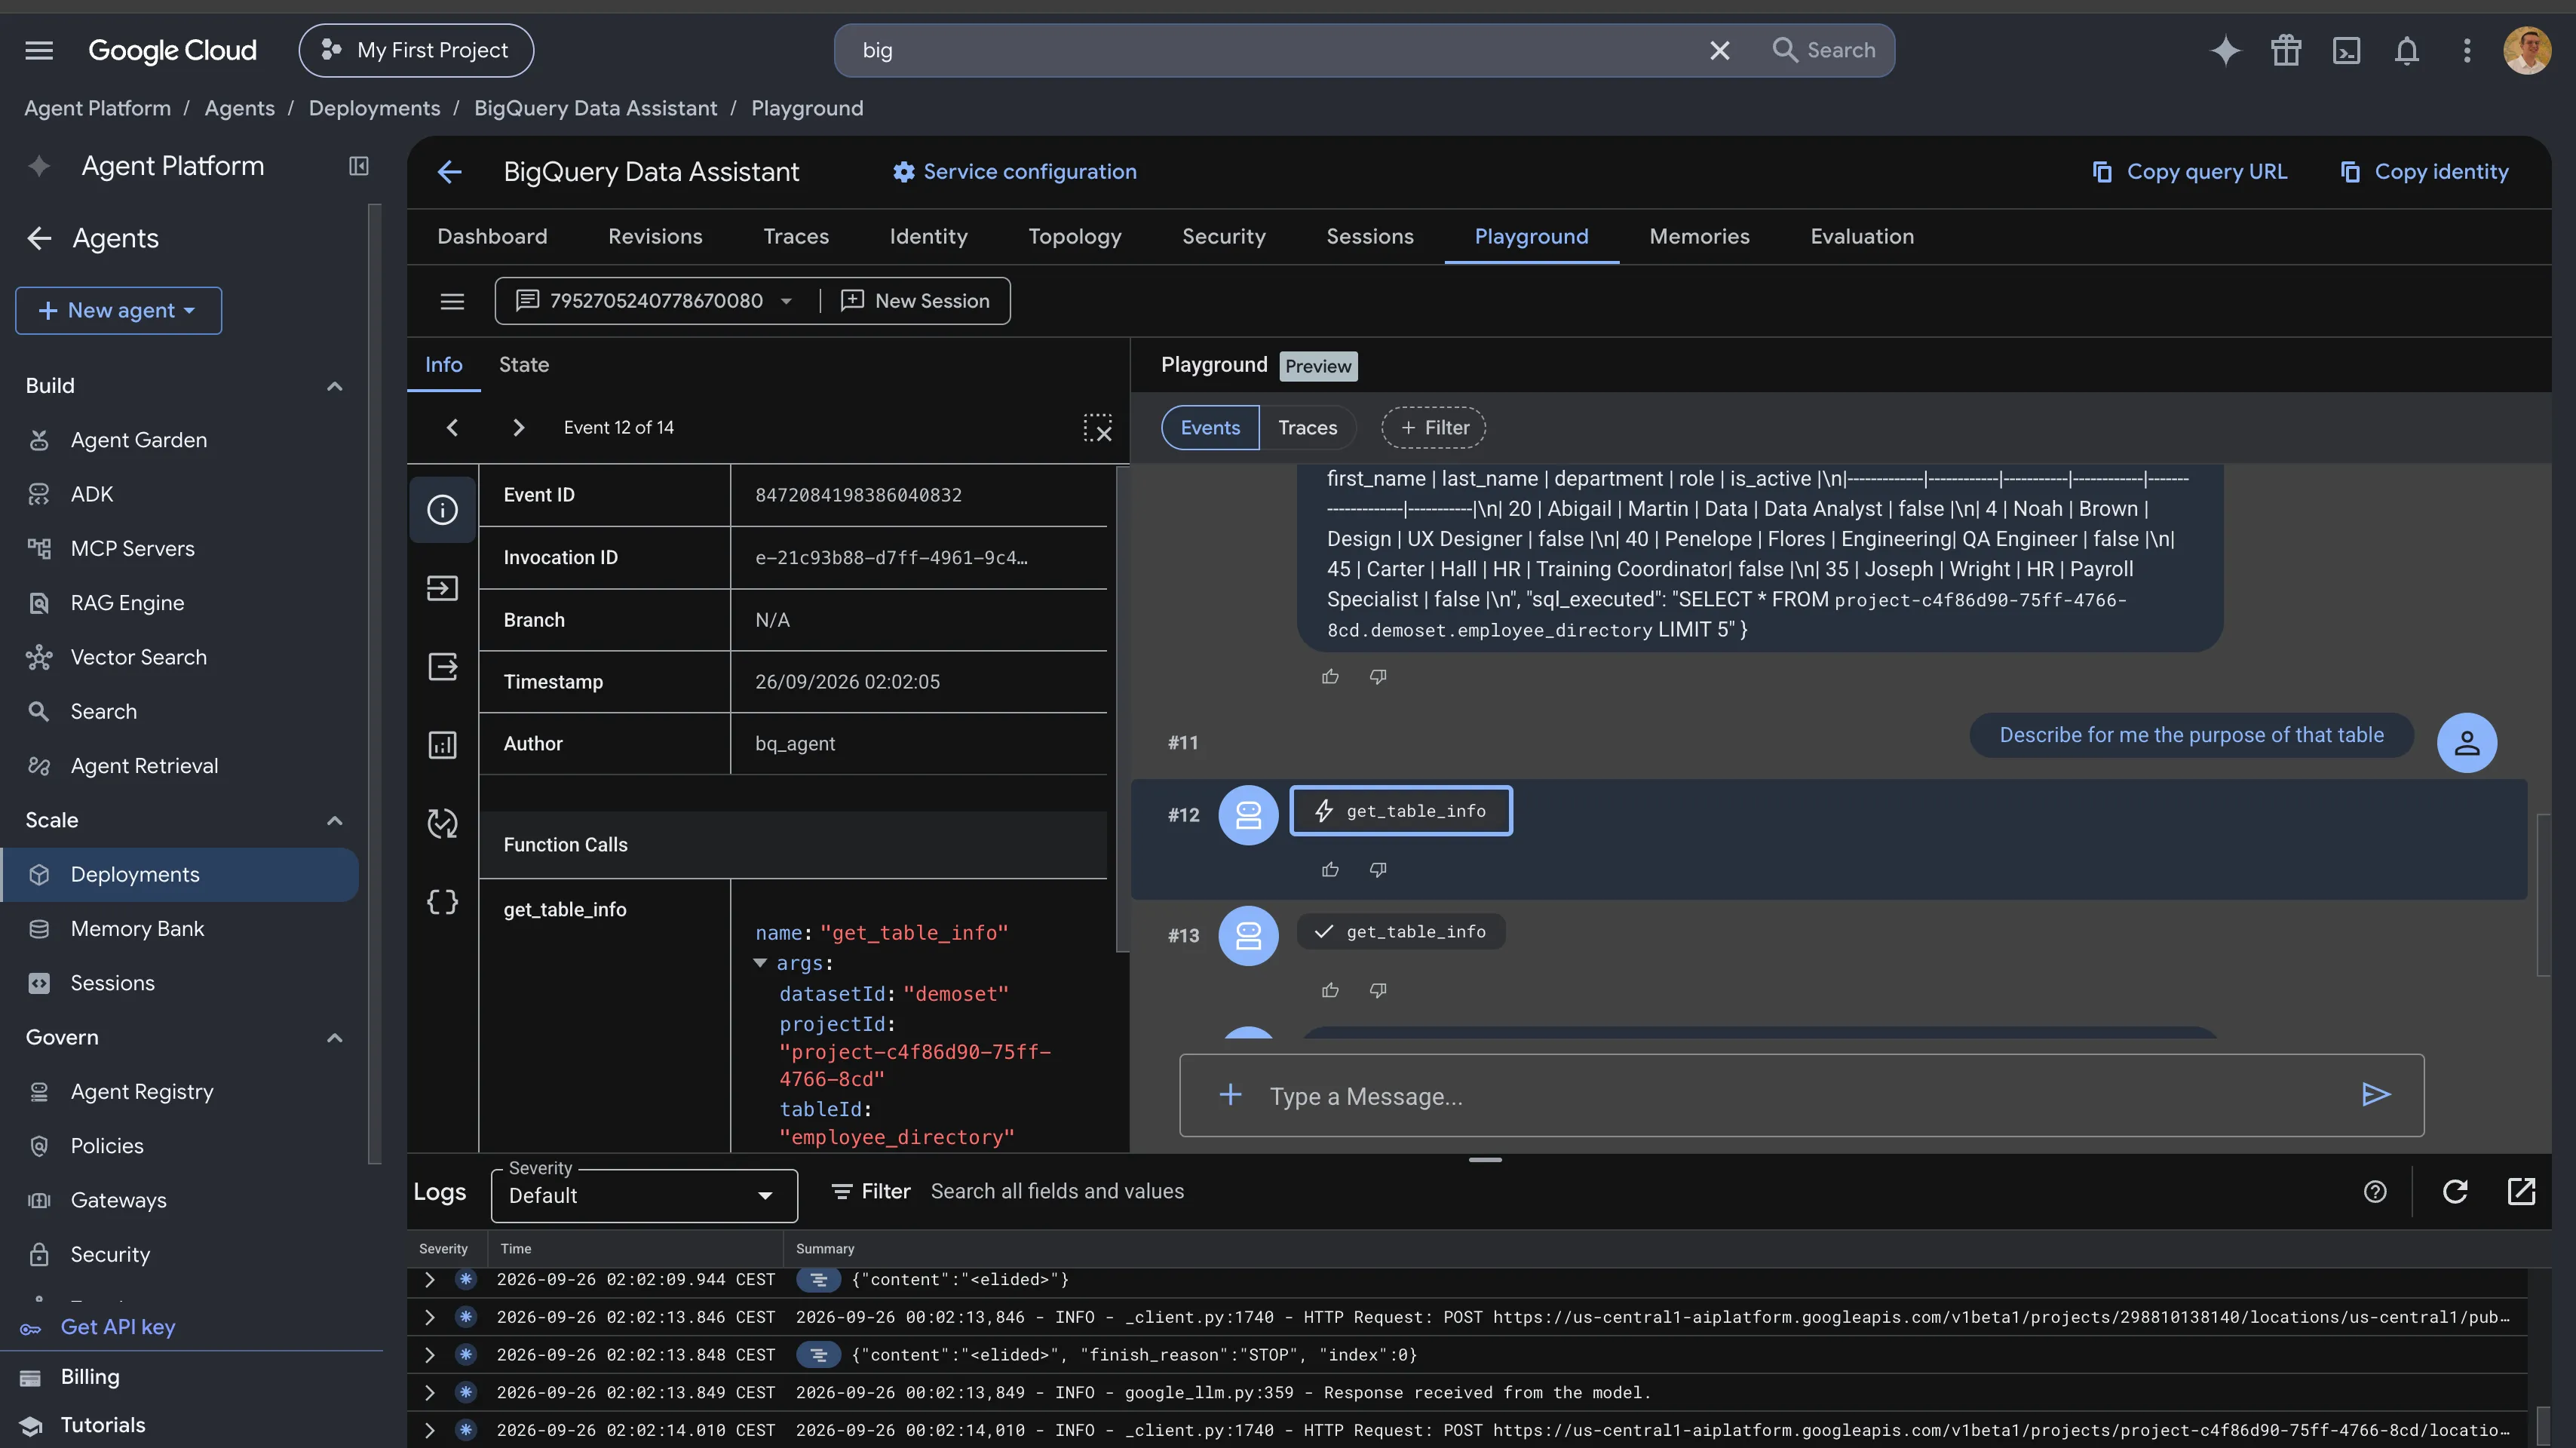
Je peux également inspecter chaque événement individuellement. Ils sont tracés avec l'entrée et la sortie de chaque outil appelé, et les messages transportent des indicateurs (flags) et des métadonnées qui guident le client consommateur sur le statut et l'affichage.
L'agent peut aussi être testé depuis la CLI ou par programmation, puisque les fonctionnalités du playground sont également exposées via l'API :
Interroger l'agent déployé
Cloud Run
Il n'y a presque aucune fonctionnalité centrée sur l'IA à décrire au sein de Cloud Run. Malgré cela, cela reste un excellent chemin de déploiement pour les piles techniques qui nécessitent une gestion de session personnalisée ou un comportement gouverné par les développeurs, ainsi que des capacités RAG. La méthode Cloud Run offre une très grande latitude de personnalisation, mais toute l'infrastructure doit être gérée par vos soins, même si agents-cli gère le service Cloud Run lui-même.
Il existe deux façons de déployer l'agent sur un backend Cloud Run. La première, sur main, est adaptée aux démarrages rapides et au développement. La seconde, sur feature/cloudrun-agent, intègre Terraform dans la boucle.
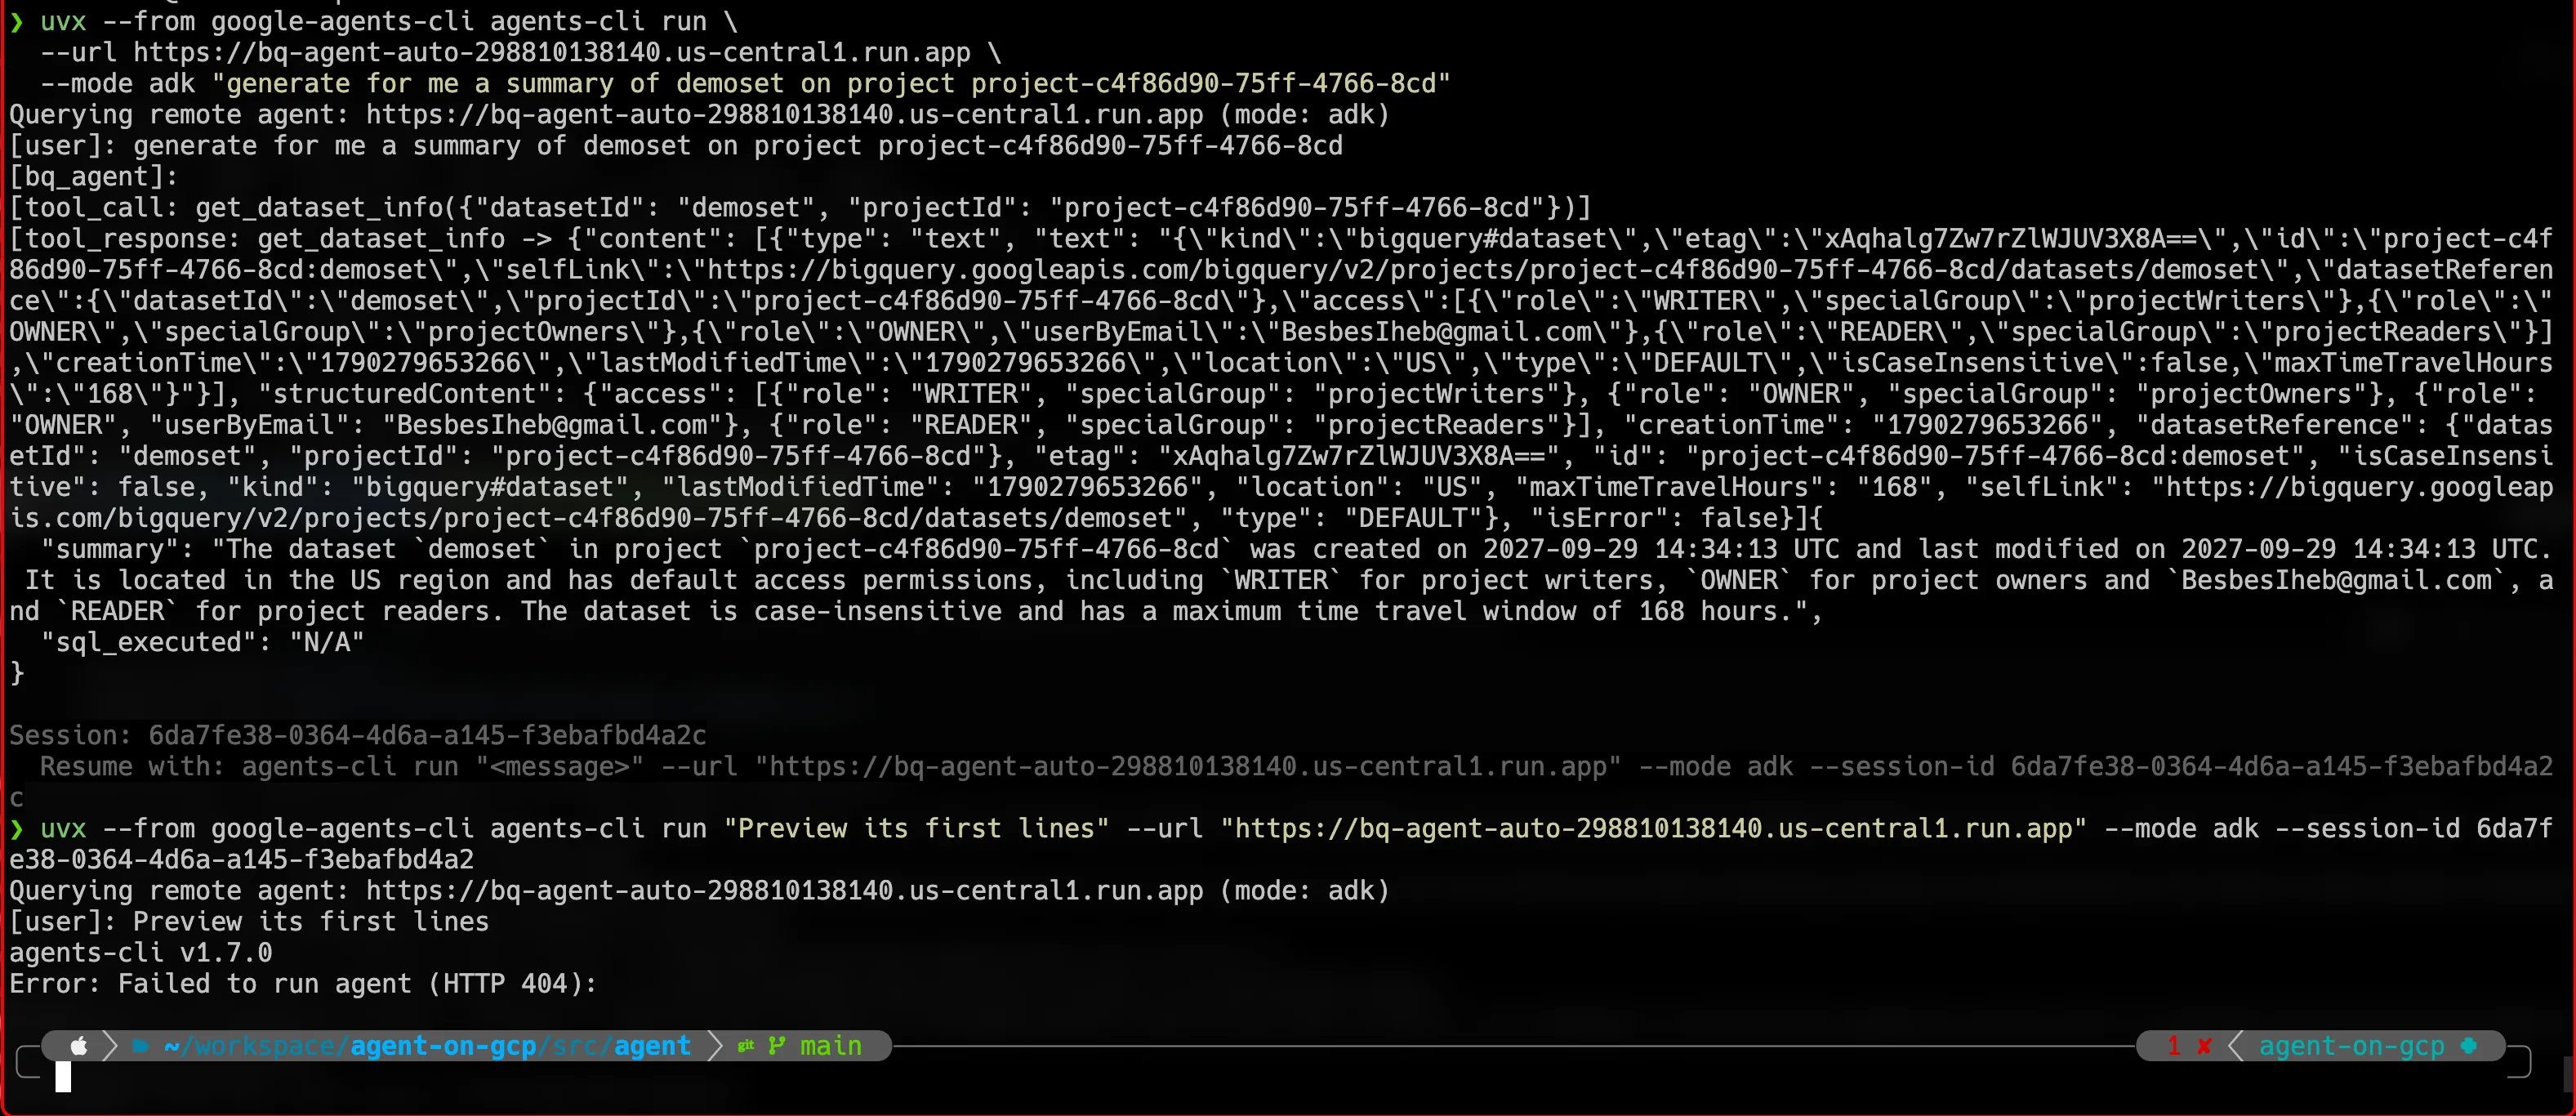
Une limitation importante : avec le backend Cloud Run, il n'y a pas de stockage de session géré dans la configuration générée par défaut. Les sessions sont générées en mémoire, ce qui signifie qu'elles durent tant que le service est actif et sont perdues dès qu'il réduit sa capacité à zéro (scale down). Vous pouvez fixer le nombre minimum d'instances à 1 pour toujours conserver les sessions, ou introduire une solution de session auto-gérée. Les paramètres de génération et de déploiement comme la mémoire de session peuvent être ajustés dans le fichier agents-cli-manifest.yaml généré.
Déploiement
Sur main, le script dédié deploy_auto_cloudrun.sh provisionne le compte de service s'il n'existe pas, nettoie le scaffold précédent, génère le nouveau scaffold, applique le patch et déploie :
Déployer Cloud Run via le script
La création du scaffold ressemble à celle d'Agent Engine, seule la cible change et le reste demeure identique :
Générer le scaffold pour Cloud Run
La commande de déploiement n'est pas très différente non plus. La télémétrie n'est pas activée ici : elle peut l'être, mais nécessite des développements supplémentaires pour surveiller et suivre correctement les métriques.
Déployer sur Cloud Run
Le nom du service est déclaré en lecture seule (readonly) volontairement. Sur le backend Cloud Run, agents-cli n'utilise pas de fichier d'état et n'en a pas besoin : il suit le service Cloud Run par son nom et y provisionne de nouvelles révisions. Garder ce nom stable est ce qui permet à un redéploiement d'effectuer une mise à jour plutôt qu'un doublon. Si le script de déploiement est relancé, il réutilise le service qu'il trouve sous la valeur --service-name.
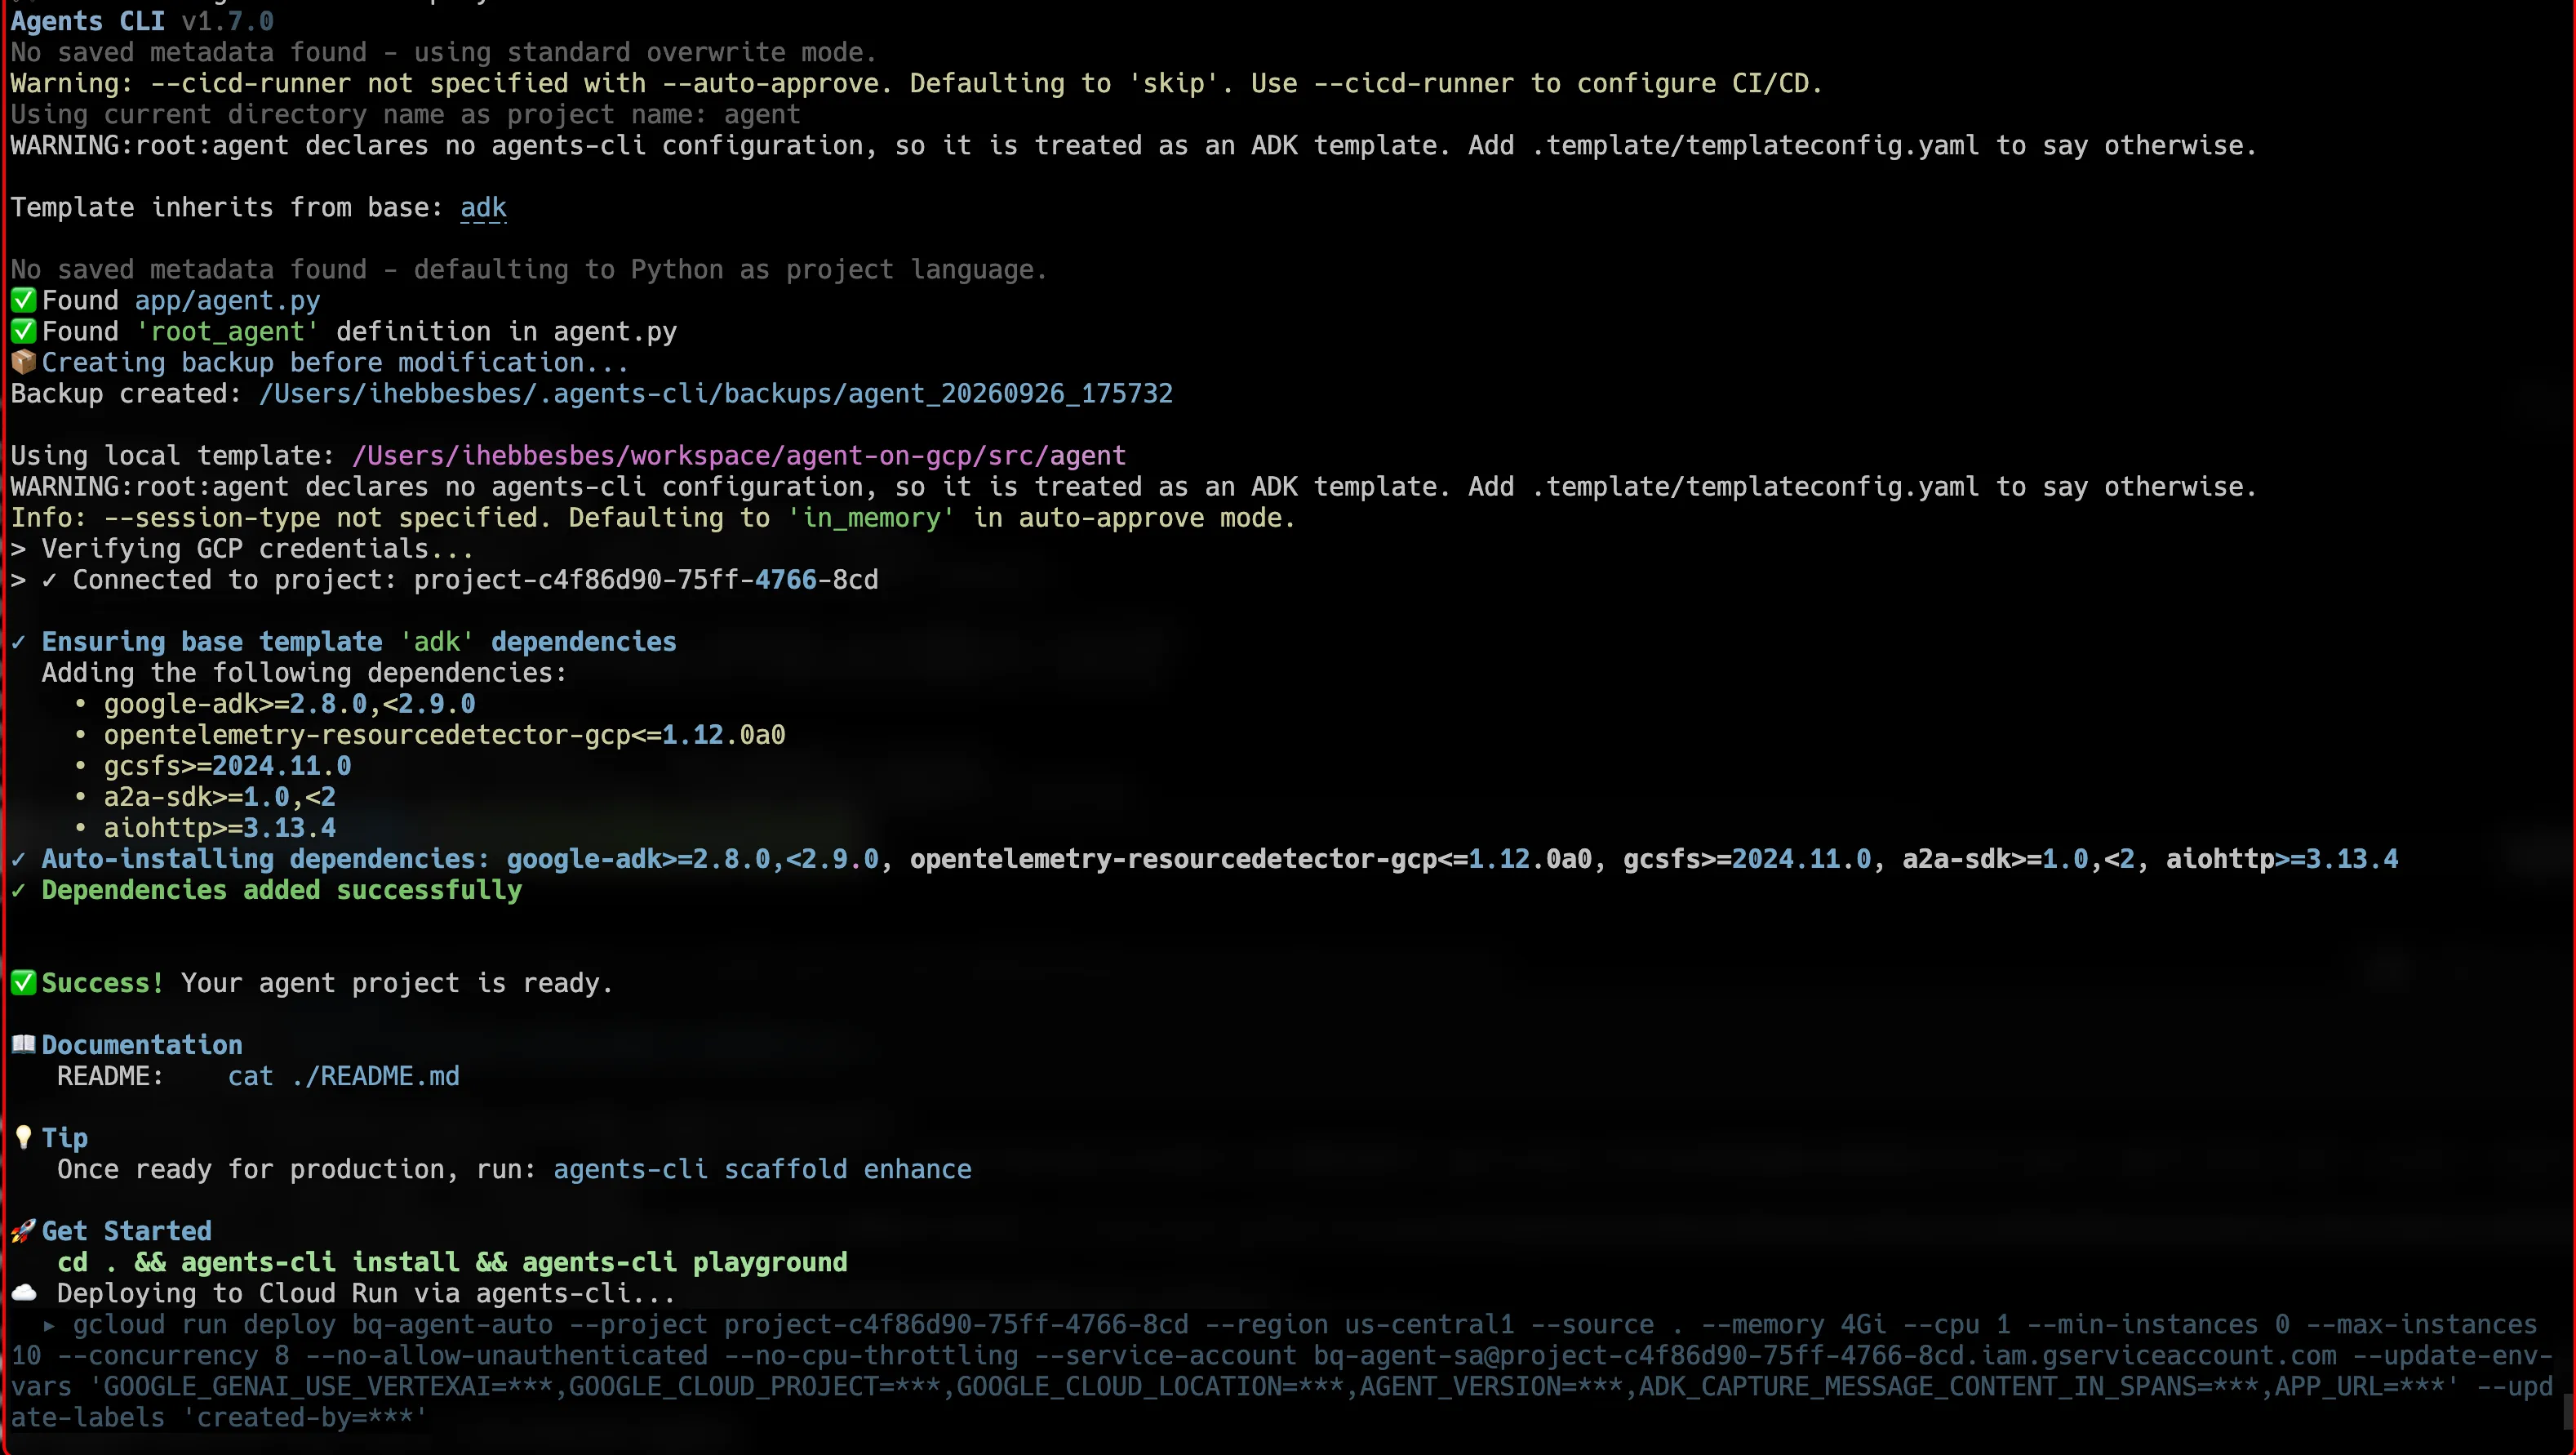
La branche feature/cloudrun-agent reprend le même principe avec Terraform comme base d'infrastructure. Le script deploy.sh est presque identique, sauf qu'il appelle Terraform au lieu du script IAM pour provisionner le compte de service et l'infrastructure Cloud Run cible, puis nettoie le scaffold, régénère et déploie. La configuration Terraform se trouve dans terraform/ et est découpée en trois modules : iam pour le compte de service, cloudrun pour le service privé, et scheduler pour un job Cloud Scheduler qui invoque l'agent quotidiennement via OIDC. Terraform provisionne l'infrastructure, et agents-cli prend en charge la construction du conteneur et la mise à jour du service :
Tests
Avec le scaffold par défaut, agents-cli embarque un playground API avec l'agent pour tester son comportement pendant la phase de développement. Il est également disponible en mode A2A et d'autres protocoles. Après un déploiement réussi, agents-cli affiche des commandes utiles pour les tests, y compris l'option permettant de créer un proxy et d'exposer une API afin que d'autres agents puissent le joindre :
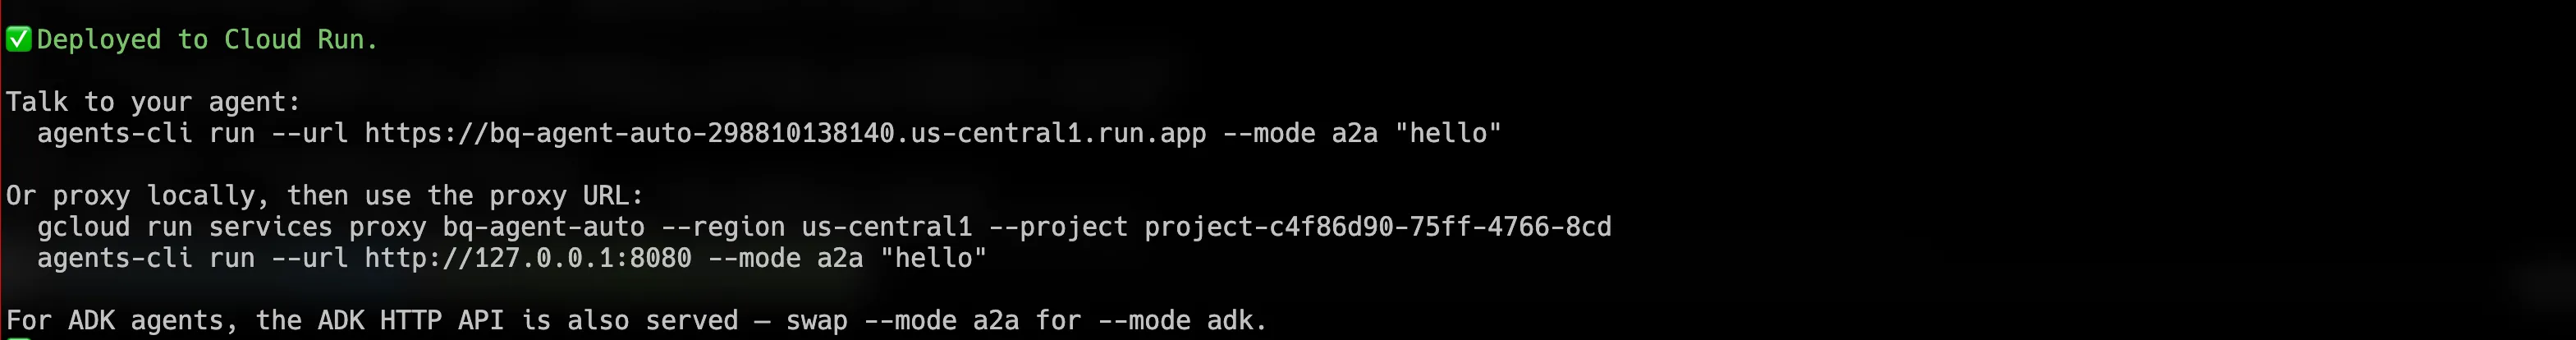
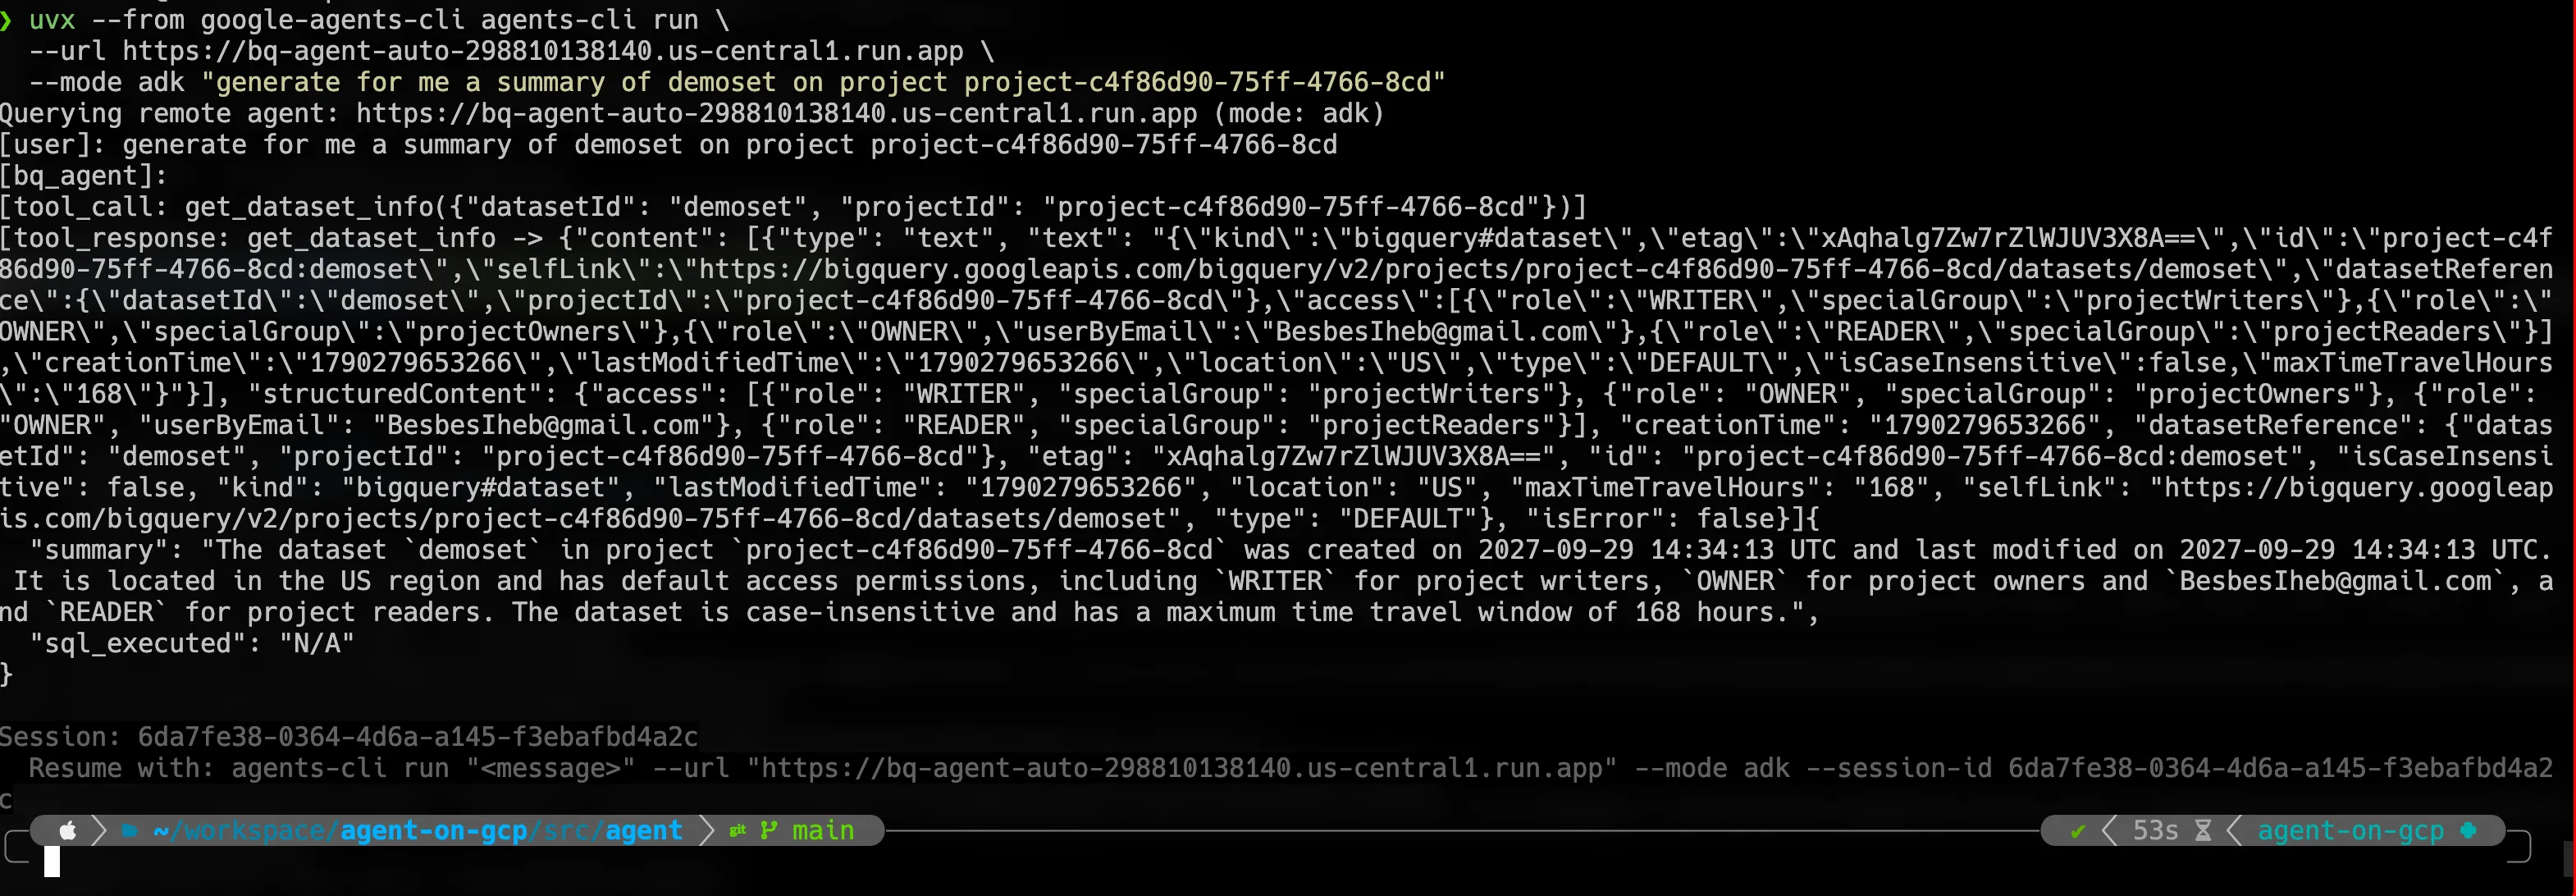
Pour contacter directement l'agent déployé, j'ai utilisé la commande suivante :
Exécuter une requête sur le service Cloud Run
Lorsque tout est configuré correctement, l'agent répond et peut maintenir une conversation en itérant sur les entrées :
Cependant, dès que le service réduit son nombre d'instances à zéro (scale down), la conversation est introuvable, car l'historique était stocké dans une session en mémoire :
Conclusion
Pour les équipes qui déploient déjà des services sur Cloud Run, ADK s'intègre très bien : les entrées et sorties de l'agent restent gérées et personnalisables, comme vu dans l'article précédent, et la version Cloud Run offre portabilité, forte personnalisation et gouvernance complète sur l'infrastructure. Si aucun de ces points ne s'applique, privilégiez Agent Engine. Il regorge d'options gérées et offre un très bon cycle de développement.
Sur le dépôt, les deux branches disposent de scripts compatibles CI qui automatisent le déploiement de chaque version présentée.
Toutes les versions peuvent être publiées sur Gemini Enterprise. La version Cloud Run se connecte via A2A, tandis que la version Agent Engine utilise une communication directe. J'approfondirai ce sujet dans les prochains articles.